この記事でわかること
- GPT-6.1 Solの特徴と料金
- Claude Opus 5.5との違いと使い分け
- 同じお題で作らせたゲームの実例
- Codexで使うときのeffortの選び方
「僕が実際にGPT-6.1 Solでゲームを11本作らせたら、起動しなかったのは0本でした」
OpenAIからGPT-6.1 Solがリリースされました。前のGPT-6 Solからわずか1週間での更新ですが、料金はほぼそのままで中身が大きく変わっています。Claude Opus 5.5に近いものを、1タスクあたり約8分の1の費用で作ってくれるのが一番のポイントです。
こんにちは、ルーティンラボ(@rutinelabo)です。本記事では、GPT-6.1 Solの料金・ベンチマーク・使える場所を整理したうえで、Opus 5.5や前のGPT-6 Solと同じお題で作らせた結果と、Codexで使うときの注意点をまとめます。
プロンプト配布中
LINE公式アカウントを友達追加していただければ、本記事やYouTubeで使用した使用したプロンプトを配布いたします。メンバーシップ登録で優先サポートも実施中です。
GPT-6.1 Solとは|Opus 5.5に迫る性能を約8分の1の費用で
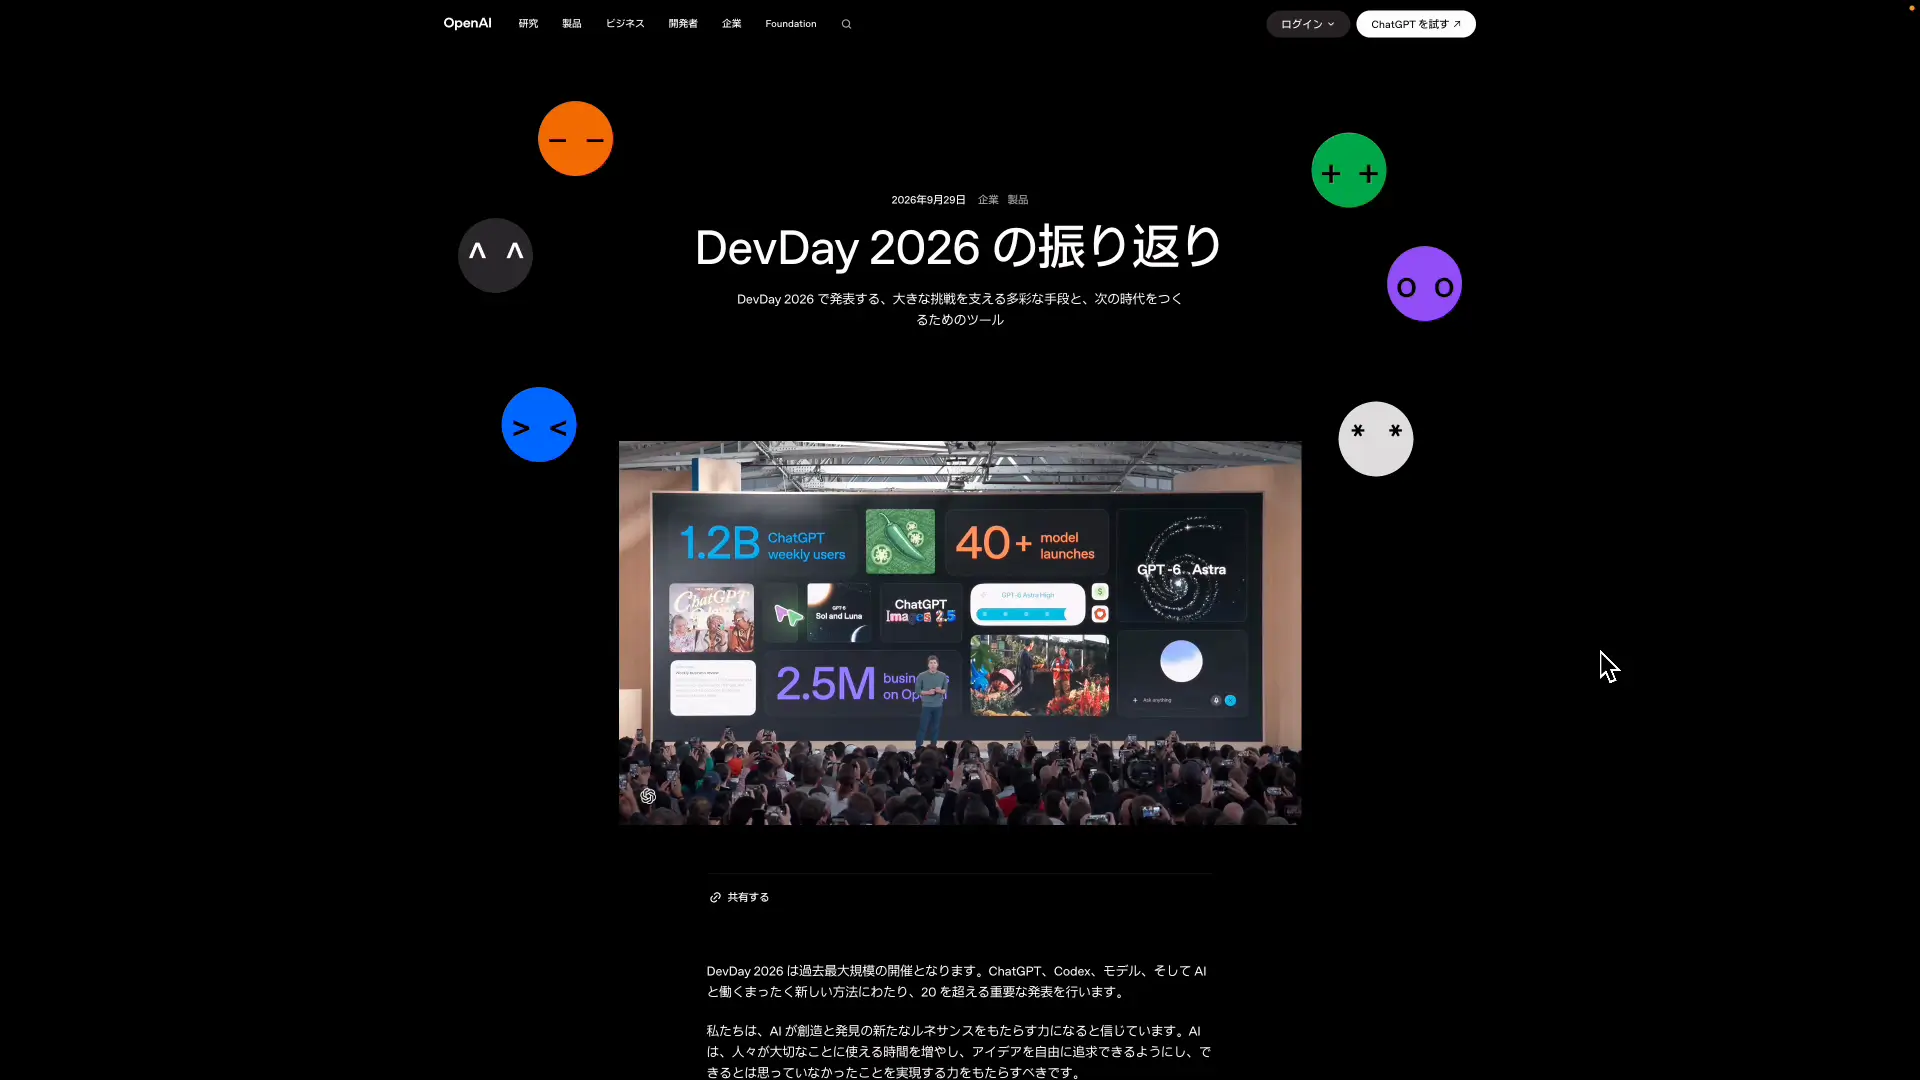
GPT-6.1 Solは、2026年9月29日に開かれたOpenAIの開発者向けイベント「DevDay 2026」で発表されたモデルです。同じイベントでは、24時間動き続けるエージェント「ChatGPT Dots」や新しい料金プランも発表されていて、その中でも特に注目を集めたのがこのGPT-6.1 Solでした。
GPT-6のモデルは、賢い順にAstra・Sol・Lunaの3段構成です。以前のGPT-5.6では、SolとLunaの間にTerraというモデルもありました。今回6.1になったのはSolだけで、AstraとLunaはGPT-6のままです。
| モデル | 位置づけ | 世代 |
|---|---|---|
| GPT-6 Astra | 最上位(いちばん賢い・いちばん高い) | GPT-6 |
| GPT-6.1 Sol | 中位(今回の更新) | GPT-6.1 |
| GPT-6 Luna | 軽量(安くて速い) | GPT-6 |
出典:Introducing GPT-6.1 Sol(OpenAI)(2026年10月時点・公式参照)
僕自身も触ってみて、Opus 5.5にかなり近い感触がありました。実際に、ホームディレクトリのCLAUDE.mdやAGENTS.mdで作業を割り振るときにも、さっそく取り入れています。一番の魅力はやはりコスパで、たくさん作業させたい人ほど恩恵が大きいモデルです。上位のGPT-6 Astraについては、GPT-6 Astraを実機検証|11課題を投げて分かった実力とClaudeとの差で詳しく検証しています。
-
-
GPT-6 Astraを実機検証|11課題を投げて分かった実力とClaudeとの差
続きを見る
GPT-6 Solから何が変わった?|料金据え置きでキャッシュ入力は半額
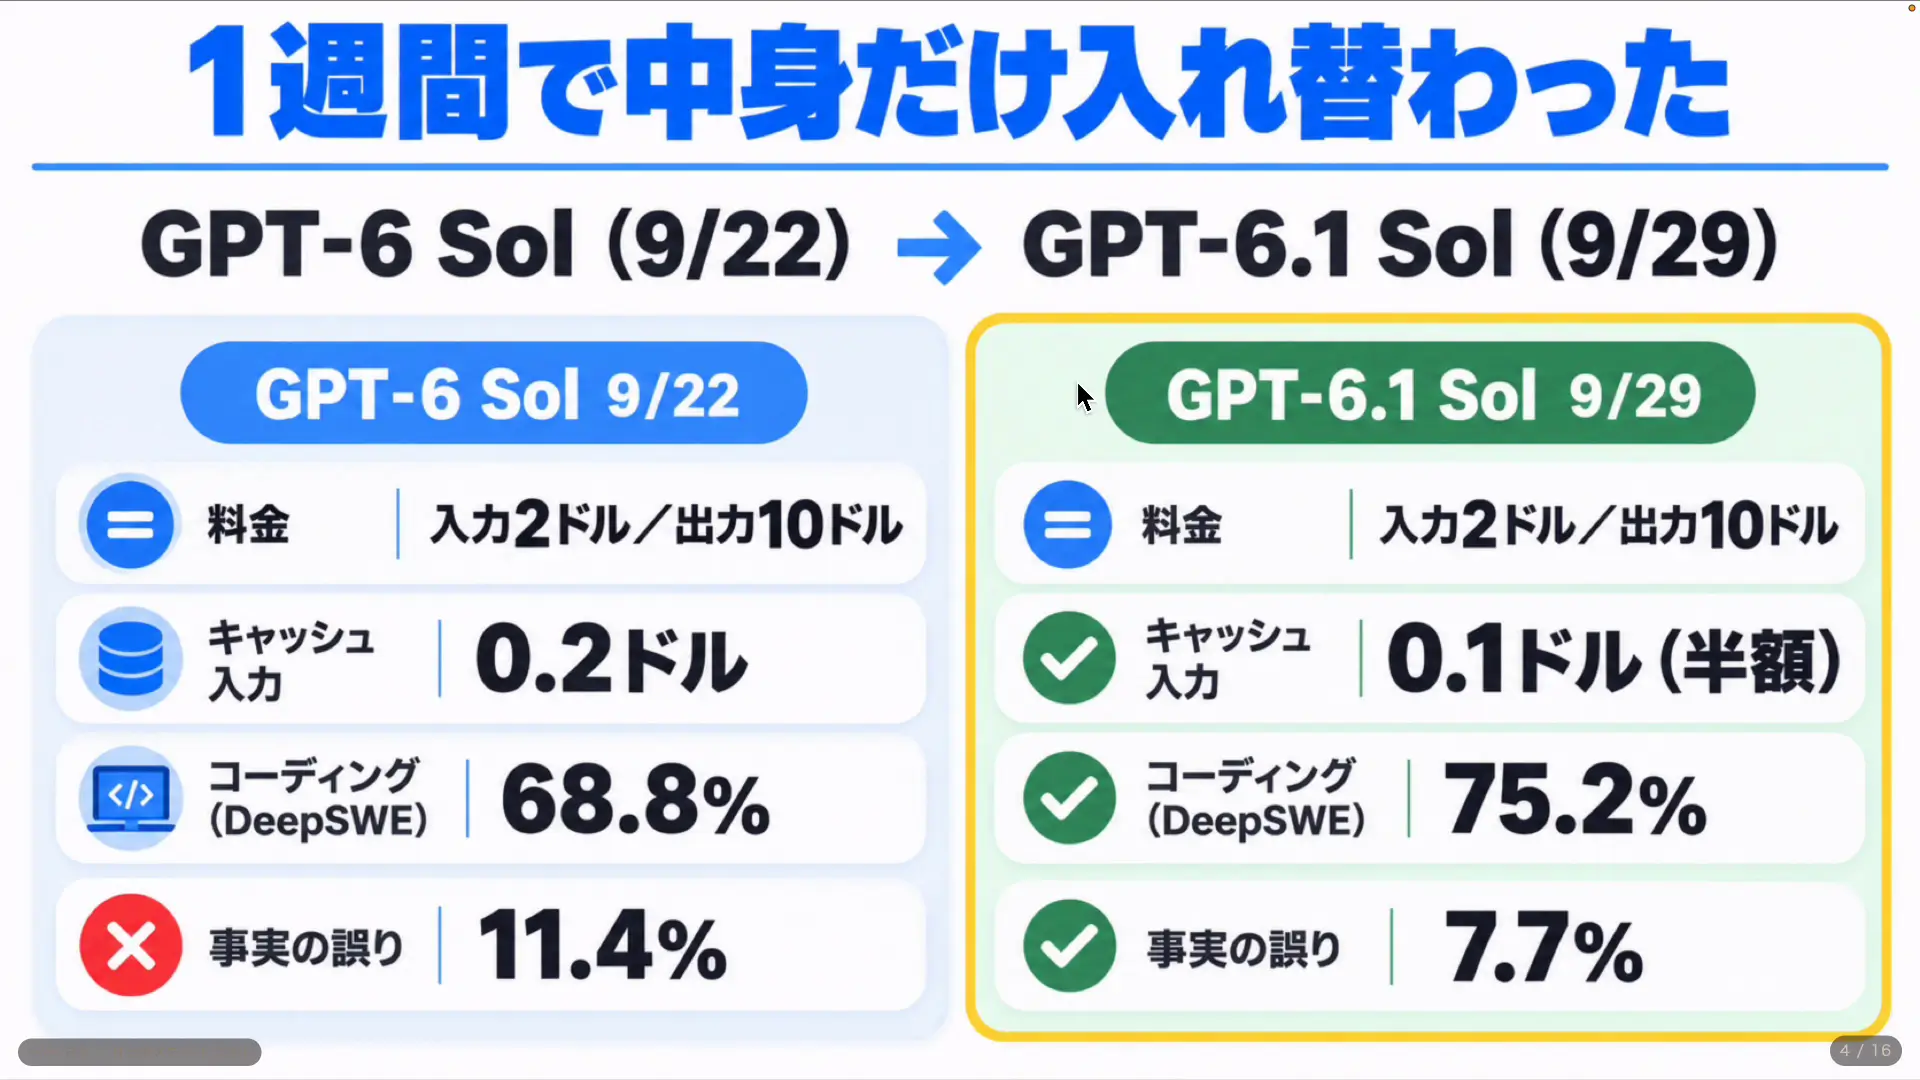
前のGPT-6 Solとの違いを表にまとめました。100万トークンあたりの料金は入力2ドル・出力10ドルで据え置きです。変わったのは、同じデータを繰り返し読み込むときに使われる「キャッシュ入力」の料金で、0.2ドルから0.1ドルへ半額になりました。
| 項目 | GPT-6 Sol(9月22日) | GPT-6.1 Sol(9月29日) |
|---|---|---|
| 料金(入力 / 出力・100万トークン) | 2ドル / 10ドル | 2ドル / 10ドル(同じ) |
| キャッシュ入力 | 0.2ドル | 0.1ドル(半額) |
| コーディング(DeepSWE v1.1) | 68.8% | 75.2%(Astraは74.1%) |
| 事実の誤り率 | 11.4% | 7.7% |
| コンテキスト / 最大出力 | — | 105万 / 12.8万トークン |
出典:GPT-6.1 Sol(OpenAI API Docs)・GPT-6 Sol(OpenAI API Docs)・Introducing GPT-6.1 Sol(2026年10月時点・公式参照)
注目したいのは、コーディング能力を測るDeepSWEのスコアです。GPT-6.1 Solは75.2%で、ひとつ上のGPT-6 Astra(74.1%)を上回りました。項目によっては前のAstraより上の数字が出ていて、中位のモデルとは思えない伸び方をしています。
キャッシュ入力の半額も、地味ですが効いてきます。AIにコードを書かせると、同じファイルを何度も読み直すので、キャッシュの料金がそのまま全体の費用に響くからです。料金表の見た目は同じでも、実際の作業ではGPT-6 Solより安く済むと考えてよいでしょう。
GPT-6.1 Solの料金|Astraの5分の1・Opus 5.5の半額
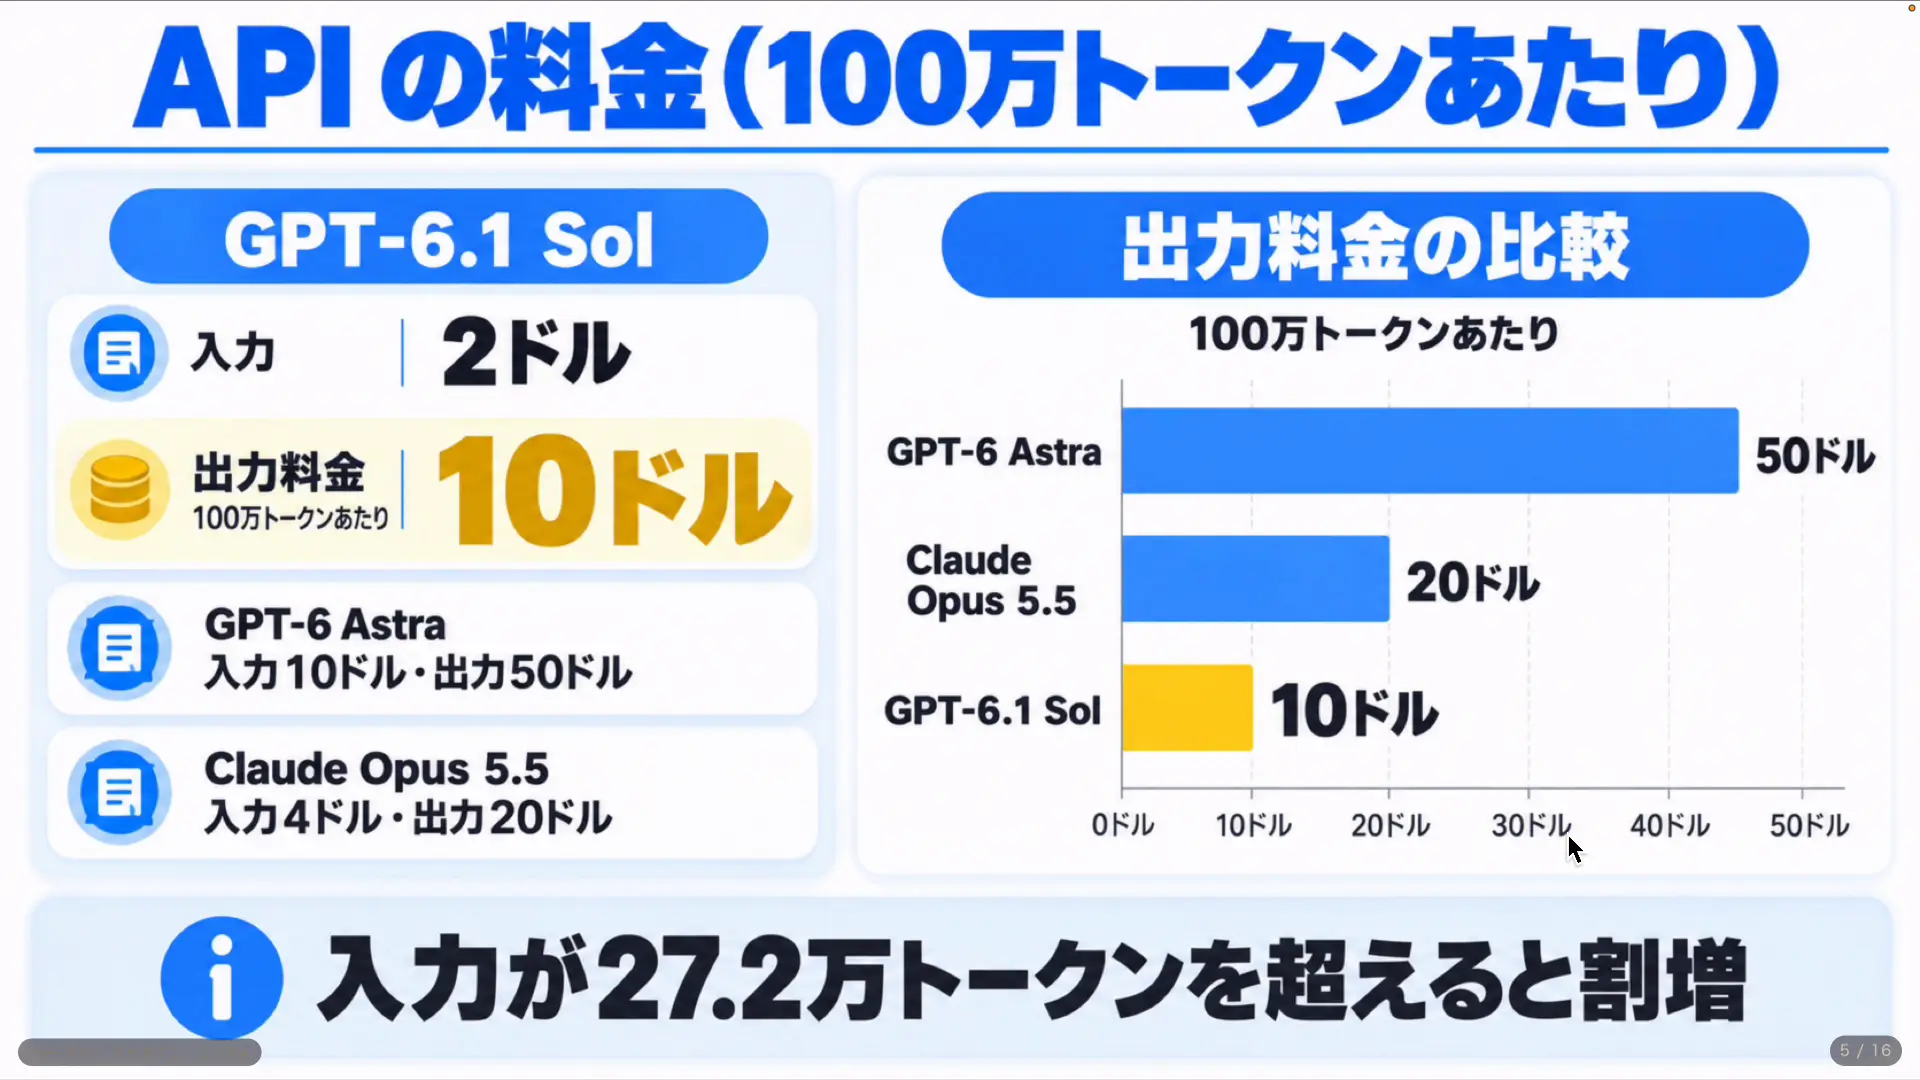
ほかのモデルとも料金を比べてみます。GPT-6 Astraは入力10ドル・出力50ドルなので、GPT-6.1 Solはその5分の1です。Claude Opus 5.5(入力4ドル・出力20ドル)と比べても、ちょうど半分の単価になっています。
| モデル | 入力(100万トークン) | 出力(100万トークン) |
|---|---|---|
| GPT-6 Astra | 10ドル | 50ドル |
| Claude Opus 5.5 | 4ドル | 20ドル |
| GPT-6.1 Sol | 2ドル | 10ドル |
出典:OpenAI API Docs・Claude Pricing(2026年10月時点・公式参照)
ひとつ注意したいのが、長い入力の割増です。1回のリクエストで入力が27.2万トークンを超えると、入力は2倍・出力は1.5倍の料金になります。大きなリポジトリを丸ごと読ませるような使い方では、単価の差が思ったより縮むことがあります。
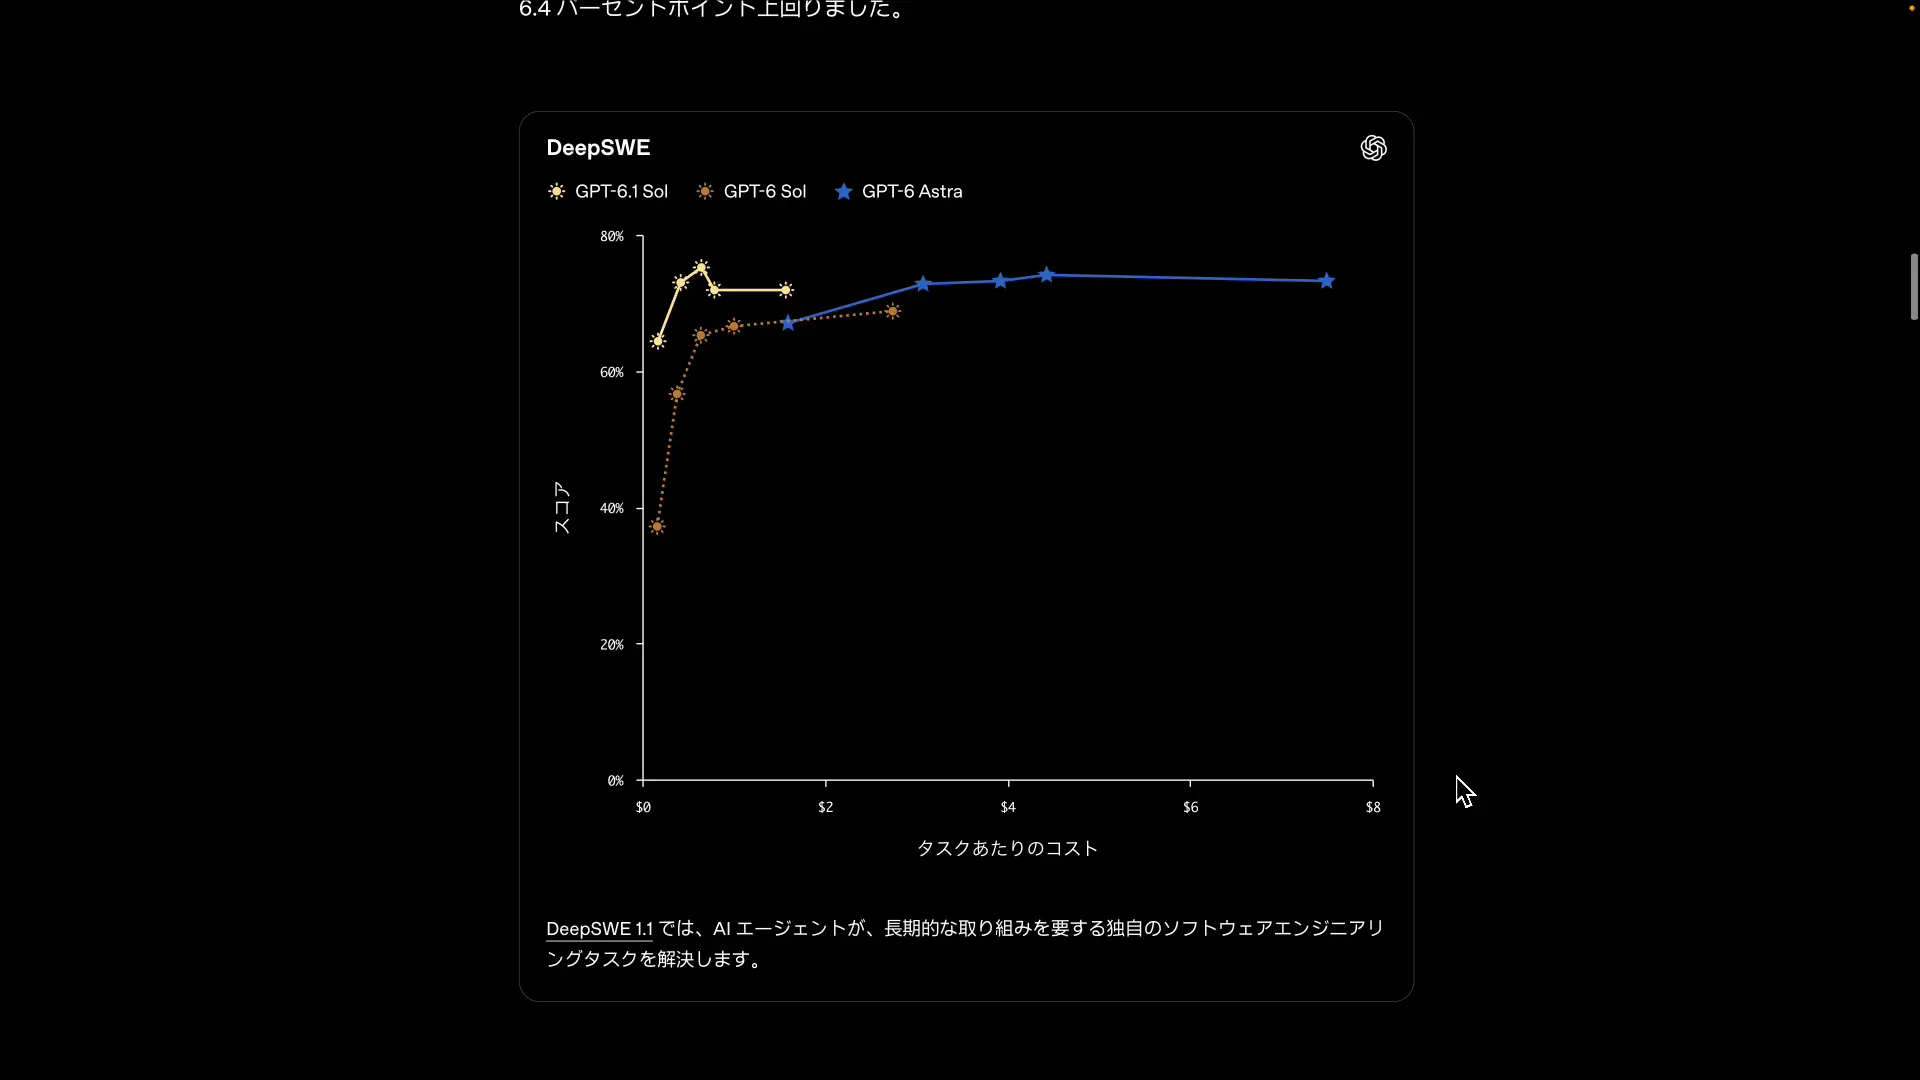
公式のグラフでも、横軸にコスト、縦軸にベンチマークのスコアを取ると、GPT-6.1 SolはAstraより大幅に左(安い側)にありながら、ほぼ同じ高さを保っています。コーディングのようにトークンを大量に使う作業ほど、この差がそのまま財布に効いてきます。
Opus 5.5との比較|総合はOpus、1タスクの費用はSolが約8分の1
気になるのは、先日リリースされたClaude Opus 5.5との差です。第三者の評価サイトArtificial Analysisの総合指数では、一番上は今のところOpus 5.5で、次にGPT-6 Astra、その次にGPT-6.1 Solが並んでいます。トップには届いていないものの、かなり迫っている位置です。
| 項目 | Claude Opus 5.5 | GPT-6 Astra | GPT-6.1 Sol | GPT-6 Sol |
|---|---|---|---|---|
| 総合指数(Artificial Analysis) | 58 | 53 | 52 | 48 |
| 1タスクの費用 | 5.98ドル | 3.26ドル | 0.72ドル | — |
| Webアプリづくり(Arena WebDev) | 1818点・1位 | 1789点・2位 | 1759点・3位 | — |
| PDFの読み取り(GDP.pdf) | 26.2% | — | 31.0% | — |
| 出力の速さ | 毎秒90トークン | — | 毎秒64トークン | 毎秒74トークン |
出典:Artificial Analysis・GPT-6.1 Sol vs Claude Opus 5.5・Arena WebDev(2026年10月時点・第三者参照)
一番大きな差は、1タスクあたりの費用です。Opus 5.5は1タスクに5.98ドルかかるのに対し、GPT-6.1 Solは0.72ドルで、約8分の1に収まっています。総合の賢さではOpus 5.5に勝てていませんが、PDFの読み取りのように、ジャンルによってはOpus 5.5を上回る項目もあります。
もうひとつ、使っていて感じたのがグラフィックの強さです。画面を見ながらの操作や、UIやUXのデザインを組み立てる作業では、GPTのモデルはかなり良いデザインを出してくれます。ゲーム制作やアプリの画面づくりを安いコストで任せたいときに、GPT-6.1 Solは頼もしい選択肢です。Opus 5.5そのものについては、Claude Opus 5.5とは|Fable 5.1並みの性能を4割の料金で使えるでまとめています。
-
-
Claude Opus 5.5とは|Fable 5.1並みの性能を4割の料金で使える
続きを見る
GPT-6.1 Solはどこで使える?|ChatGPT WorkとCodex
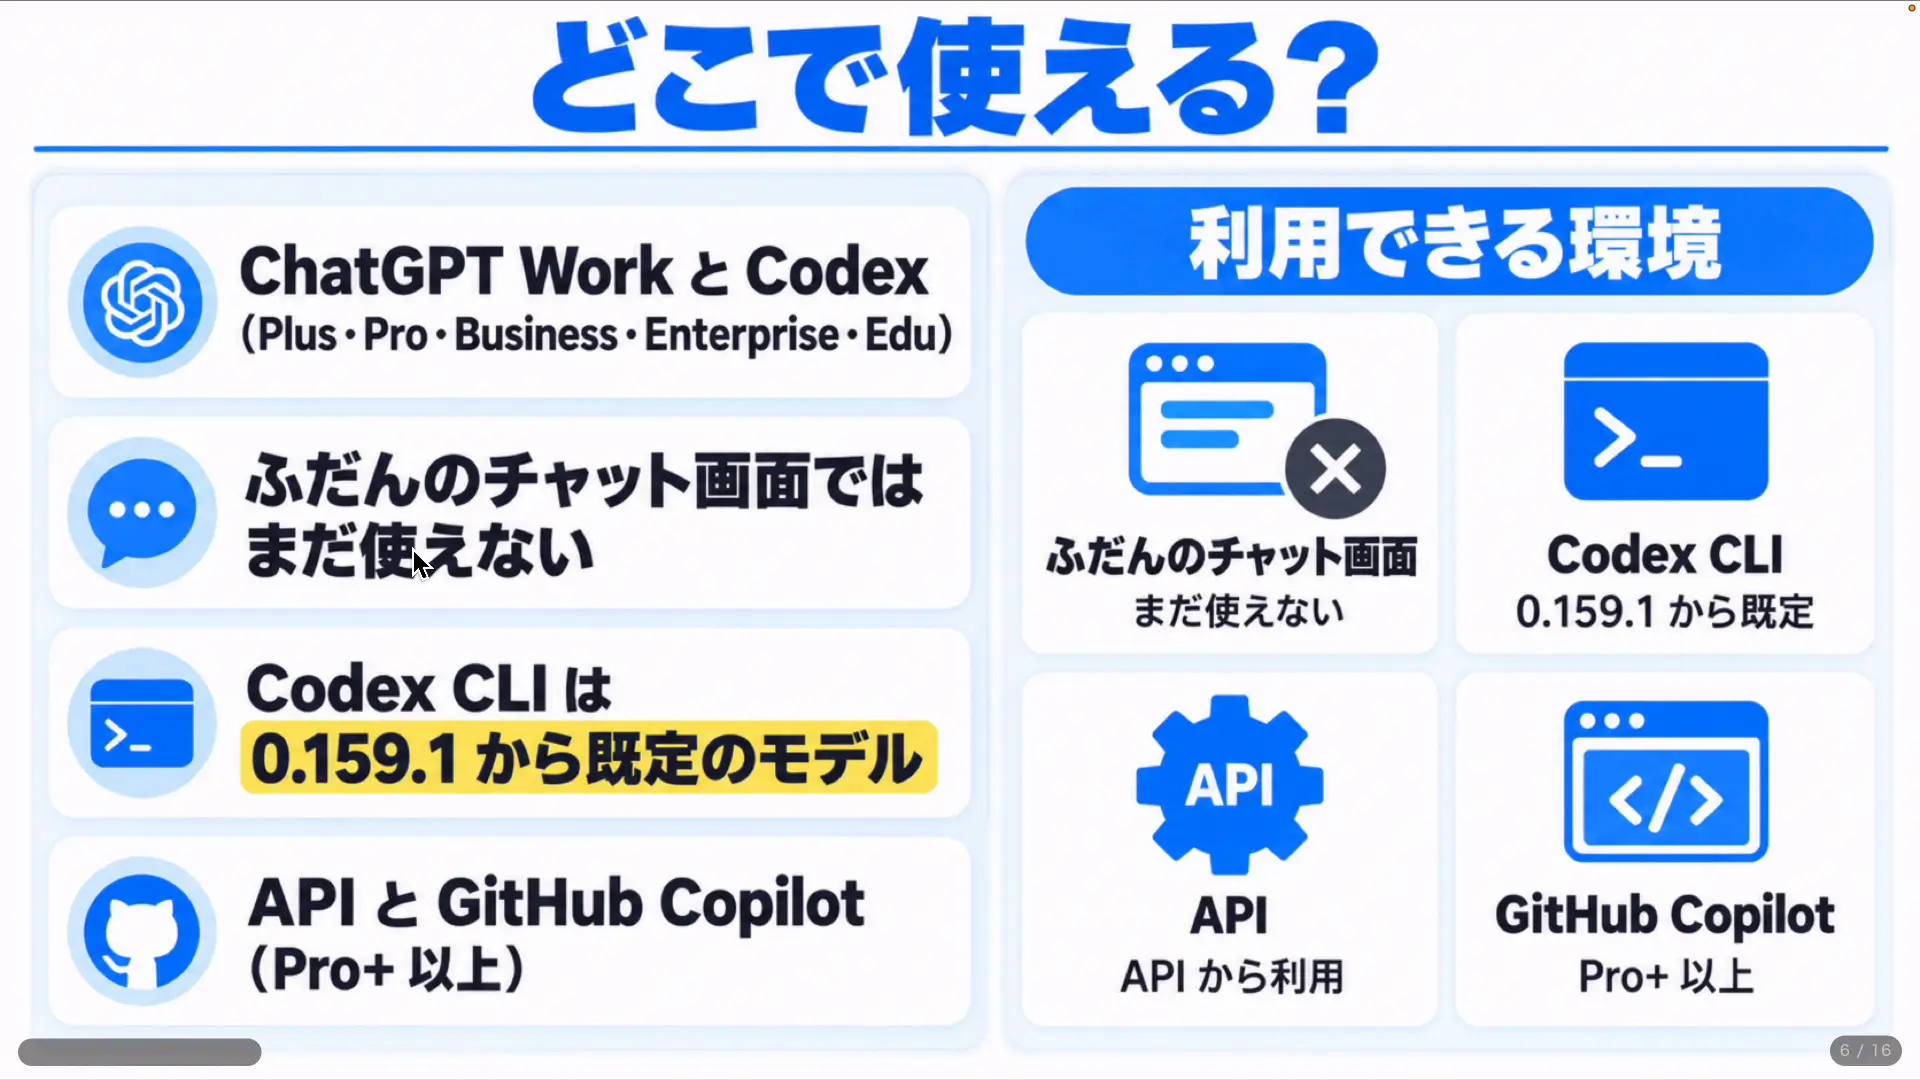
GPT-6.1 Solは、ChatGPTのPlus・Pro・Business・Enterprise・Eduの各プランで、「ChatGPT Work」とCodexから使えます。API(モデル名 gpt-6.1-sol)やGitHub Copilotでも順次使えるようになっています。一方で、FreeとGoのプランは対象外です。
公式の案内では、ふだんのチャット画面ではまだ使えないとされています。僕が資料を作った時点でもチャットの画面には出てきませんでしたが、スマホのアプリからは利用できました。順番に割り当てられているようなので、ご自身の画面で確認してみてください。
| 使える場所 | 内容 |
|---|---|
| ChatGPT Work | Plus・Pro・Business・Enterprise・Edu(Free・Goは対象外) |
| Codex | デスクトップアプリとCLI。CLIは0.159.1から既定のモデル |
| API | モデル名 gpt-6.1-sol |
| Plusの回数の目安 | 5時間あたり15〜160メッセージ |
出典:Introducing GPT-6.1 Sol・Codex Models・ChatGPT Pricing(2026年10月時点・公式参照)
Codex CLIを使っている方は、ターミナルで最新版に更新するだけで切り替わります。更新後に起動すると、既定のモデルがGPT-6.1 Solになっています。
npm i -g @openai/codex@latest
codex --version
APIやOpenRouterからも使えますが、どんどん作業を回すなら、ChatGPTのサブスクの枠の中で使うほうがコスパは良いと感じています。Codexの基本的な使い方はChatGPTボイスが凄い|声だけでCodexがWebアプリを作る使い方でも紹介しています。
GPT-6.1 Solに向いている作業・Opus 5.5に任せたい作業
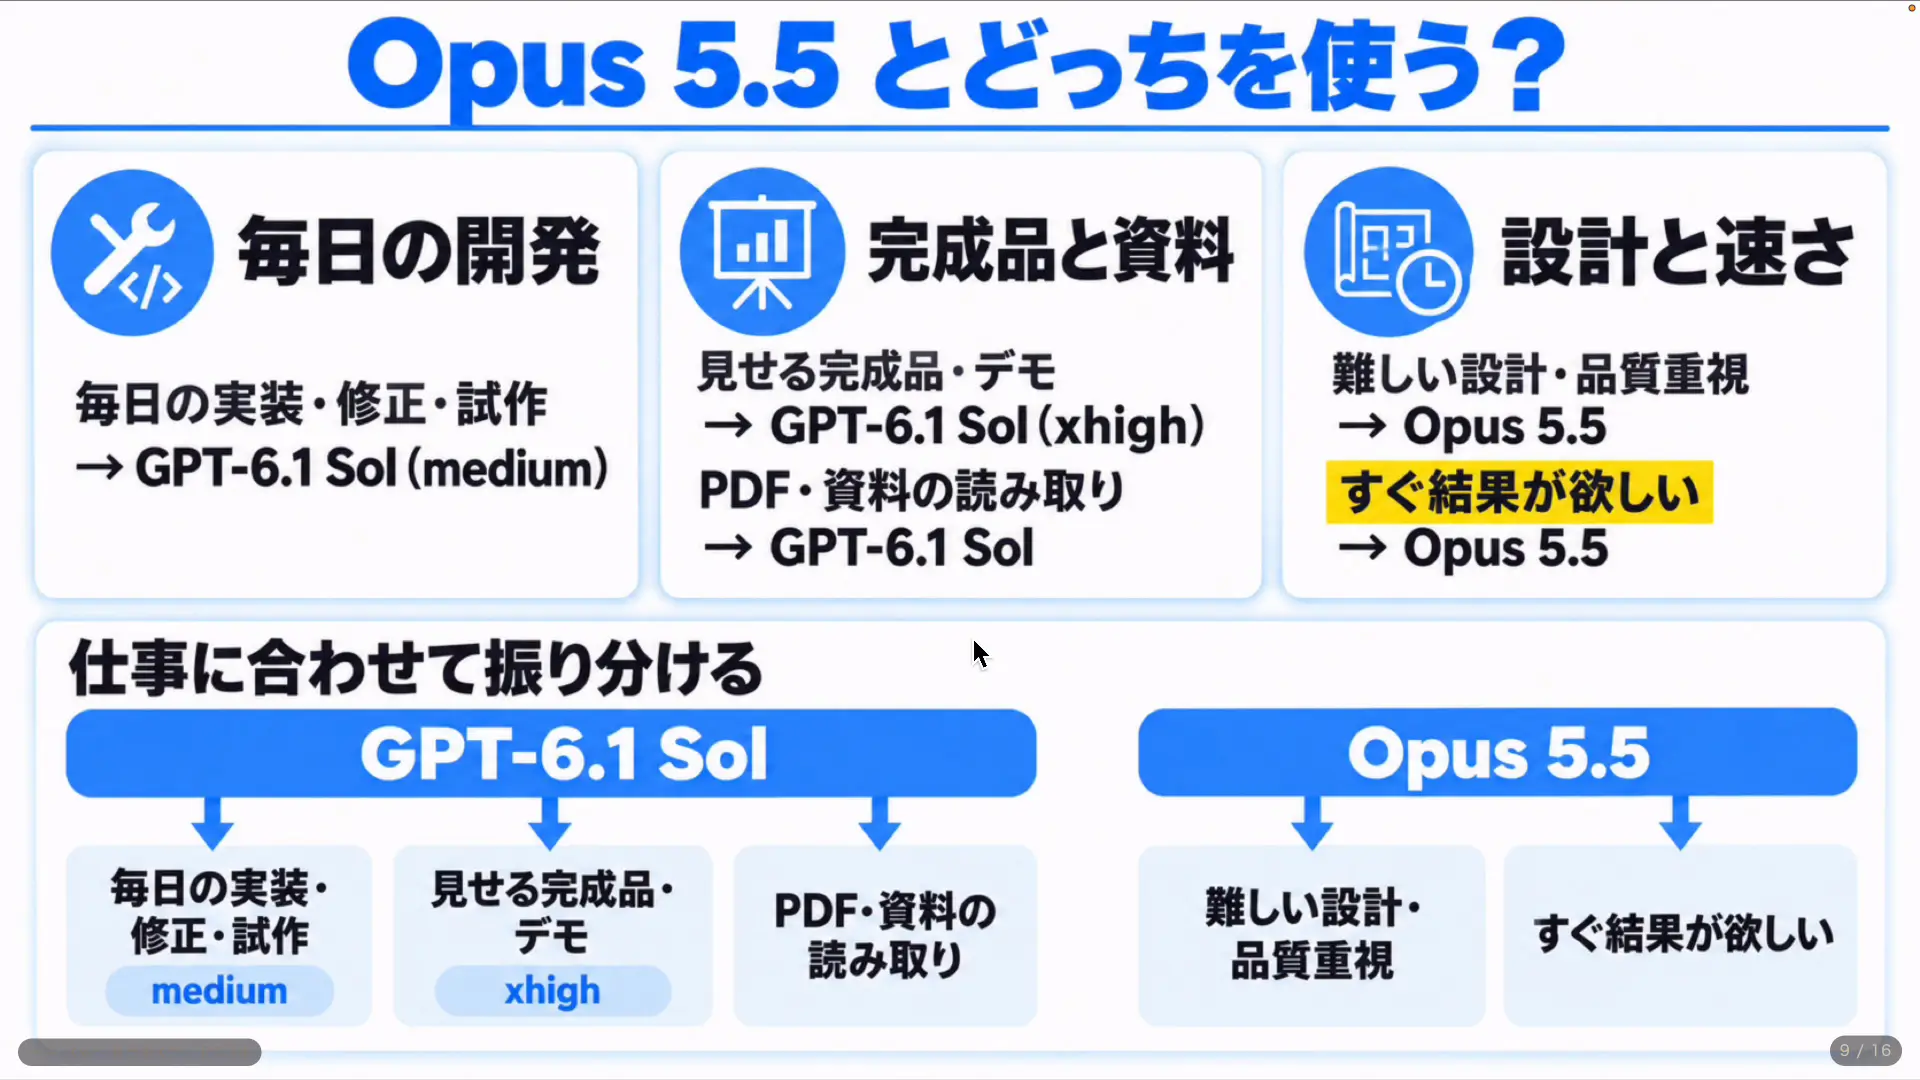
優秀なモデルですが、使ってみると向いている作業と、Opus 5.5のほうが良い作業がはっきり分かれました。ベンチマークのスコアどおり、得意・不得意がある印象です。
| 作業 | おすすめ | 理由 |
|---|---|---|
| 毎日コツコツ進める実装・修正 | GPT-6.1 Sol | 安く、たくさん回せる |
| UI・UXに重みがあるアプリやゲーム | GPT-6.1 Sol | グラフィックのデザインが強い |
| PDFなど資料の読み取り | GPT-6.1 Sol | GDP.pdfでOpus 5.5を上回る |
| 全体を深く広く知る必要がある設計 | Opus 5.5 | 総合の賢さが上 |
| 品質を重視する仕上げ | Opus 5.5 | ゲームの操作性や作りの丁寧さが上 |
Claude CodeとCodexを両方使っている方は、まだ多くないと思います。どちらかの環境しか持っていない方も、こうした特徴を知っておけば、CLAUDE.mdやAGENTS.mdで作業の割り振りを設計するときに役立ちます。
僕自身は、全体の設計をFable 5.1に任せ、実際に手を動かす部隊にOpus 5.5とGPT-6.1 Solを置く形にしています。GPT-6 Solをどう使うかも考えましたが、コスパを見るとGPT-6.1 Solがかなり優秀だったので、今回さっそく入れ替えました。こうした役割分担の考え方はハーネスエンジニアリングとは|Claude Codeでアプリ開発の質が変わる3つの仕組みで解説しています。
-
-
ハーネスエンジニアリングとは|Claude Codeでアプリ開発の質が変わる3つの仕組み
続きを見る
2Dアクションの比較|敵のすり抜けが直りアニメーションも可愛い
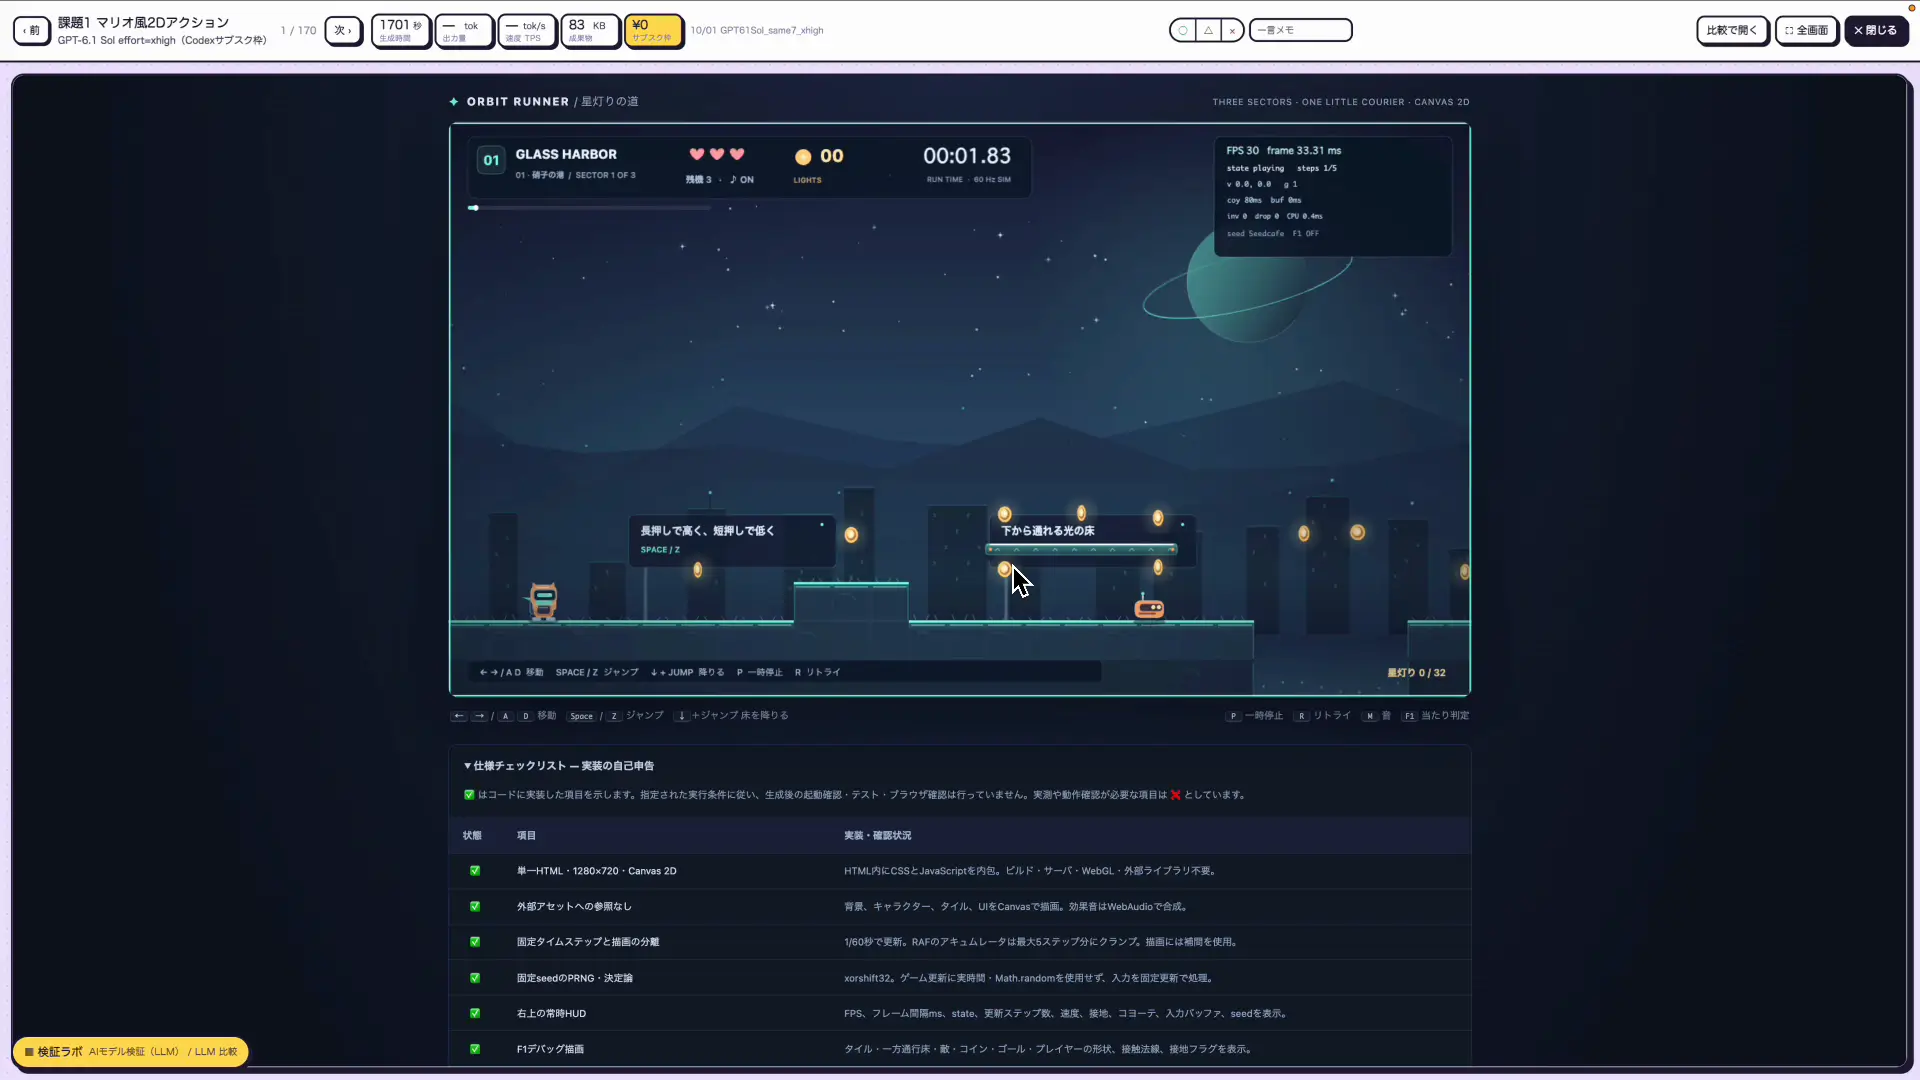
ここからは、実際にどれくらいのものが作れるかを見ていきます。比べるのは、GPT-6.1 Sol(effortはxhigh)とOpus 5.5で、同じプロンプトを1回だけ渡して作らせました。effortは最大でmaxまであるので、もう少し頑張ればさらにスコアが出る、という前提で見てください。
まずは2Dアクションゲームです。以前のモデルでは、高さのある台に乗れなかったり、敵が壁を突き抜けたりするエラーがよく出ていました。GPT-6.1 Solではそうした問題がしっかり直っていて、敵を倒したときやダメージを受けたときのアニメーションも、かなり可愛く作ってくれました。
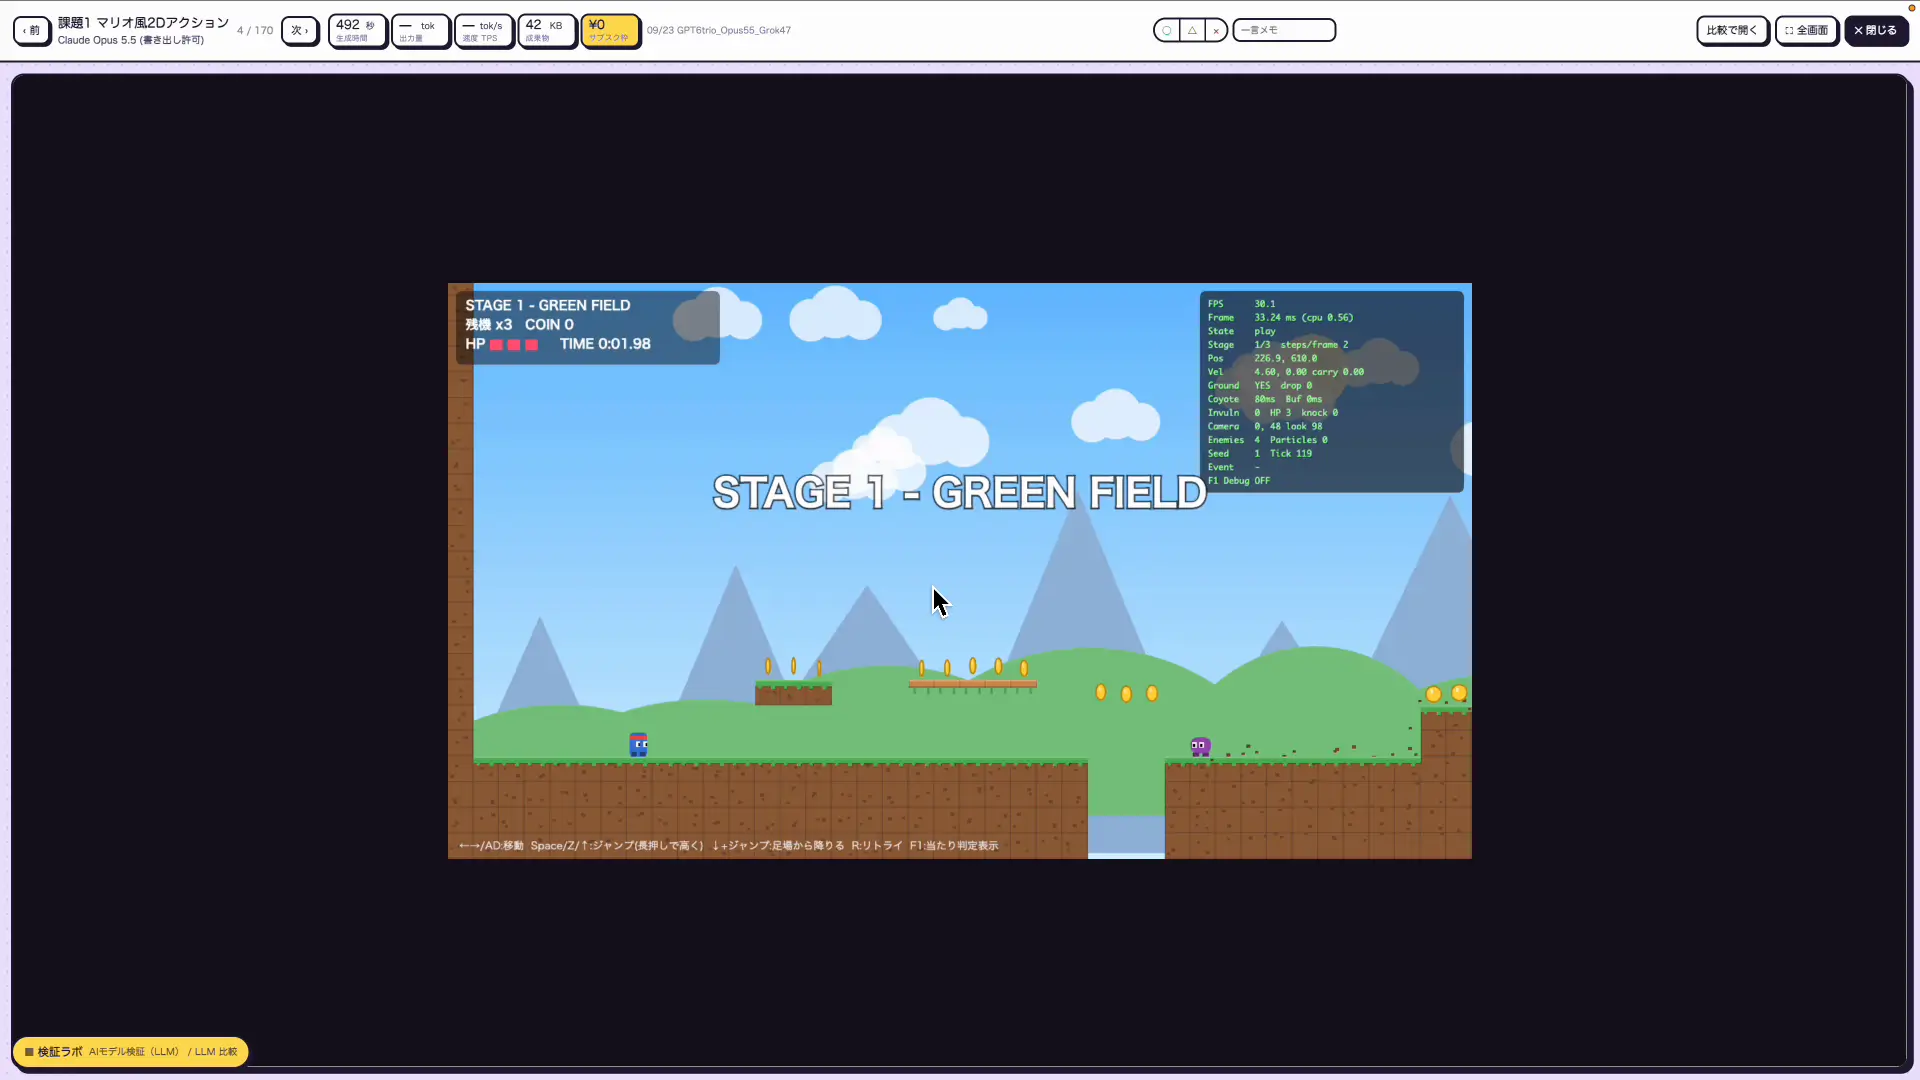
同じお題のOpus 5.5は、見た目が少しシンプルな作りです。ただ、精度はかなり高く、敵がしっかり追いかけてきたり、上へ進んでいくコースや斜めに動く台が用意されていたりと、ゲームとしての作り込みが光っていました。見た目のGPT-6.1 Sol、プログラムのOpus 5.5という形で、特徴がきれいに分かれた結果です。
3Dアスレチックゲーム|前の世代よりゲーム性が上がった
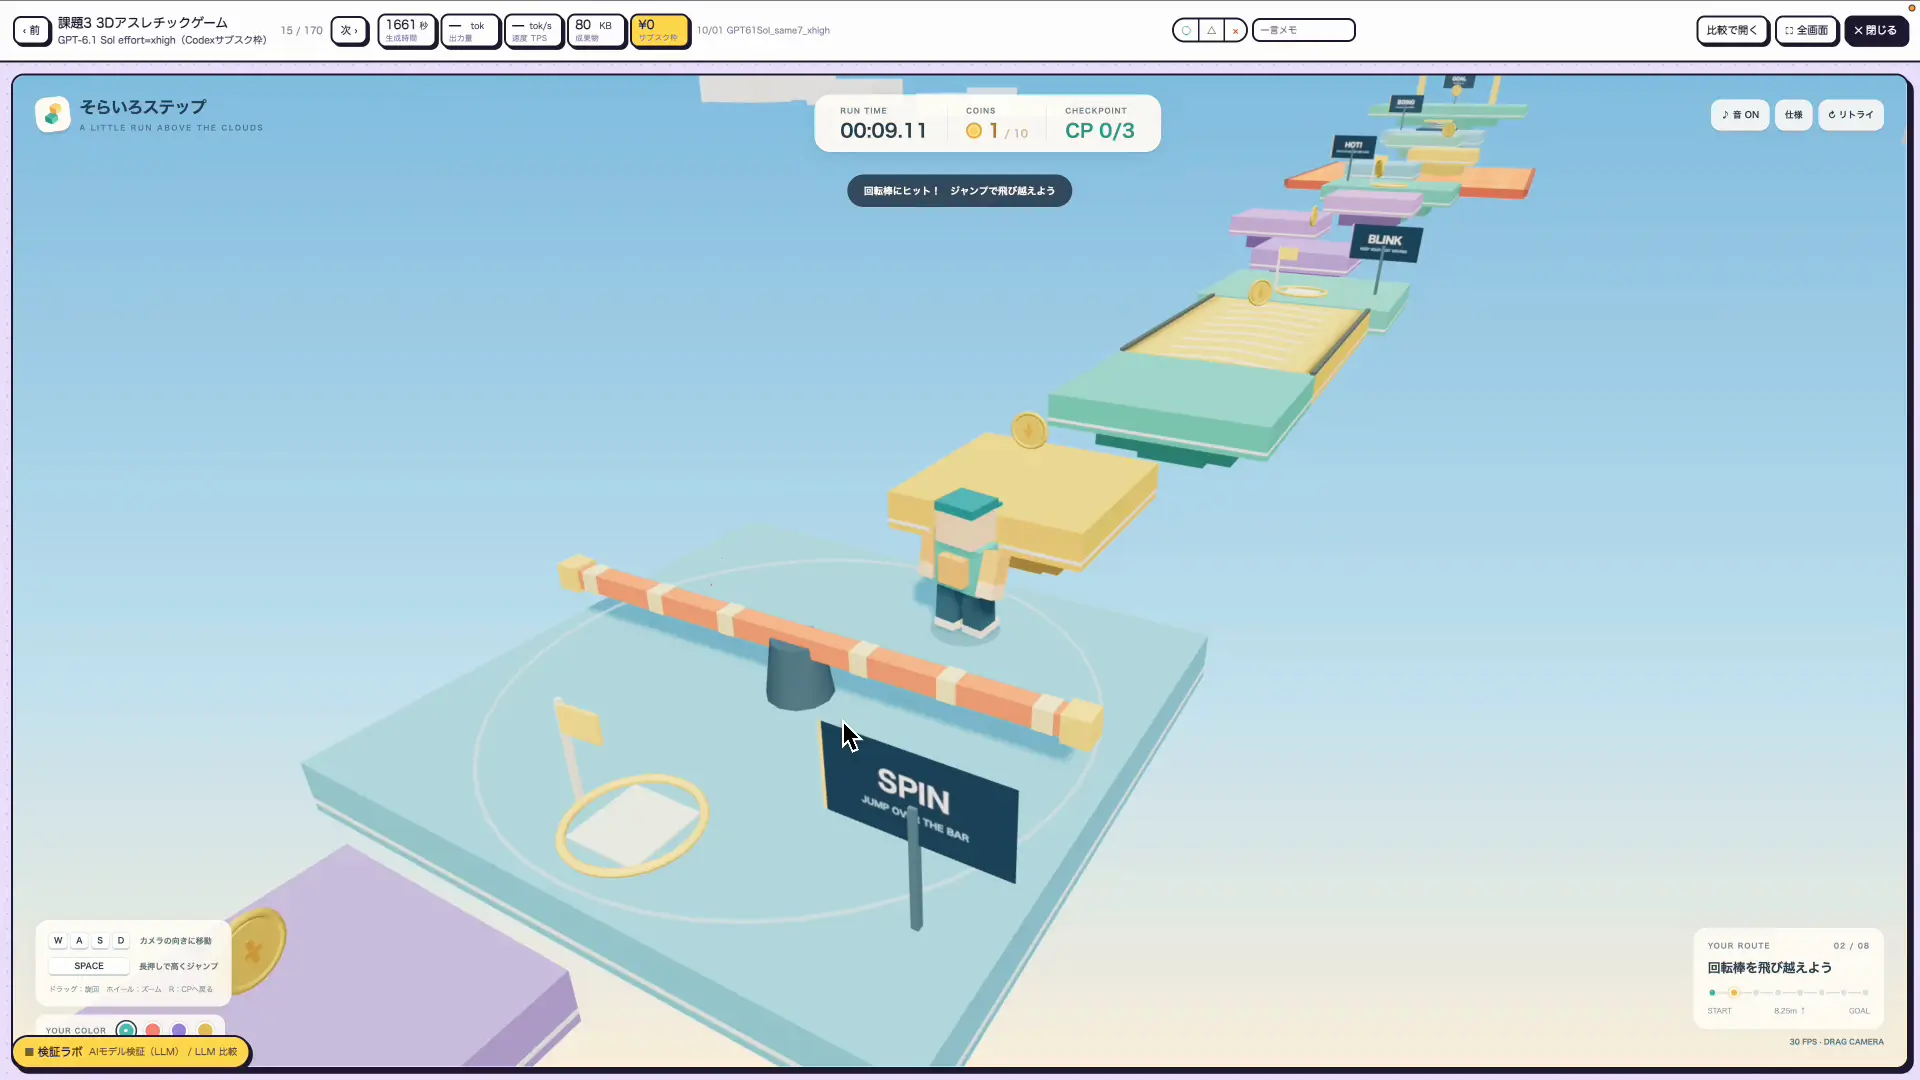
続いて、3Dのアスレチック(3Dアドベンチャー)ゲームです。3Dのアクションゲームは、以前のモデルではかなり難しいお題でした。GPT-6.1 Solが作ったものは、最初の頃と比べるとクオリティが大きく上がっています。
前のモデルでは、キャラクターが吹っ飛びすぎたり、大きさのバランスがおかしかったりしました。GPT-6.1 Solは、キャラクターの大きさや動きまでゲーム性を考えて作り上げてくれています。プロンプトを人間がどんな意図で出したのかまで汲み取って作ってくれる、賢いモデルになったと感じました。
マリオカート64の比較|グラフィックはGPT、遊びやすさはOpus
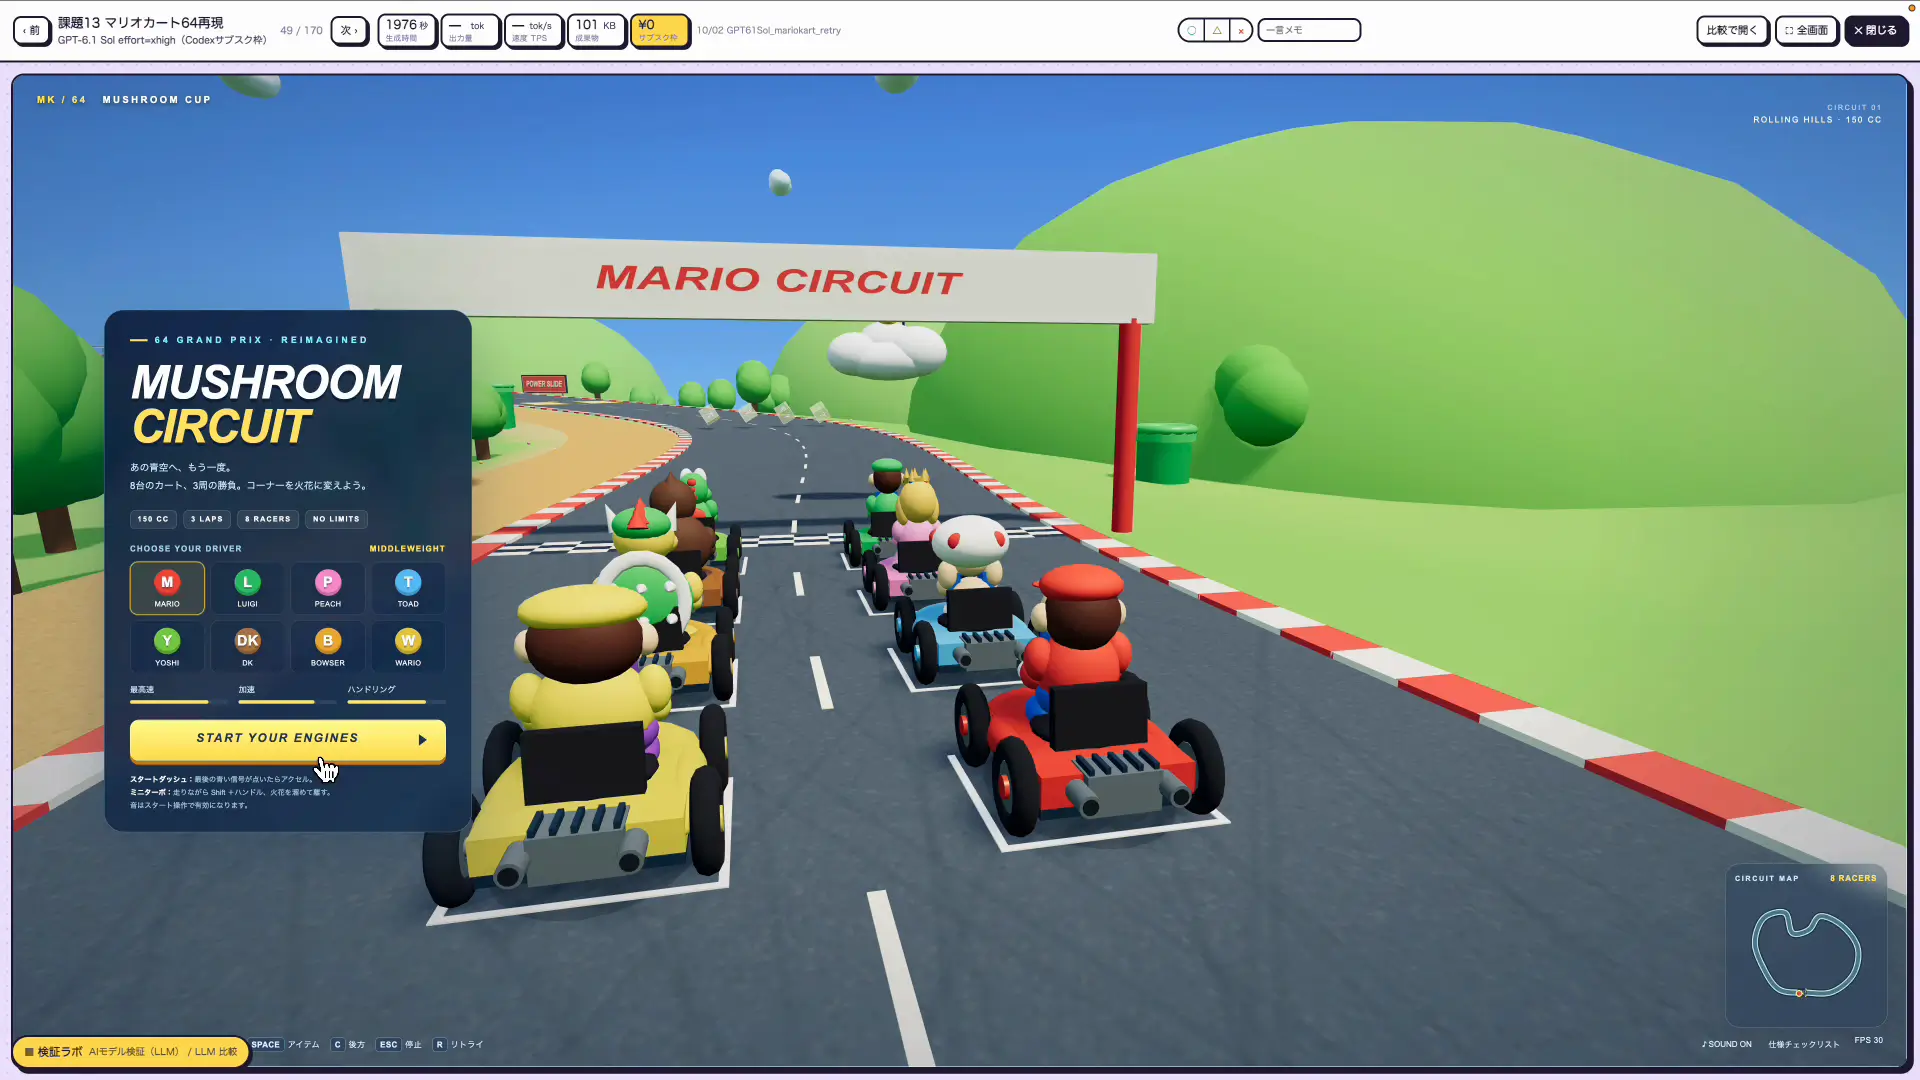
次は、マリオカートのようなゲームを作ってもらいました。コースやカート、スタートの演出まで作り込まれていて、グラフィックに関してはGPTのモデルが生成する画面のクオリティの高さがよく分かります。
ただ、ちょっと残念な点もありました。左右の十字キーで操作すると、左右が逆になってしまうエラーがあったのです。ワンショットで作らせているので仕方ない部分ですが、そこだけは惜しいところでした。
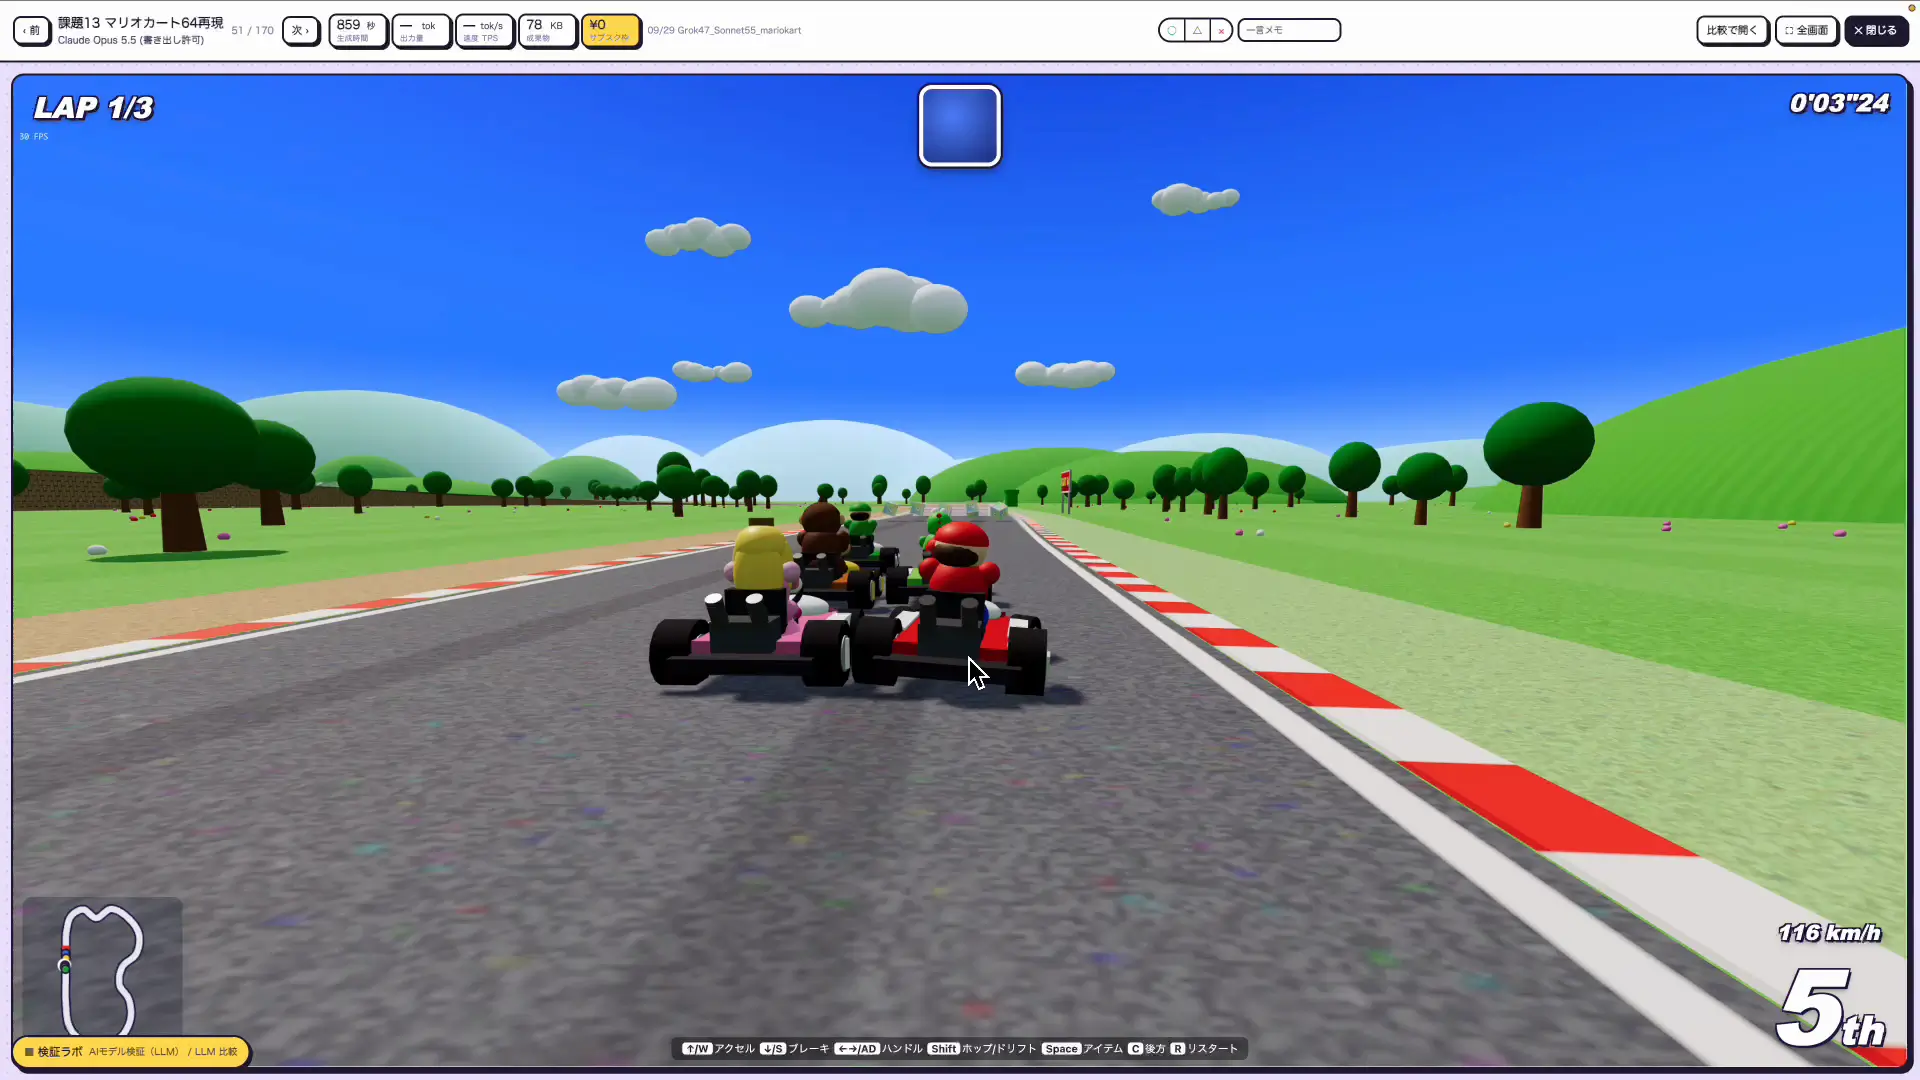
同じお題のOpus 5.5は、操作性やゲームとしてのクオリティがかなり高い仕上がりでした。一方でグラフィックの面では、GPTのモデルには及ばない印象です。遊びやすさを取るならOpus 5.5、見た目を取るならGPT-6.1 Sol、という分かれ方になりました。
ハーネスエンジニアリングの資料づくり|Opus 5.5より少し下
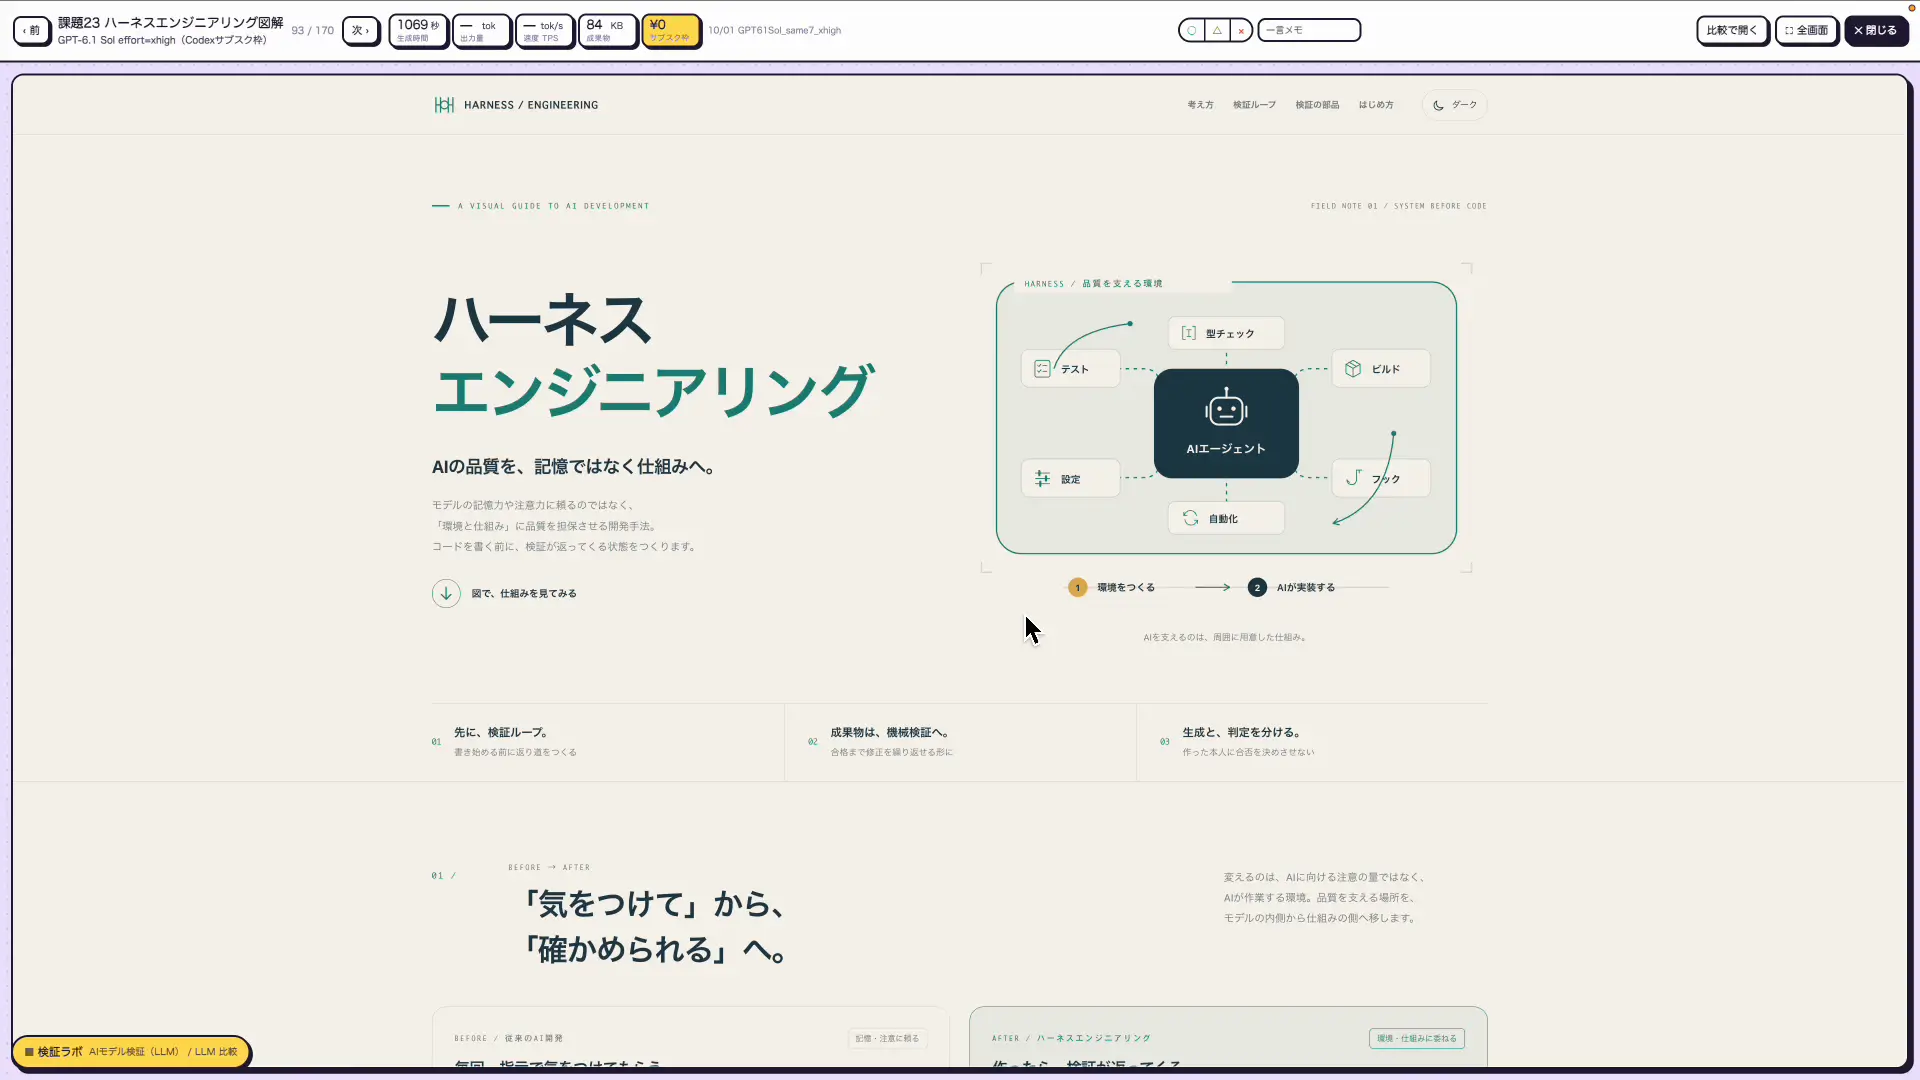
ゲーム以外に、ハーネスエンジニアリングについての資料も作ってもらいました。少し動きのある資料にまとめてくれましたが、全体的にはやや情報が薄めの仕上がりです。
正直なところ、ほかのAIに作らせた資料とほとんど差は分からないレベルでした。この資料づくりに関しては、Opus 5.5のほうが少しクオリティが高かったので、GPT-6.1 Solは「Opus 5.5より少し下」くらいのイメージを持っておくとよいと思います。
桶狭間の戦いシミュレーション|3Dモデルで時間を動かせる
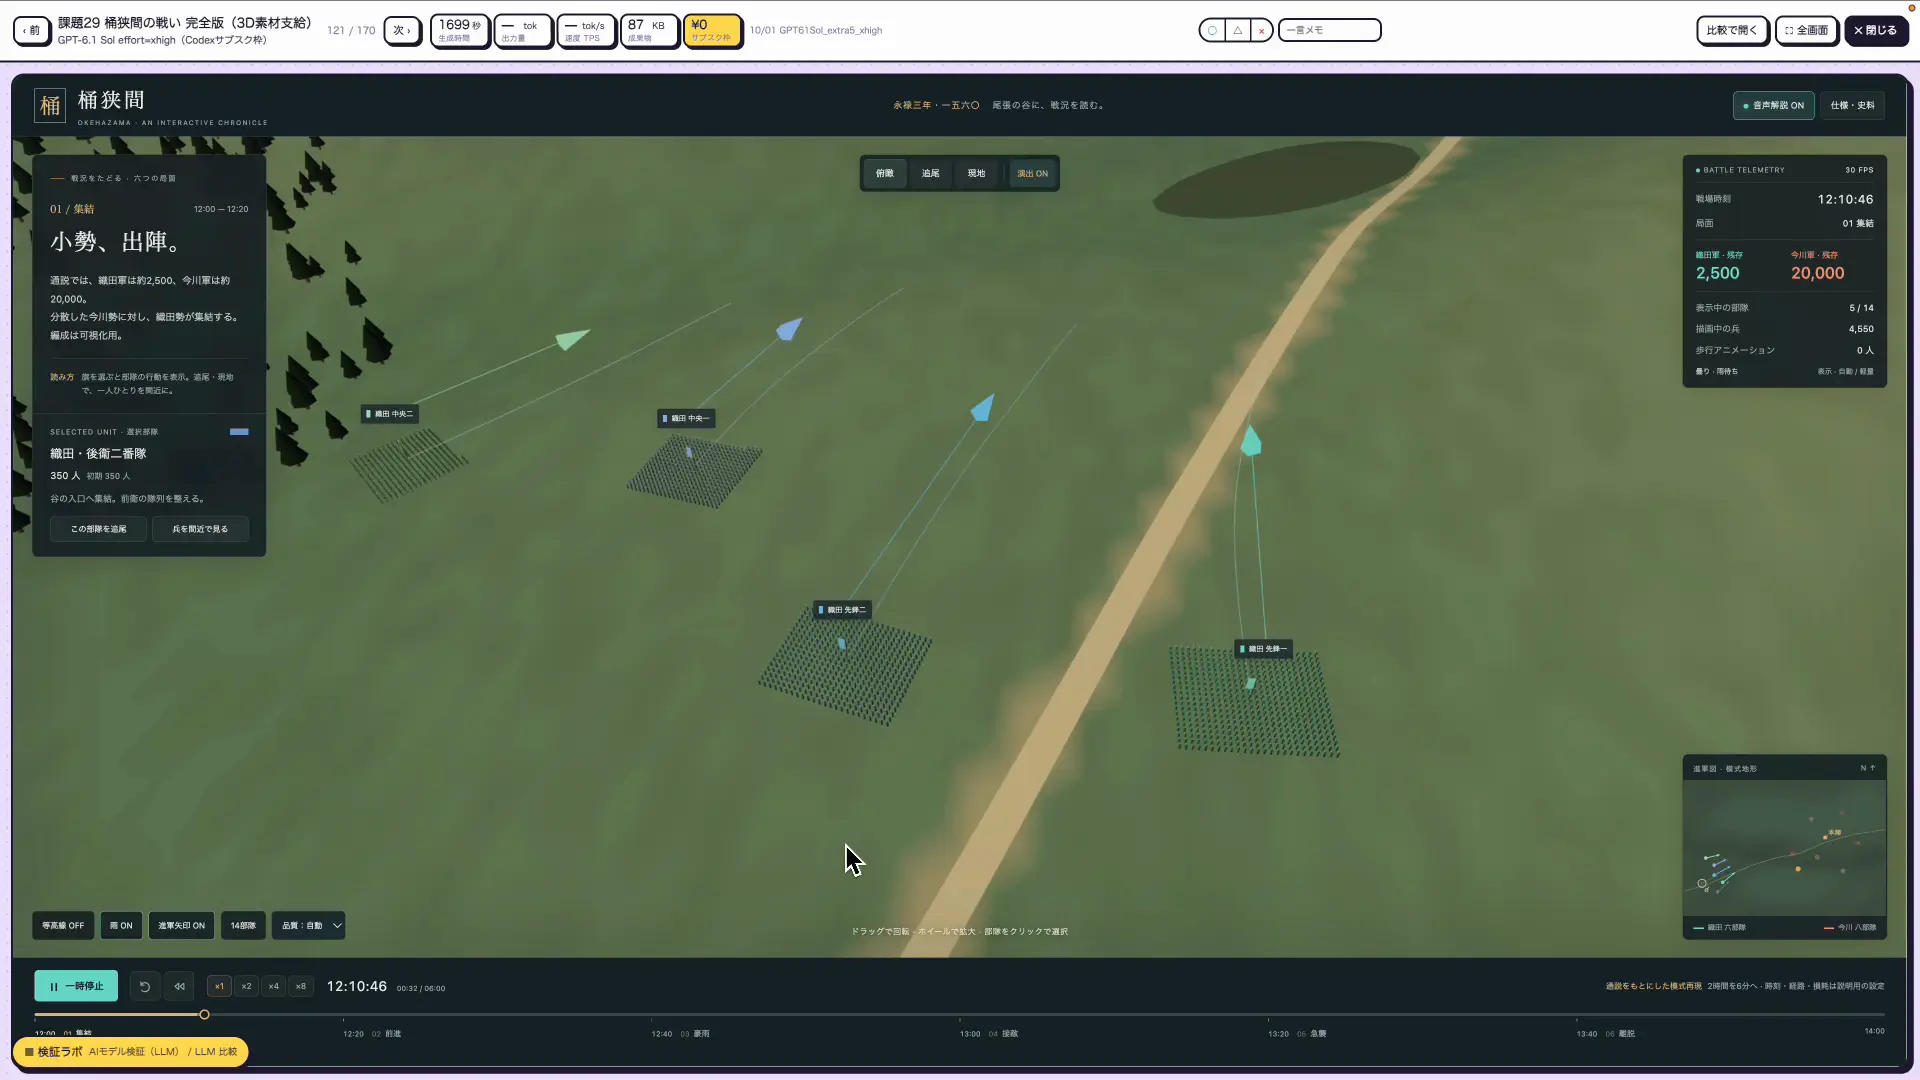
歴史の教材として、桶狭間の戦いのシミュレーションも作らせました。3Dのモデリングを使いながら、部隊が動く様子を時間に沿って再生できるシミュレーションになっています。
ワンショットで作っているので、クオリティはこのくらいかなというところです。もう少し作り込めば、かなりクオリティの高いものも作れます。以前、Tripo AIとGPT-6 Astraを組み合わせて本格的な3Dシミュレーションを作り込んだときは、より高いクオリティのものができました。その様子はGPT-6 Astraで3Dシミュレーターを作る|京都・桶狭間・渋谷を再現で紹介しています。
-
-
GPT-6 Astraで3Dシミュレーターを作る|京都・桶狭間・渋谷を再現
続きを見る
スーパーマリオ64の再現|ボスを倒すとスターが出るまで作れた
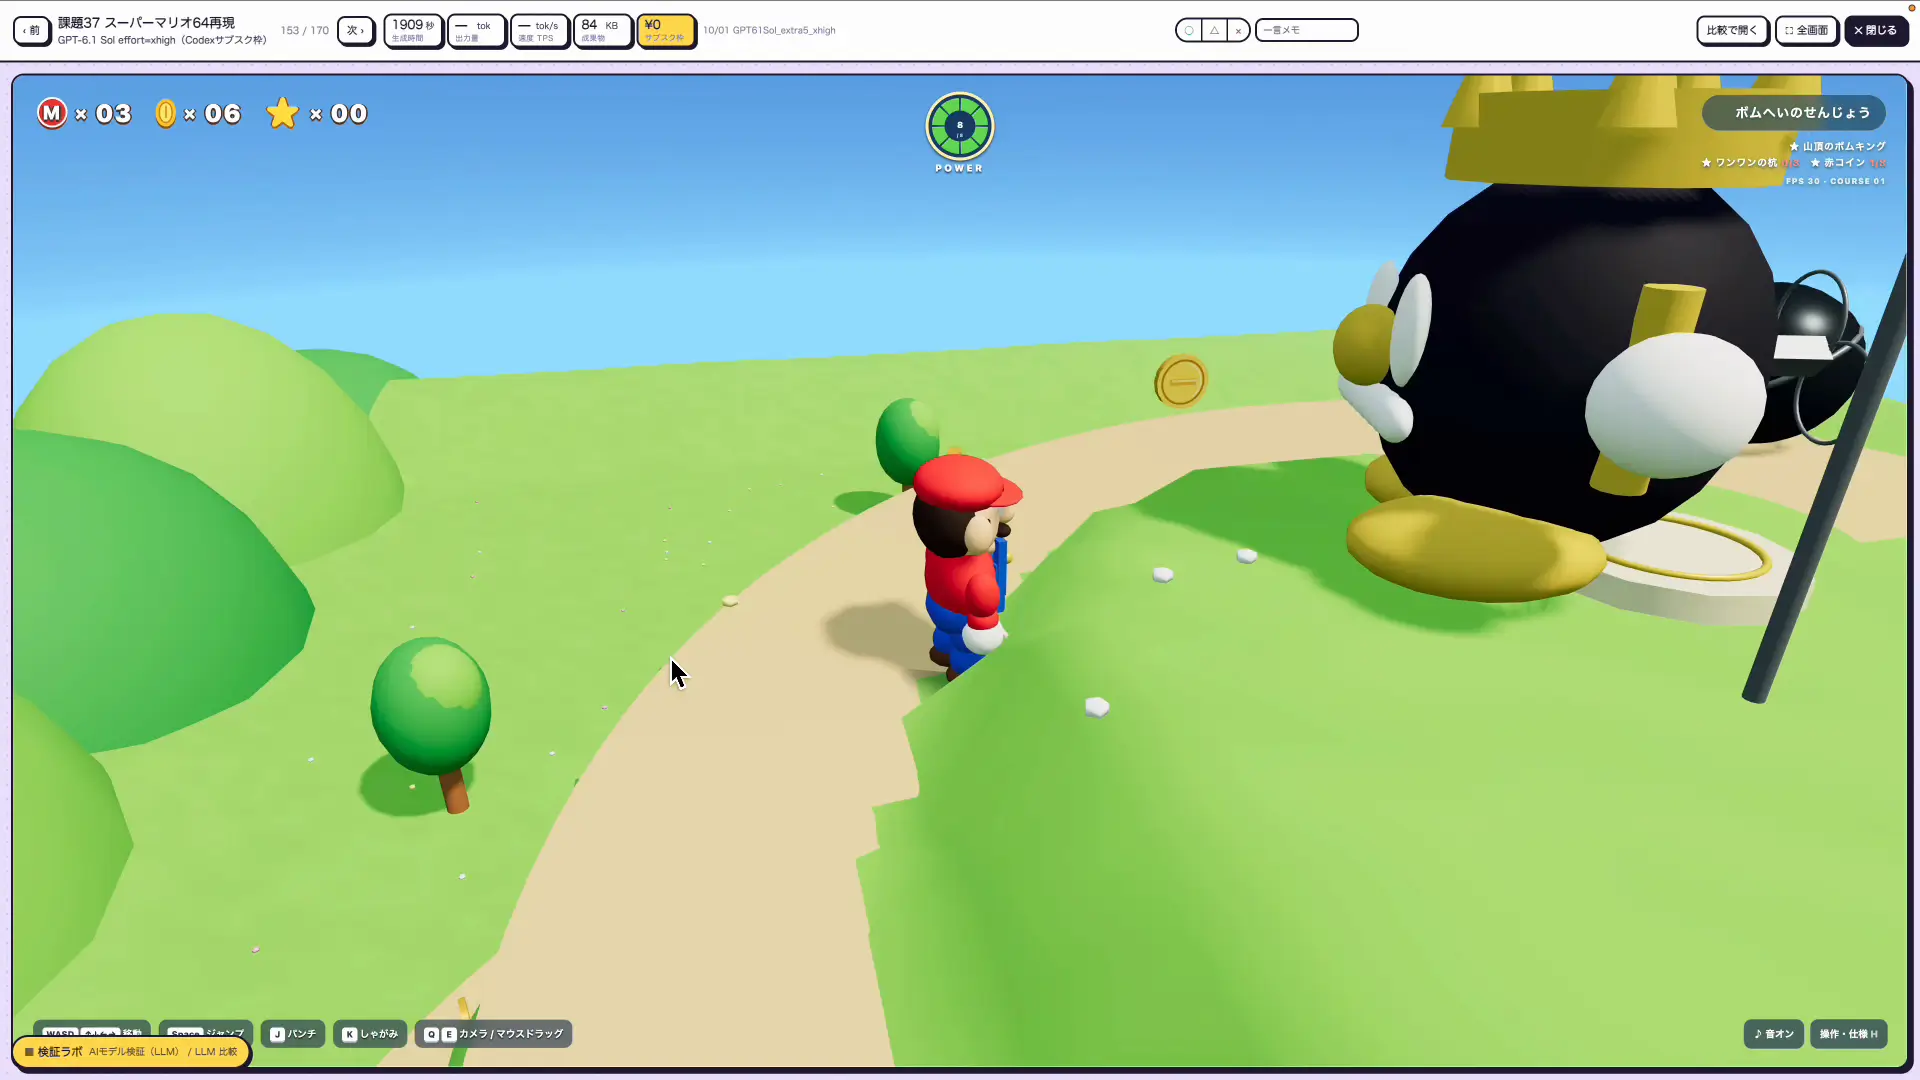
冒頭でも紹介した、スーパーマリオ64のようなゲームです。これはかなりクオリティが高い仕上がりでした。グラフィックのデザインは、やはりGPT系のモデルがとても良いです。ゲームのコースもかなり忠実に再現してくれています。
山の上にはボスがいて、Jキーのパンチでボスを倒すとスターが出てきて、そのコースはクリアになります。ゲームとしてもしっかり作られていて、遊んだことのある方なら、懐かしい雰囲気をしっかり感じられるはずです。
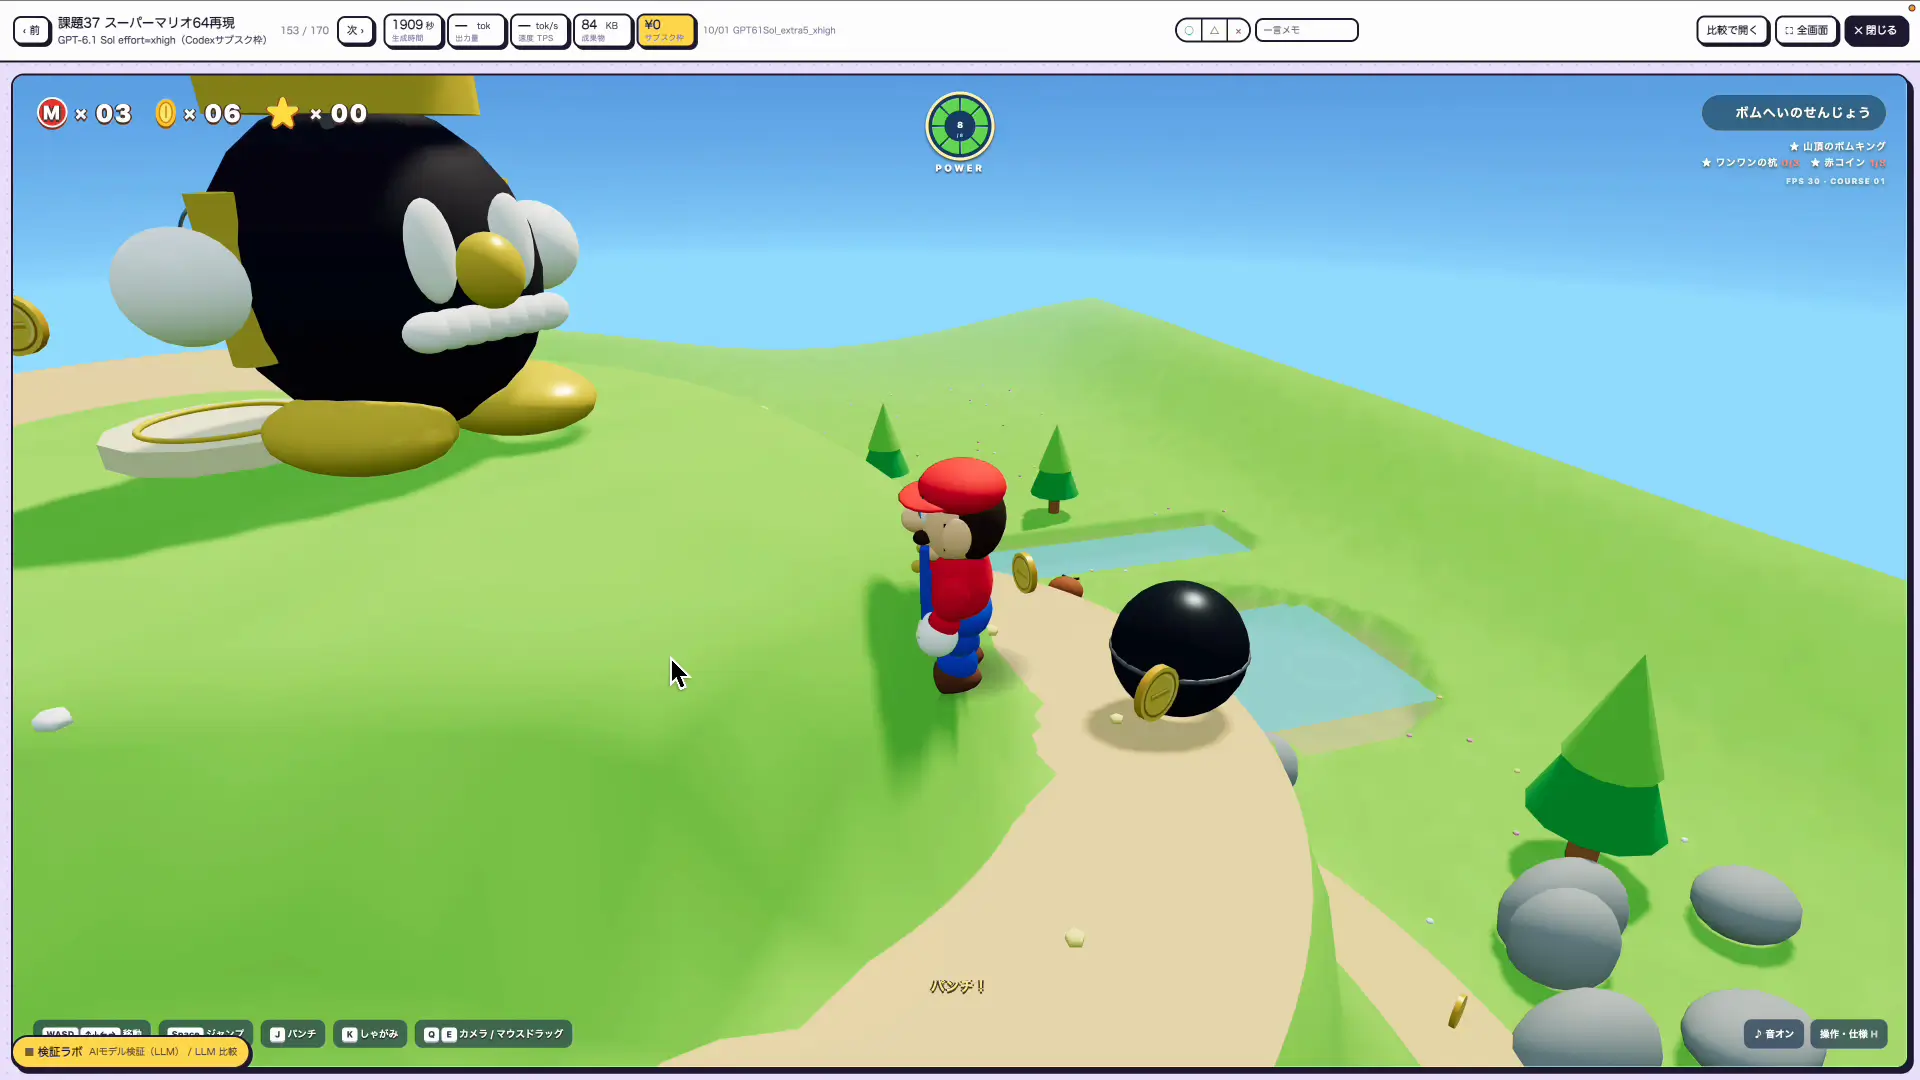
実は、1週間前のGPT-6 Solに同じお題を出したときは、タイトル画面の裏で構文エラーが出て、ゲームを始めることすらできませんでした。同じプロンプトで、動かなかったものが動くようになったのは、今回の更新で一番分かりやすい変化です。
文章の生成|見出し・表・引用まで整えたブログ記事
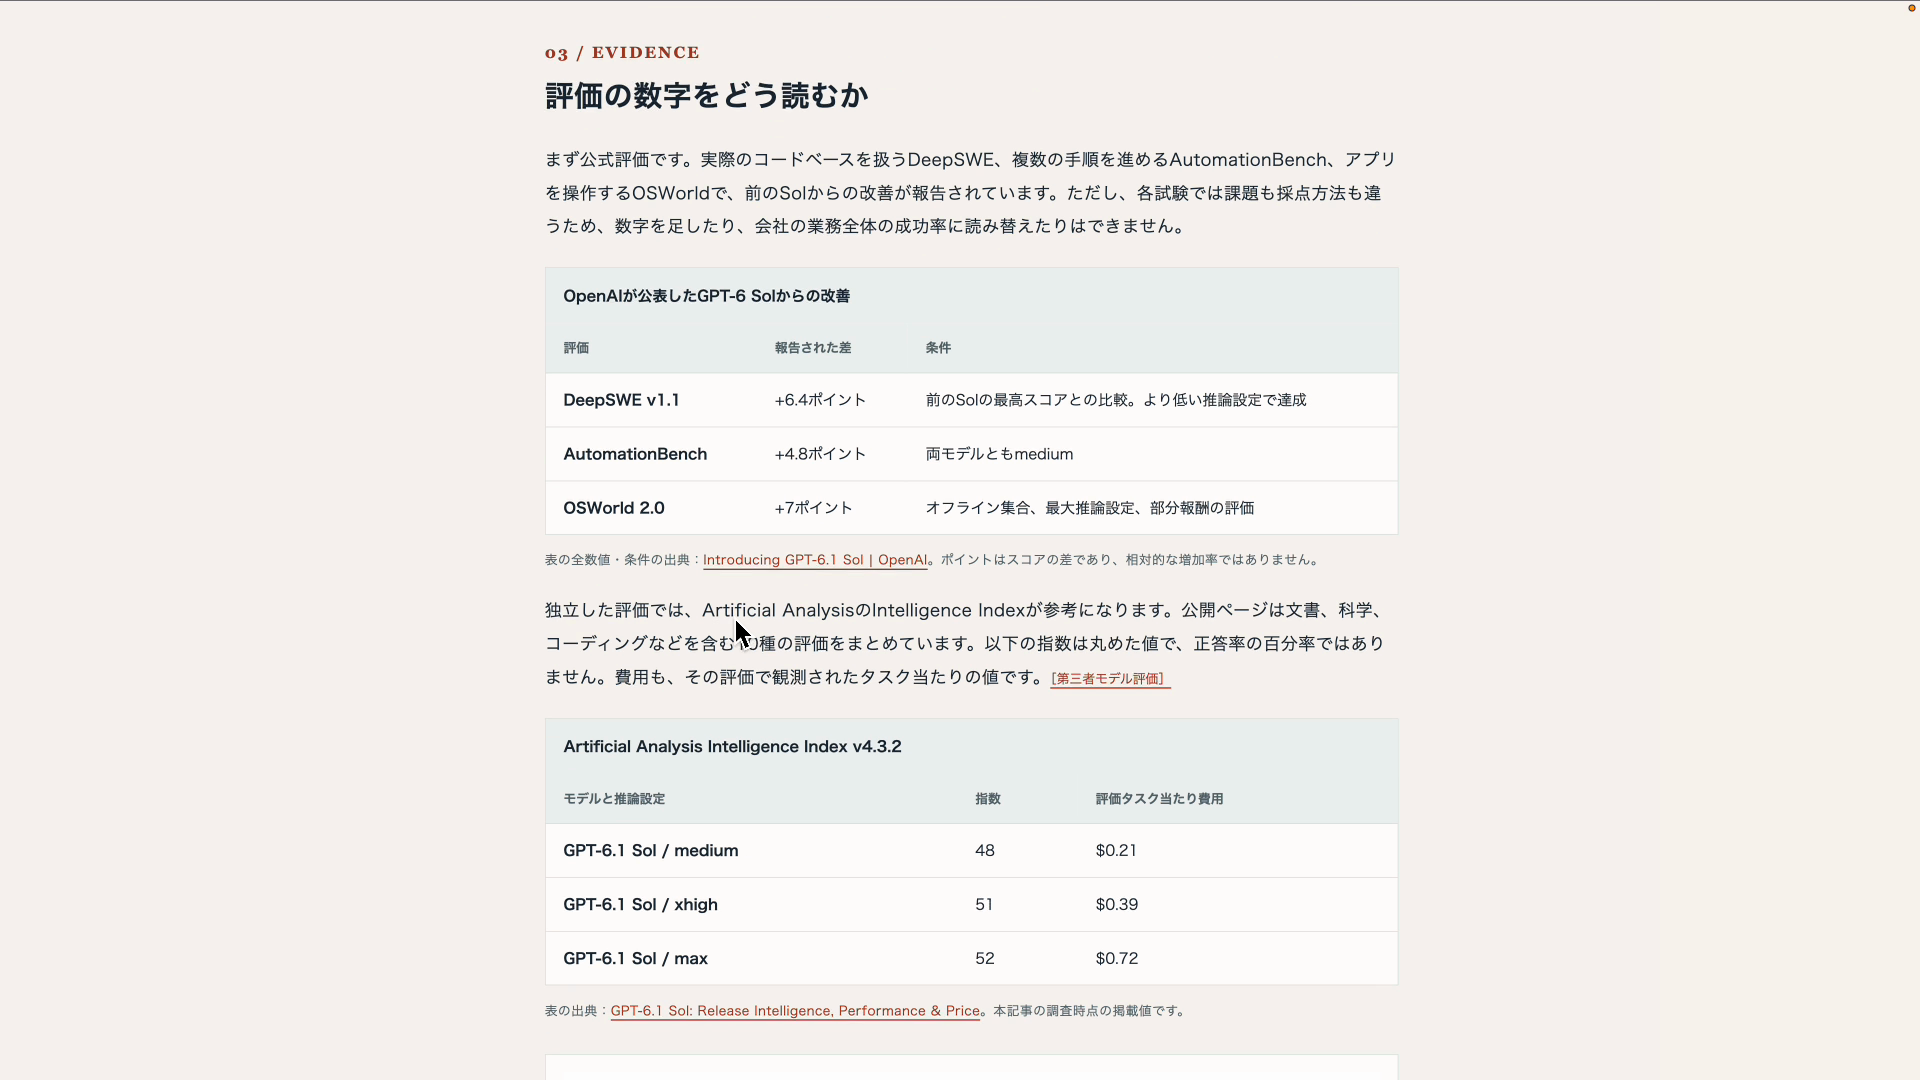
最後に、文章も作ってもらいました。お題は、GPT-6.1 Sol自身のモデルを解説するブログ記事です。見出しや表、引用部分を上手に組み合わせ、参考リンクもきちんと付けてくれました。
図表も、公式の信頼できる情報をもとに画像を埋め込んでくれていて、アブストラクト(要約)の部分まで整えられています。文章を作らせる用途にも十分使えるモデルです。ChatGPTの有料アカウントがひとつあれば、ここまでいろいろな体験ができるので、ぜひ試してみてください。
Codexで使うときの待ち時間とeffort|自分で測った結果
動画のあとに、検証アリーナで同じお題を作らせた時間も測ってみました。ゲーム11本を、GPT-6.1 SolとGPT-6 Solはeffort xhigh、Opus 5.5は既定の設定で、それぞれ1回ずつ作らせています。起動時のエラーは、GPT-6.1 SolとOpus 5.5が0本、GPT-6 Solは3本でした。
| 項目 | GPT-6.1 Sol | GPT-6 Sol | Claude Opus 5.5 |
|---|---|---|---|
| 起動時のエラー(11本中) | 0本 | 3本 | 0本 |
| 11本の合計時間 | 300.2分 | 100.4分 | 175.0分 |
| 出力の大きさ(11本の合計) | 951KB | 453KB | 717KB |
出典:Routine Labo 検証アリーナでの実測(2026年9月23日〜10月2日・同じプロンプトを1回ずつ)
気をつけたいのは待ち時間です。GPT-6.1 Solは、前のGPT-6 Solの約3倍の時間がかかりました。そのぶん書く量も約2倍に増えていて、たくさん書くから遅い、という結果です。Xでも「遅い」という声が多く、ここは割り切りが必要なポイントだと感じました。
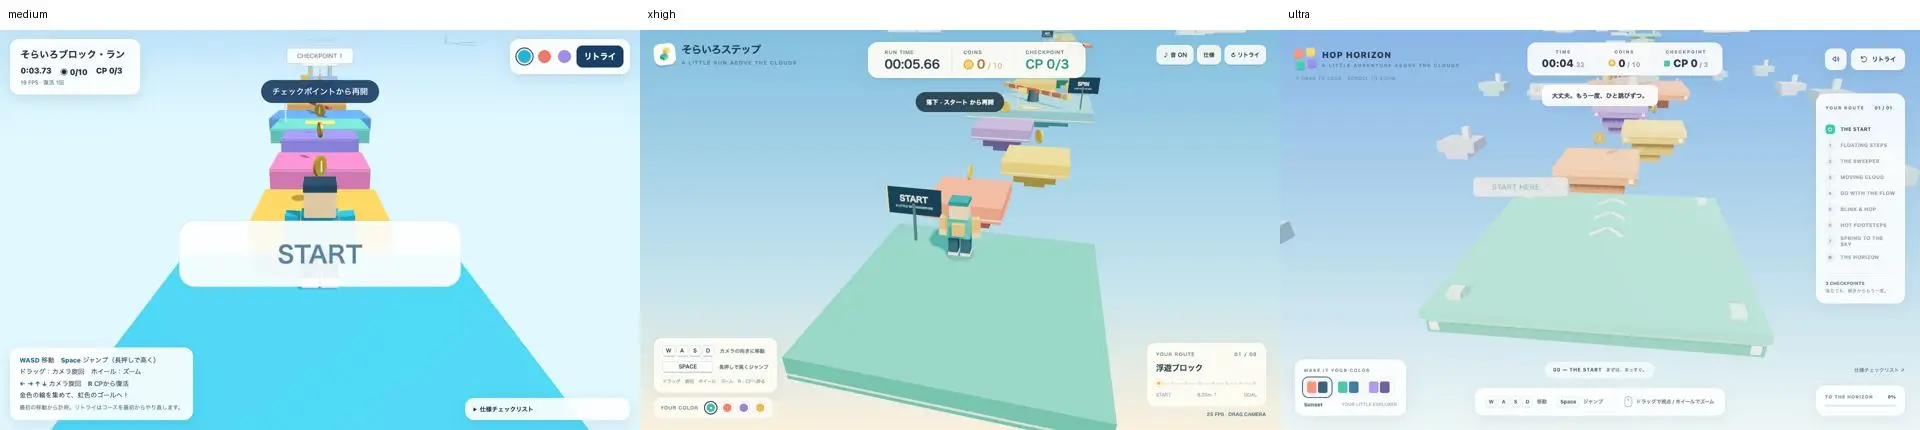
そこで、同じお題(3Dアスレチック)をeffortだけ変えて作らせてみました。mediumなら6.4分で、遊べる形まで出来ています。xhighは画面の作り込みが一段上がりますが、そのぶん4倍以上待つことになります。
| effort | できあがるまでの時間 | 使ったトークン |
|---|---|---|
| medium | 6.4分 | 約2.0万 |
| xhigh | 27.7分 | 約5.3万 |
| ultra | 24.8分 | 約7.8万 |
出典:Routine Labo 検証アリーナでの実測(2026年10月1日・Codex CLI 0.159.3)
ポイント
ふだんの修正や試作はmedium、人に見せる完成品だけxhighに上げるのがおすすめです。その回だけ変えるなら起動時に指定し、いつも同じにするなら設定ファイルに1行書いておきます。
# その回だけ medium で起動する
codex -m gpt-6.1-sol -c model_reasoning_effort="medium"

# いつも medium にする(~/.codex/config.toml に1行)
model_reasoning_effort = "medium"
まとめ
GPT-6.1 Solの要点をまとめます。
- GPT-6 Solと同じ料金のまま中身が新しくなり、キャッシュ入力は半額
- 料金はGPT-6 Astraの5分の1、Claude Opus 5.5の半分
- 総合の賢さはOpus 5.5が上、1タスクの費用はGPT-6.1 Solが約8分の1
- グラフィックやUIのデザインが強く、ゲームの見た目はOpus 5.5より上
- 待ち時間は前のSolの約3倍。ふだんはmedium、完成品だけxhighがおすすめ
見た目やUIを作らせるのはGPT-6.1 Sol、全体の設計や品質を詰める作業はOpus 5.5、という分け方が今のところ現実的です。僕自身も、アプリのUIやUXはGPT系に任せ、その後のコーディングをOpus 5.5に回す形で使っています。
最新のAI情報や活用事例は、公式LINEでも配信しています。ChatGPTの有料プランやCodexを使える方は、ぜひGPT-6.1 Solを試してみてください。

