この記事でわかること
- Grok 4.7の特徴と基本スペック
- OpenRouterやCursorでの使い方
- 料金の安さとトークン量の落とし穴
- ゲームと文章で分かった得意・不得意
「僕が実際にGrok 4.7で2Dアクションゲームを作らせたら、ほかのモデルの約3倍、1500秒ほどかかりました」
SpaceXAI(旧xAI)から、新しいモデル「Grok 4.7」がリリースされました。Grok 4.6が出たときにイーロン・マスクさんが「4.7はすごいことになる」と発信していたので期待していましたが、結論から言うと、そこまで大きな進化ではありませんでした。ただ、場面によってはしっかり使えるモデルです。
こんにちは、ルーティンラボ(@rutinelabo)です。本記事では、リリースから約1週間使ってみたGrok 4.7の料金・スペック・ベンチマークを整理し、ゲームや文章を実際に作らせて分かった向き・不向きをまとめます。
プロンプト配布中
LINE公式アカウントを友達追加していただければ、本記事やYouTubeで使用した使用したプロンプトを配布いたします。メンバーシップ登録で優先サポートも実施中です。
Grok 4.7とは|料金据え置きで長い作業と資料づくりが得意に
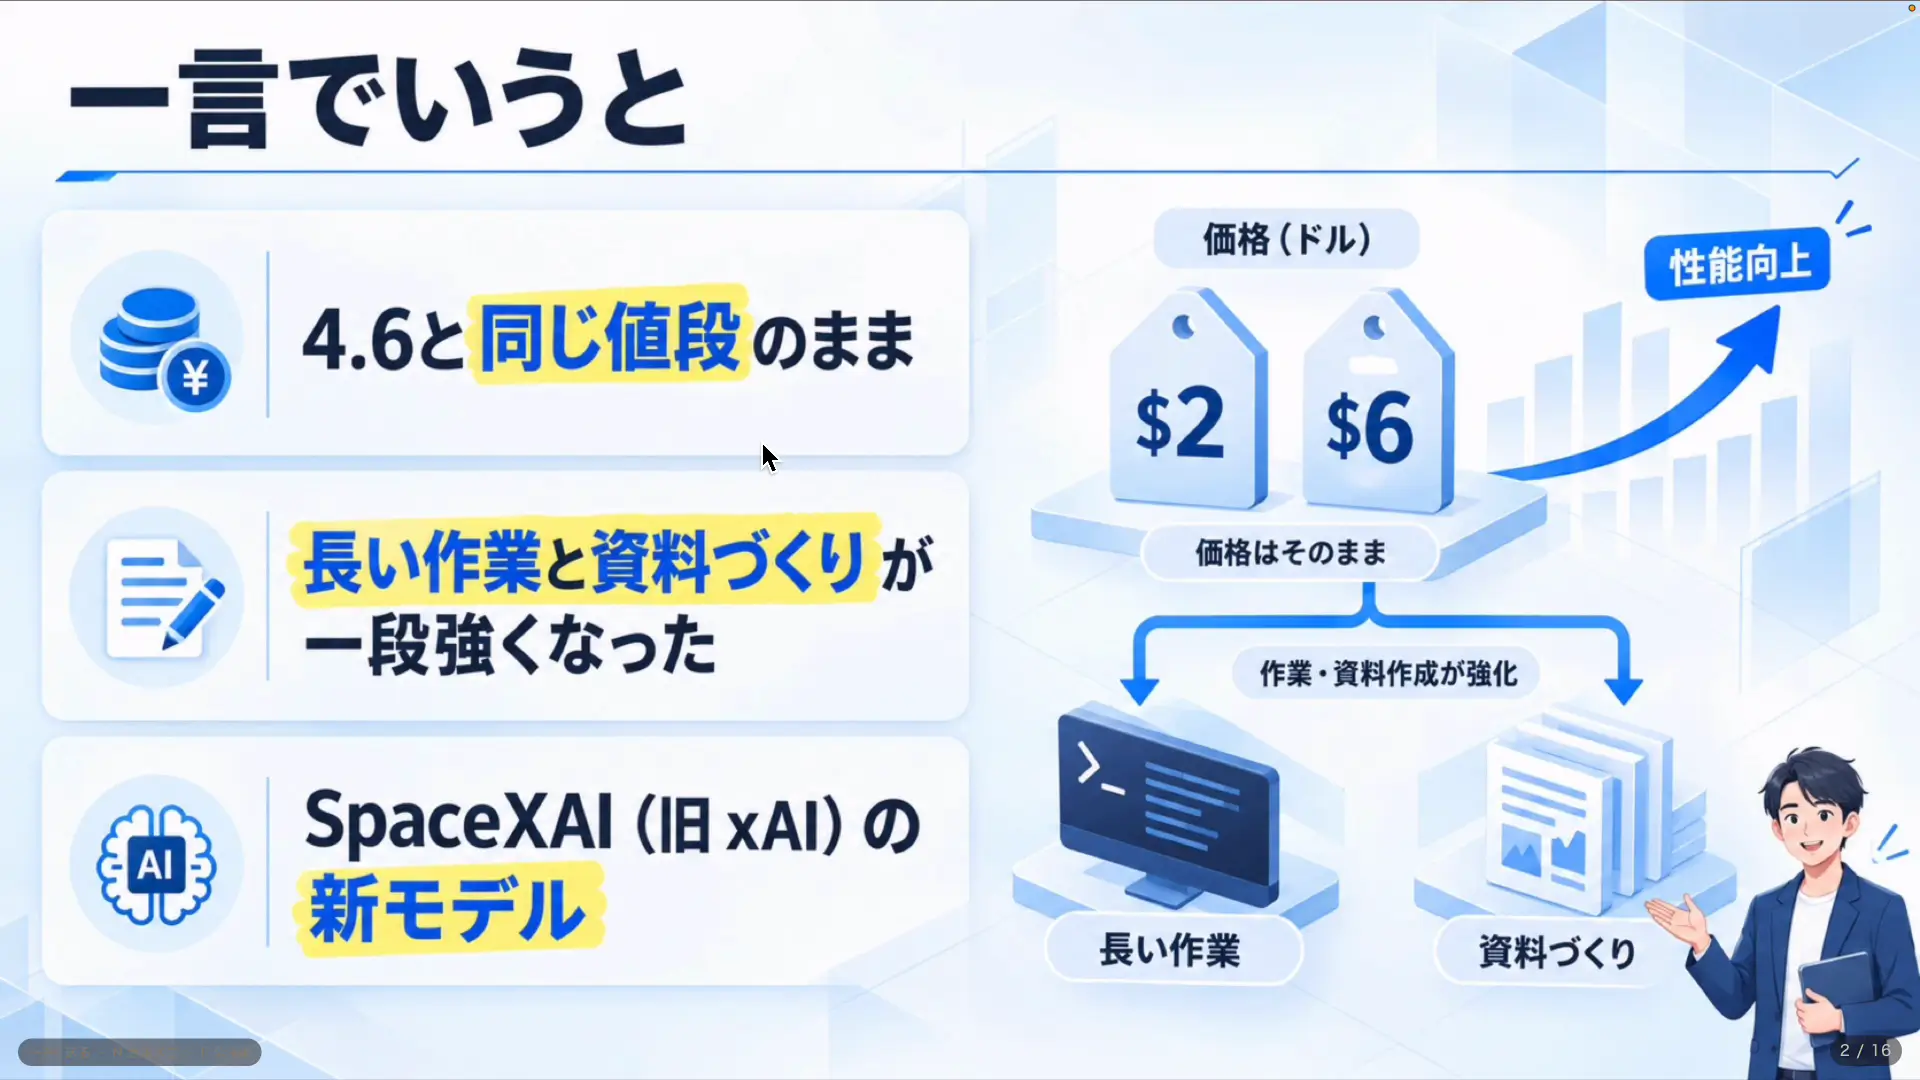
Grok 4.7は、SpaceXAIが日本時間の2026年9月22日にリリースした最新モデルです。前のGrok 4.6と料金は同じまま、性能だけが上がったという位置づけです。公式は、長い時間をかけて進める作業(ロングラン)と、文書・プレゼンなどの資料づくりが得意になったと紹介しています。
一度に読み込める量(コンテキスト)は50万トークンです。100万トークンを扱えるモデルが増えてきた今では、少し控えめな容量と言えます。入力はテキストと画像に対応していますが、出力はテキストだけです。画像や動画を作るときは、別モデルのGrok Imagineを使います。
| 項目 | Grok 4.7 |
|---|---|
| リリース | 2026年9月21日(米国)=日本時間9月22日 |
| コンテキスト | 50万トークン(4.6と同じ) |
| 入力 / 出力 | テキスト・画像 / テキストのみ |
| 推論の強さ | low / medium / high(既定)/ xhigh の4段階 |
| API料金(100万トークン) | 入力$2 / 出力$6(4.6から据え置き) |
出典:SpaceXAI 公式発表・xAI Docs(2026年9月時点・公式参照)
前のバージョンの実力はGrok 4.6を実機検証|9課題でGPT-5.6と比較した速度と料金の落とし穴で検証しています。4.6からどれだけ変わったかを見比べたい方は、あわせてどうぞ。
-
-
Grok 4.6を実機検証|9課題でGPT-5.6と比較した速度と料金の落とし穴
続きを見る
Grok 4.7が使える場所|OpenRouter・Cursor・Grok Build
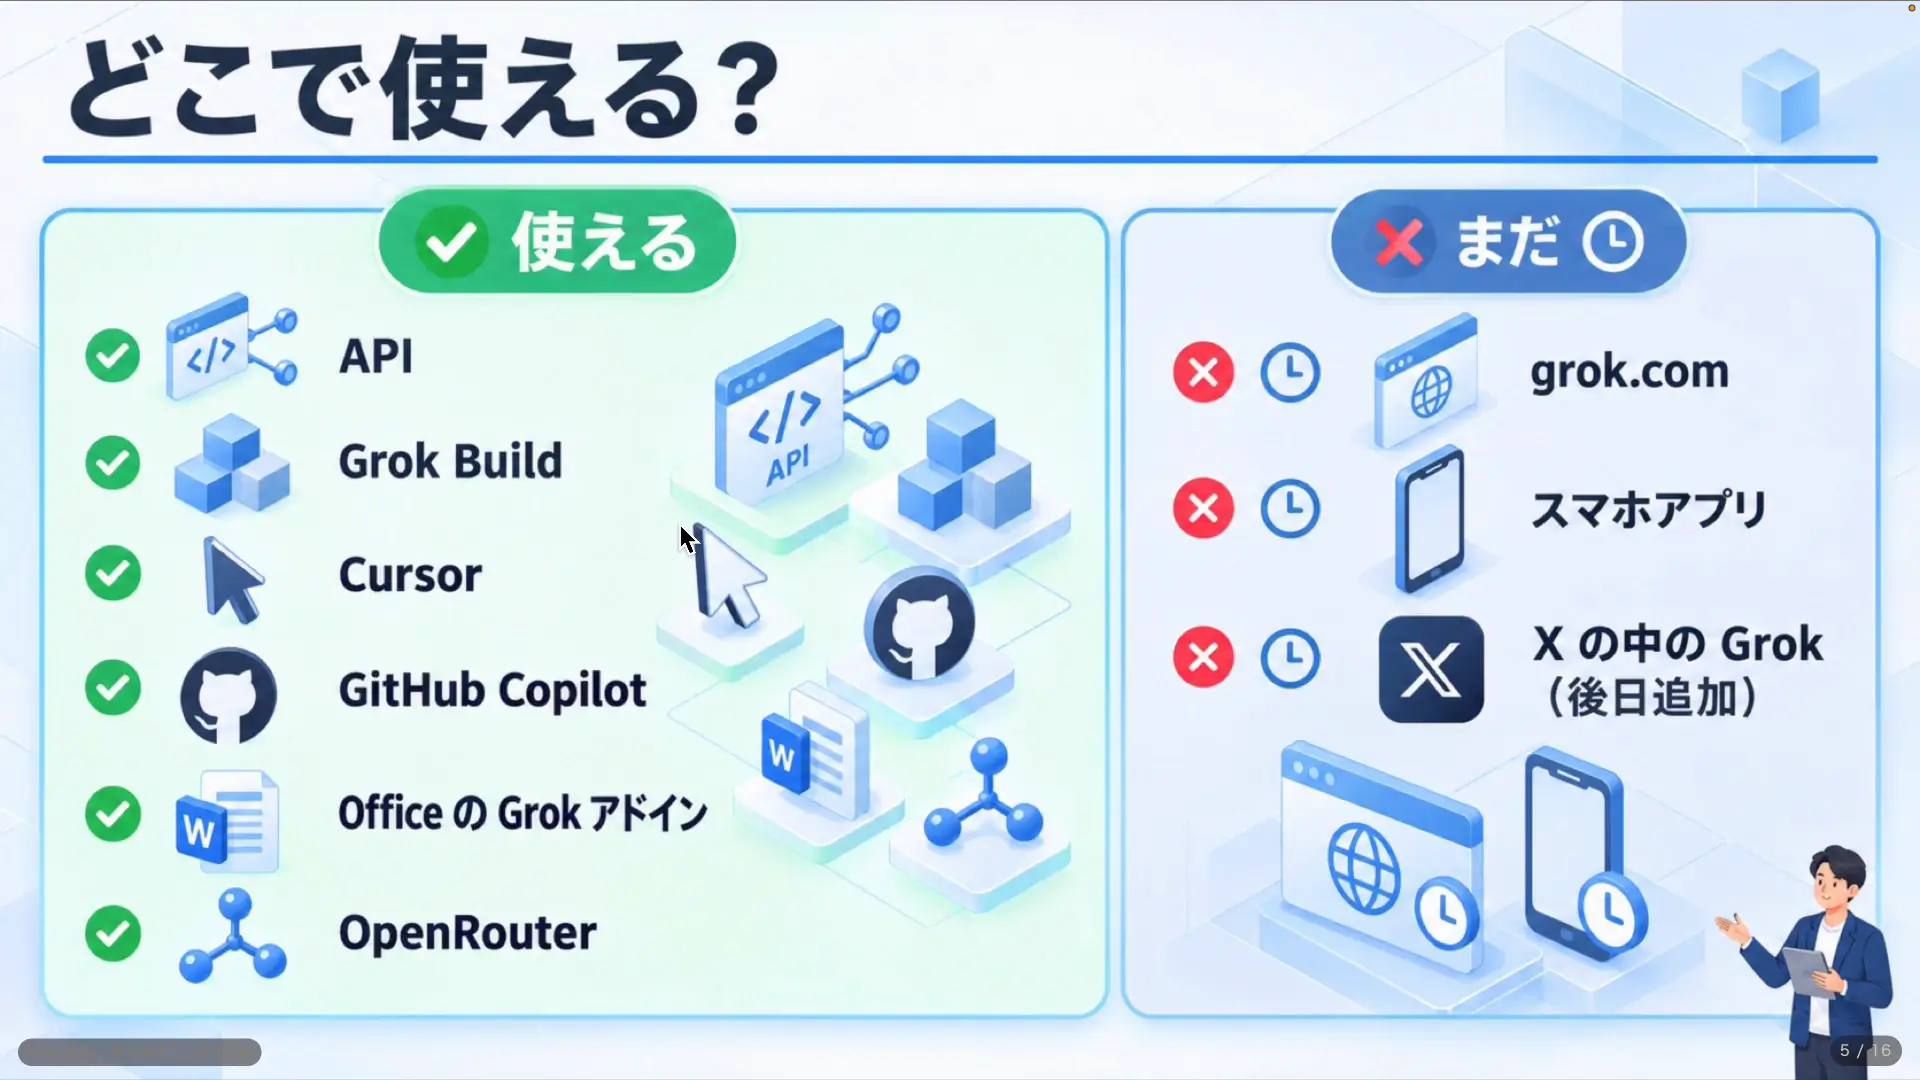
Grok 4.7は、APIのほか、Grok Build、Cursor、GitHub Copilot、OfficeのGrokアドイン、OpenRouterなどから使えます。一方で、grok.comやスマホのGrokアプリ、Xの中のGrokでは、まだ提供されていません(公式は「後日追加」としています)。アプリで試そうとして見つからない方は、ここで迷いやすいので注意してください。
僕自身は、新しいモデルを試すときはOpenRouterからAPIを従量課金で使っています。OpenRouterは、さまざまな会社のモデルを1つのAPIキーで呼び出せるサービスです。Fable 5.1やGPT-6 Astraのようにがっつり使うモデルは公式のサブスクに入るほうがお得ですが、月額を払うほどは使わないモデルを試すなら、従量課金のほうが無駄がありません。
step
1OpenRouterでAPIキーを作る
OpenRouterにログインし、APIキーを発行します。使った分だけ支払う形なので、最初は少額のクレジットを入れておけば十分です。
step
2モデル一覧からGrok 4.7を選んで呼び出す
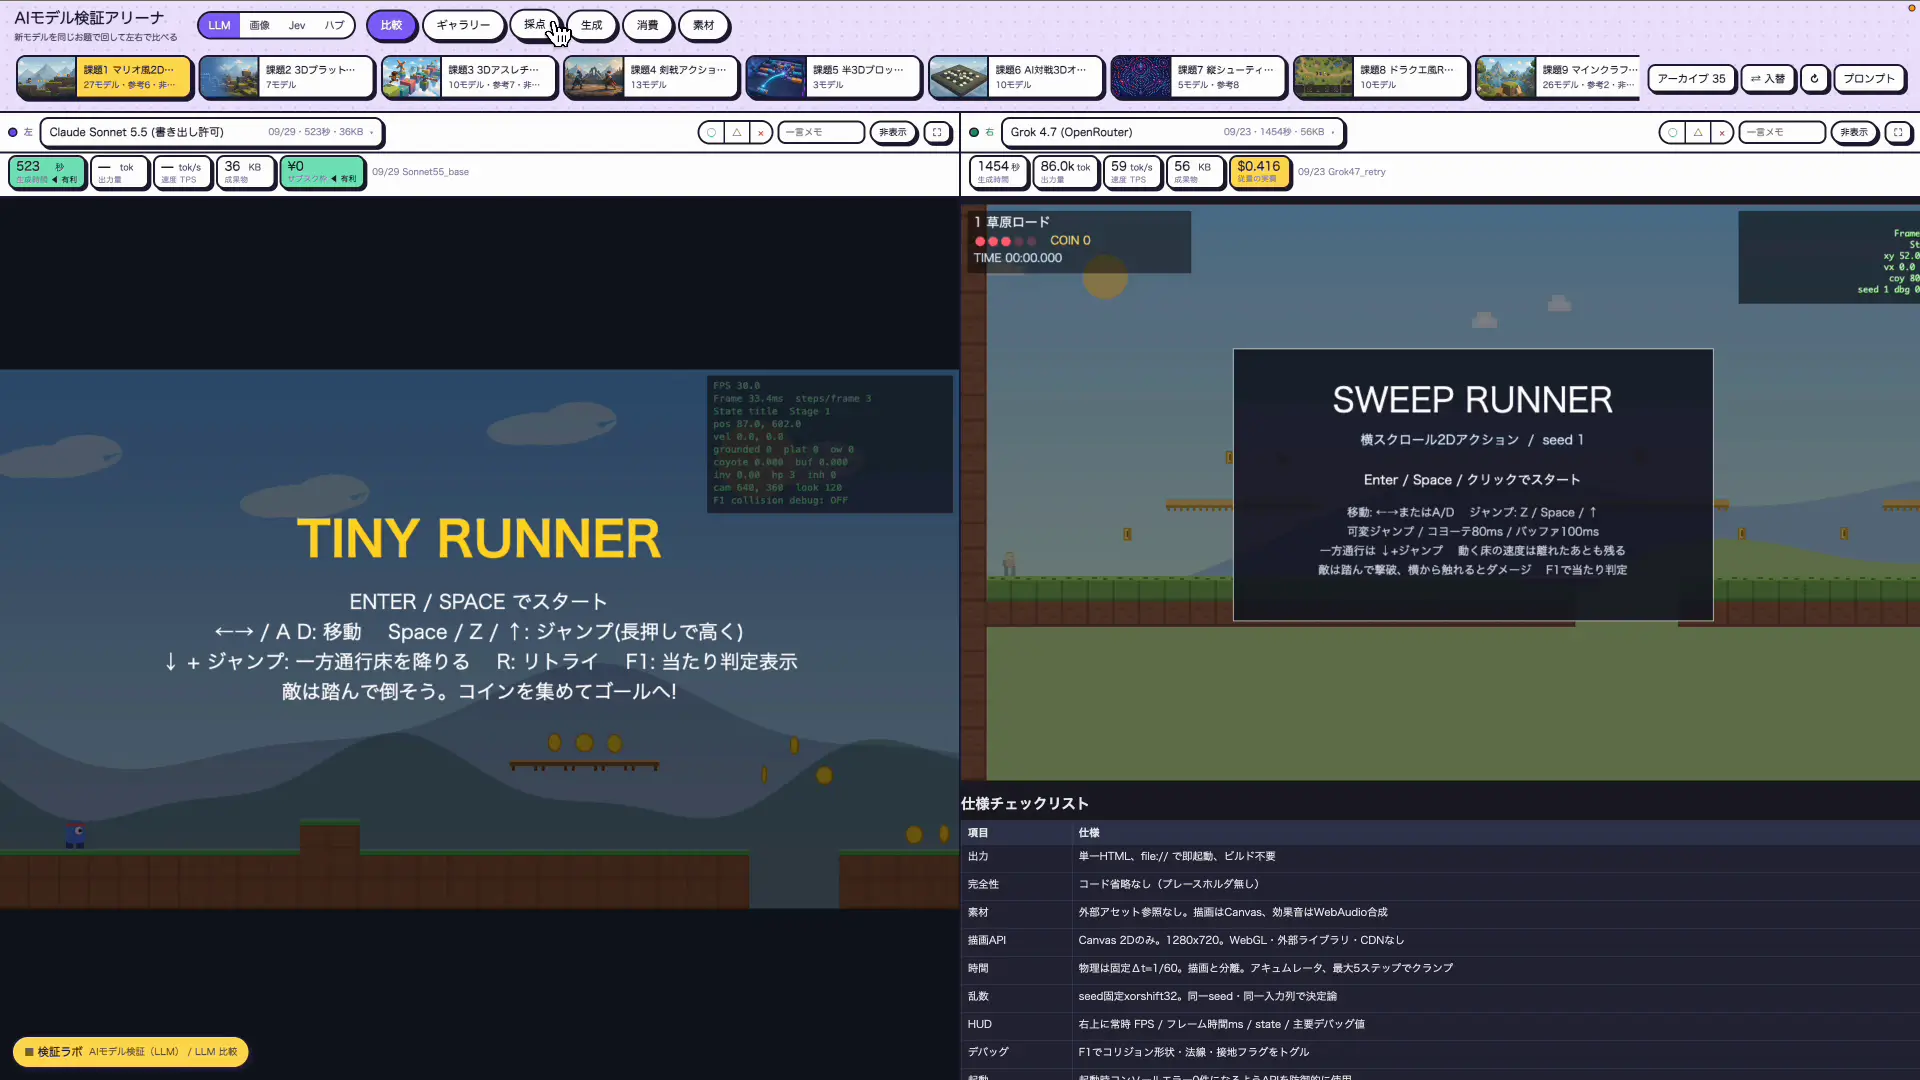
モデル一覧でGrok 4.7を選び、普段使っているCLIや自作のツールから呼び出します。僕はAIモデルの検証用ツールから、複数のモデルを一括で切り替えて同じお題を作らせています。
モデルごとに各社のサービスへ登録していたら、費用がかさむ一方です。いろいろなモデルを試したい方ほど、APIをまとめて使える仕組みが役に立ちます。また、GrokのモデルはCursorとの相性も良さそうです。Cursorはデスクトップアプリに加えてスマホアプリとも連携しているので、外出先からGrok 4.7を使う形も試しやすいと感じました。
生成時間は約3倍|同じお題で並べて分かったこと
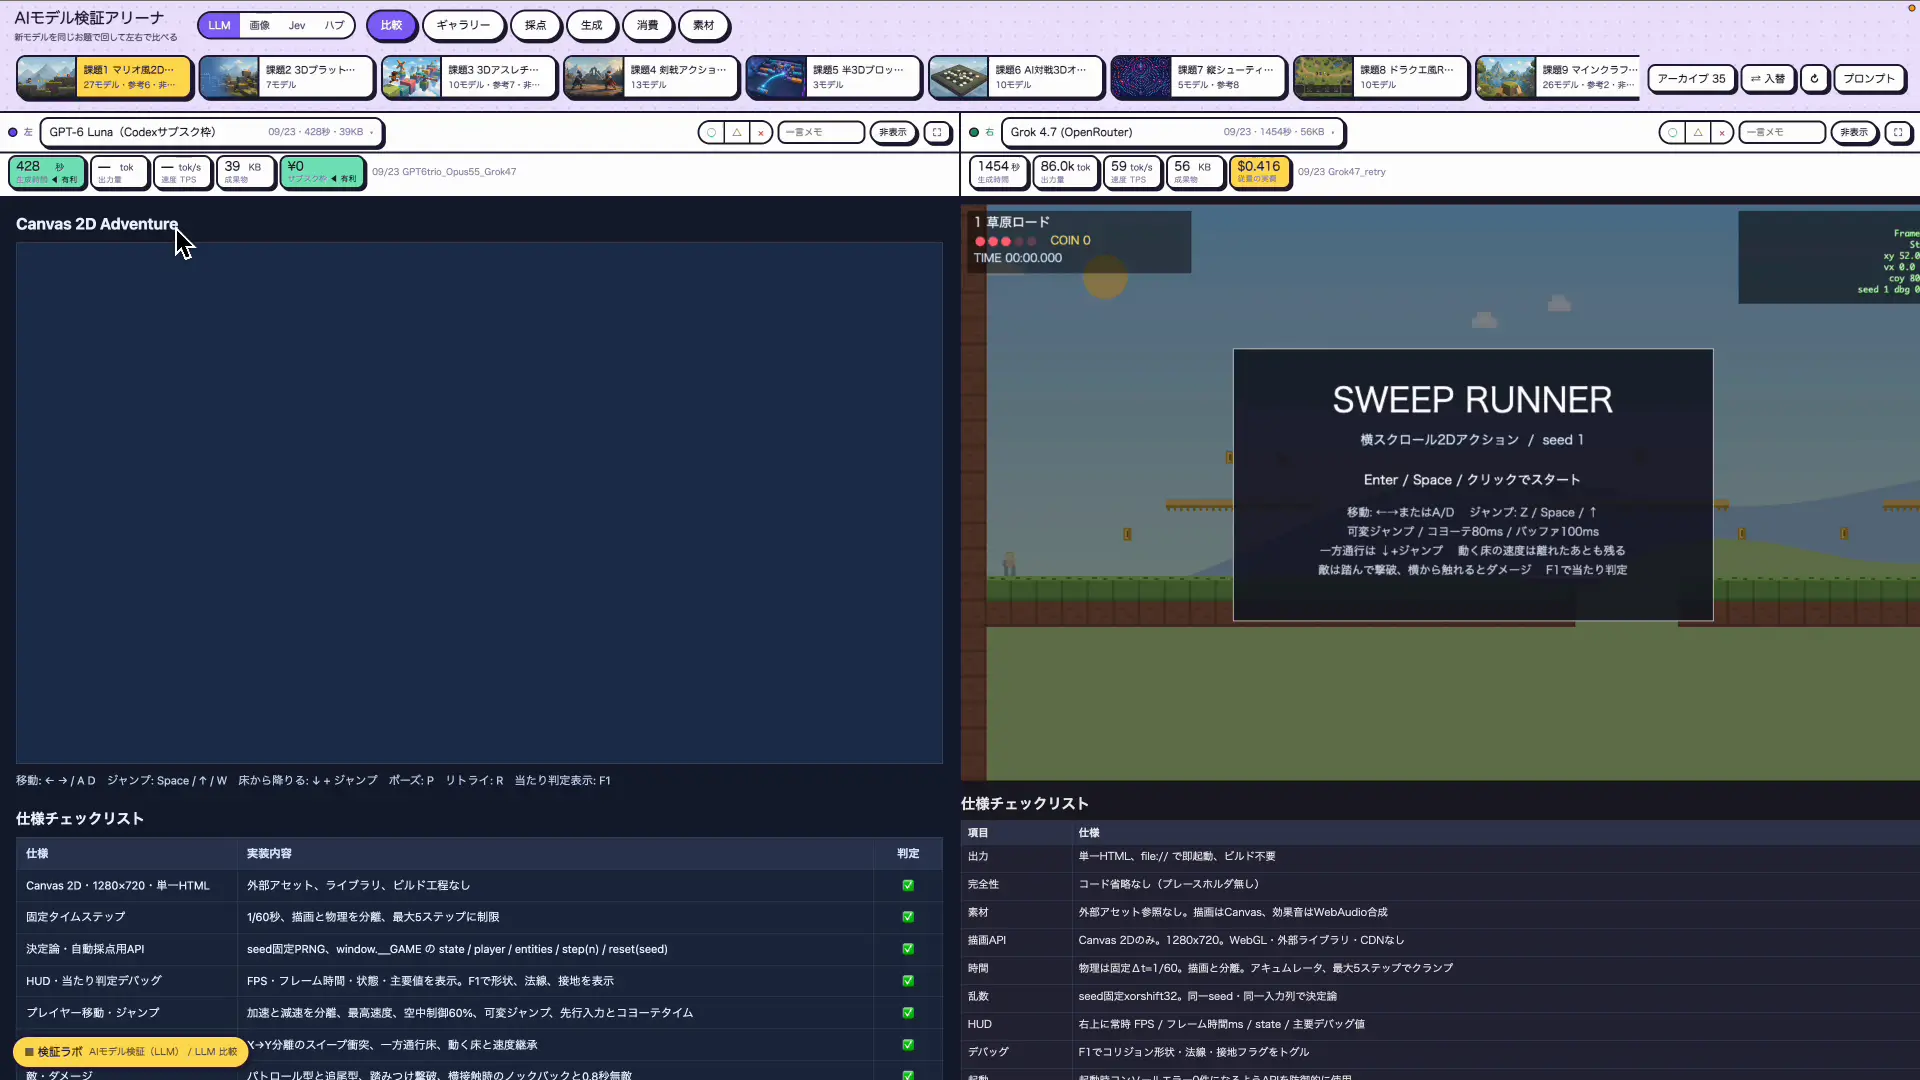
検証ツールで、同じ2Dアクションゲームのお題をいくつかのモデルに作らせて並べました。そこで一番特徴的だったのが生成にかかる時間です。GPT-6 LunaやClaude Opus 5.5と比べると、Grok 4.7は約3倍の時間がかかっていました。
正直、遅かった。Grok 4.7 に同じお題の2Dアクションを作らせたら、ほかのモデルの約3倍の時間。
速さより作り込みに時間を使うタイプで、単価は安くても1タスクで使う量は多め。
速さ重視なら候補から外す。じっくり作る回だけ使う!
#Grok47
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
ゲーム自体は頑張って作ってくれているものの、品質は決して高いとは言えない仕上がりでした。時間をかけて作り込むタイプのモデルなので、生成の速さを求める用途には向きません。公式の「長い作業が得意」という説明は、裏を返せば1つのタスクに時間を使う設計だと受け取るのがよさそうです。
ポイント
ジャンル的には、Gemini 3.8 FlashやQwen・GLMのFlash系と同じ「軽めのモデル」の位置づけに見えますが、作業時間は軽くありません。速さを重視するなら、ほかのモデルと比べてから選んでください。
Grok 4.7のベンチマーク|電気工学と法務で強い
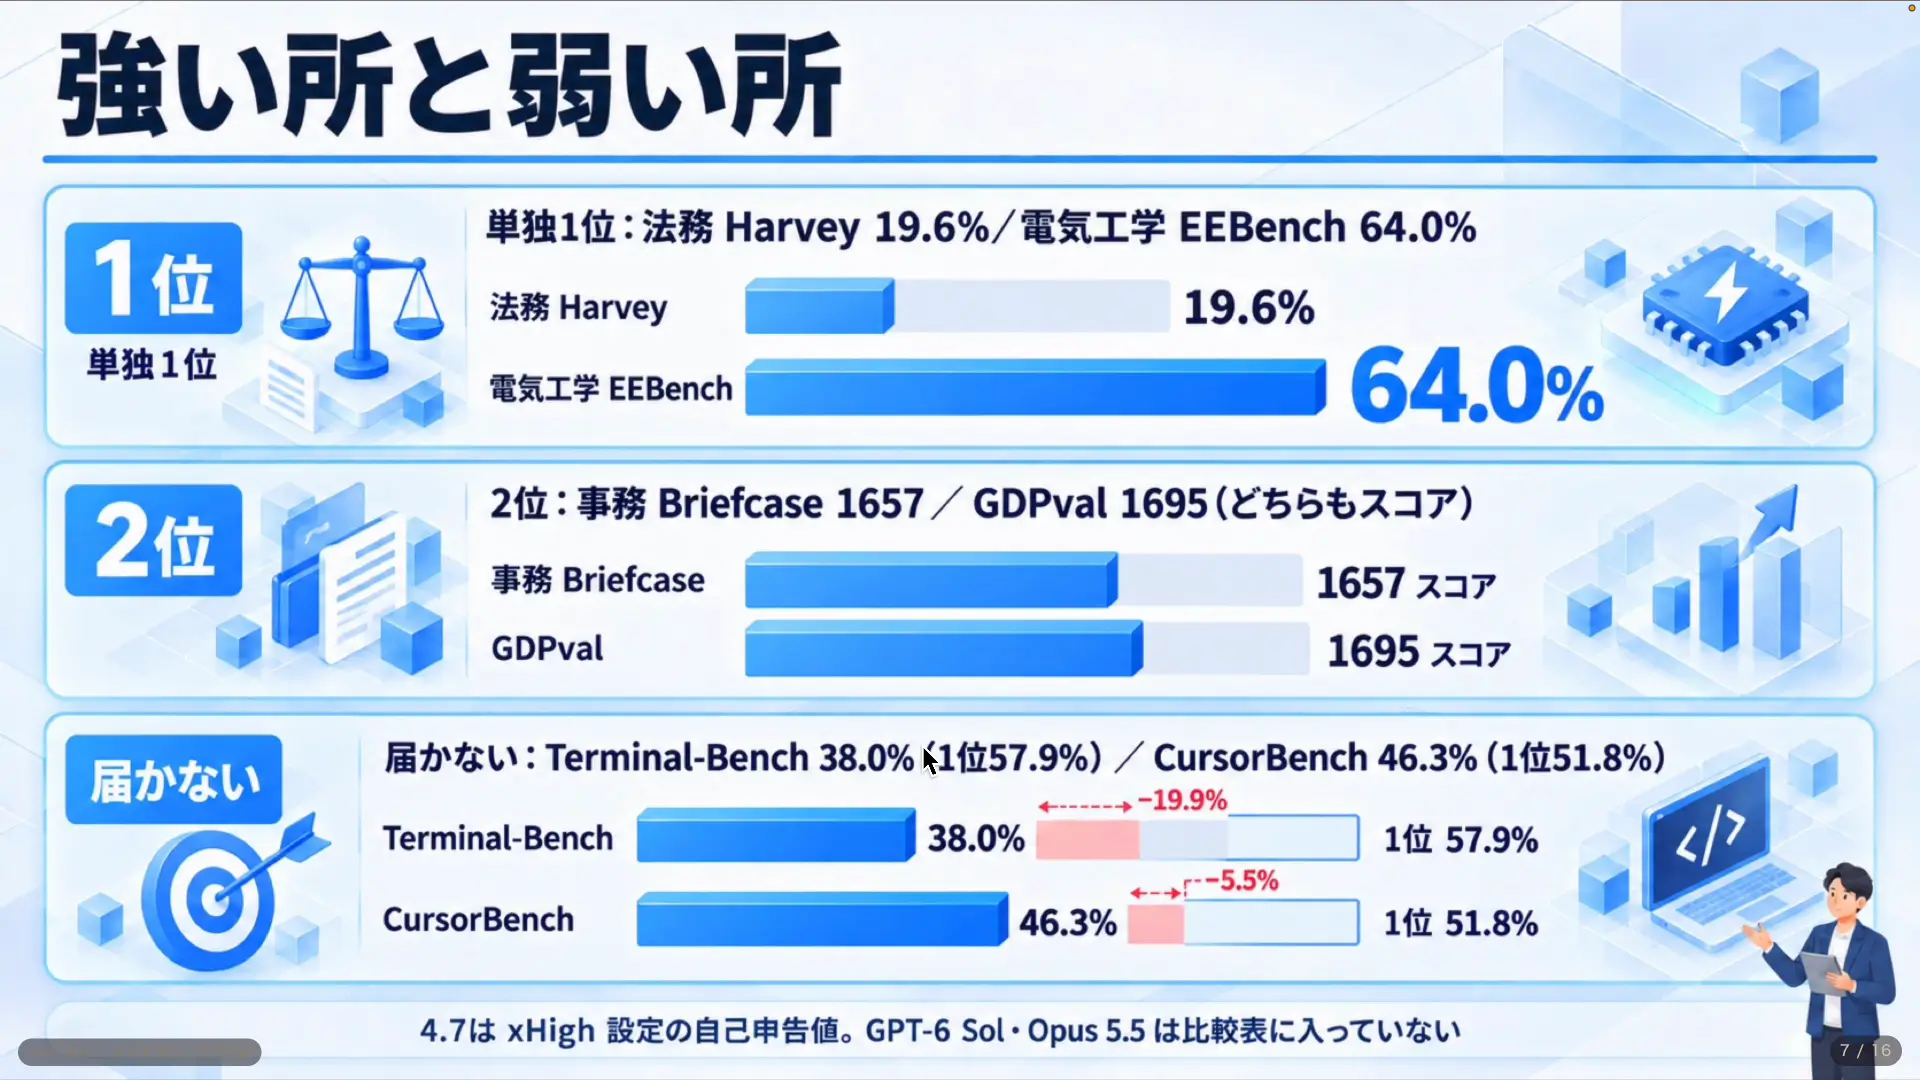
Grok 4.7は、強いところと弱いところがはっきり分かれるモデルです。公式の比較表では、電気工学のエージェント評価(EEBench)と、法務の作業を測るHarvey Legal Agentで、GPT-5.6 SolやFable 5.1を上回りました。こうしたジャンルの作業をよくする方は、試してみる価値があります。
| ベンチマーク | Grok 4.7 | Grok 4.6 | Fable 5.1 |
|---|---|---|---|
| EEBench(電気工学) | 64.0 | 53.0 | 56.4 |
| Harvey Legal Agent(法務) | 19.6 | 15.8 | 6.7 |
| Terminal-Bench 4.0(長い作業) | 38.0 | 20.3 | 57.9 |
| CursorBench 4.0 | 46.3 | — | 51.8 |
出典:SpaceXAI 公式発表の比較表(2026年9月時点・公式参照)
一方で、Terminal-BenchやCursorBenchでは上位のモデルにまだ届いていません。第三者の評価でも、Artificial Analysisの総合指数は46で、首位のClaude Opus 5.5(58)とは差があります。人の投票で順位を決めるArenaでも、テキストは92位、Web開発は13位でした(いずれも1位はClaude Opus 5.5)。
出典:Artificial Analysis・Arena(2026年9月29日時点)
Grok 4.7の料金|単価は安いがトークン量に注意
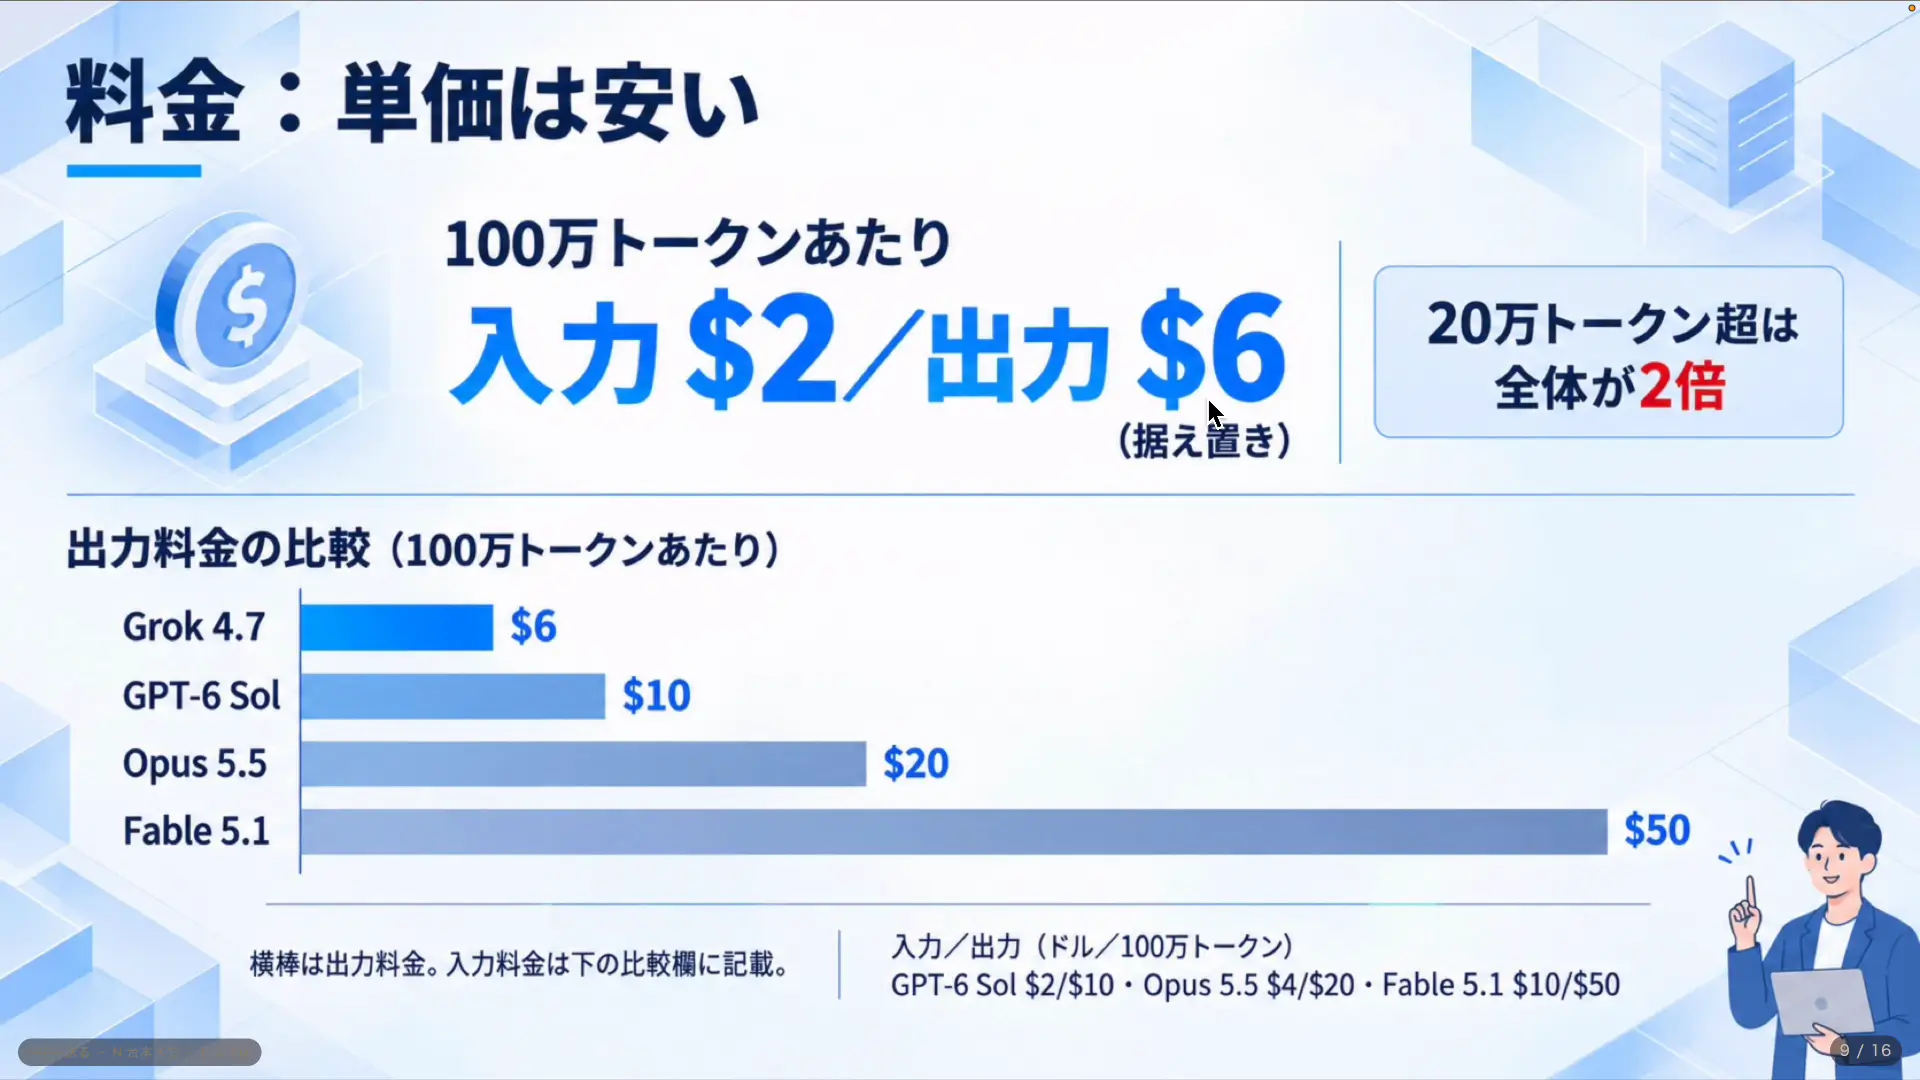
料金は、100万トークンあたり入力2ドル・出力6ドルで、Grok 4.6から据え置きです。同じ週に出たモデルと比べても、出力の単価はかなり安い部類に入ります。
| モデル | 入力(100万トークン) | 出力(100万トークン) |
|---|---|---|
| Grok 4.7 | $2 | $6 |
| GPT-6 Sol | $2 | $10 |
| Claude Opus 5.5 | $4 | $20 |
| Fable 5.1 / GPT-6 Astra | $10 | $50 |
出典:xAI Docs(Pricing)・Simon Willison's Weblog(2026年9月時点)。20万トークンを超えるリクエストは、全体が入力$4・出力$12になります。
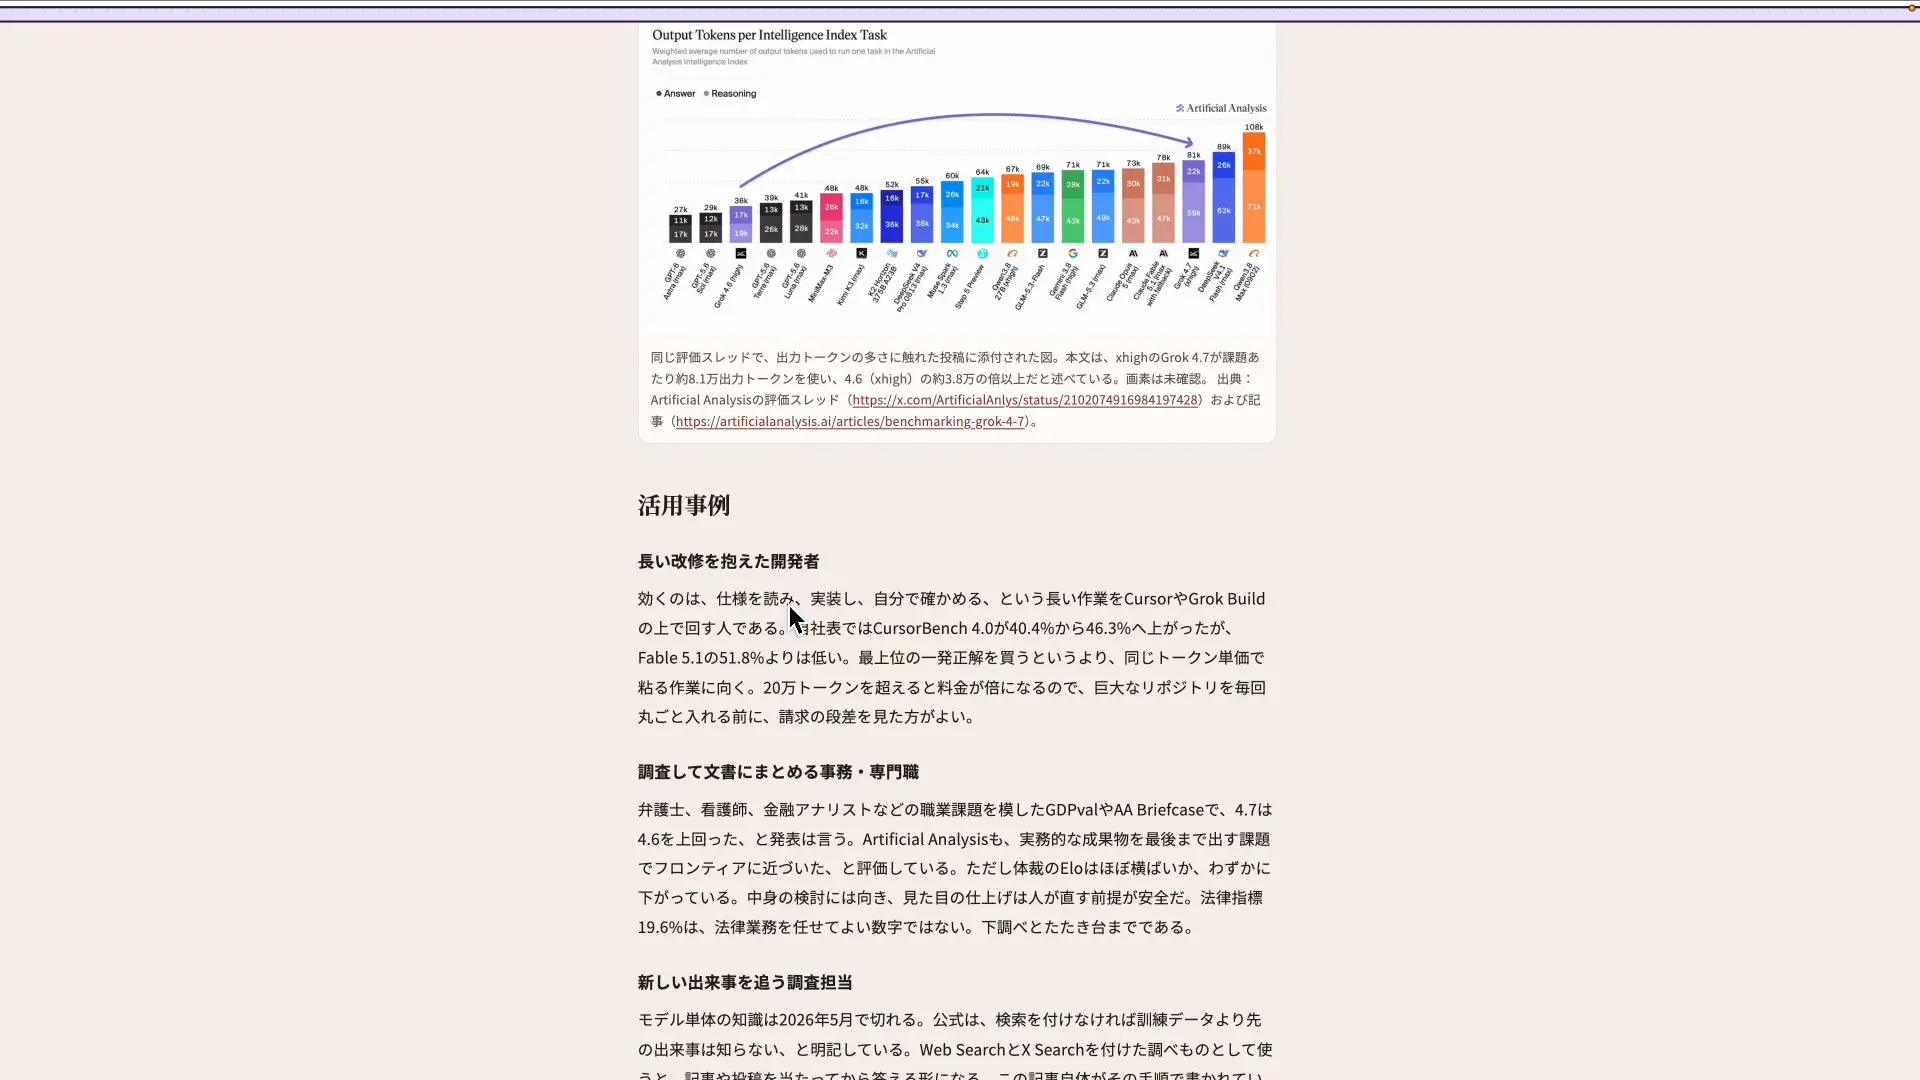
ただし、単価が安いからといって、とことん安く使えるとは限りません。Grok 4.7は1つのタスクに時間をかけるぶん、書き出すトークンの量も増えます。Artificial Analysisの計測では、1タスクあたりの出力が約8.1万トークンで、4.6(約3.6万)の2倍以上でした。1タスクあたりの費用で見ると、Grok 4.7(xhigh)が3.74ドル、GPT-6 Solが1.05ドルです。
使ってみてクレジットやトークンの減りが激しいと感じたら、APIの従量課金から、Cursorなどのサブスクで使う形に切り替えるのも手です。モデルを選ぶときは、単価ではなく「1タスクいくらか」で比べるのがおすすめです。
2Dアクションの作例|約1500秒かかった
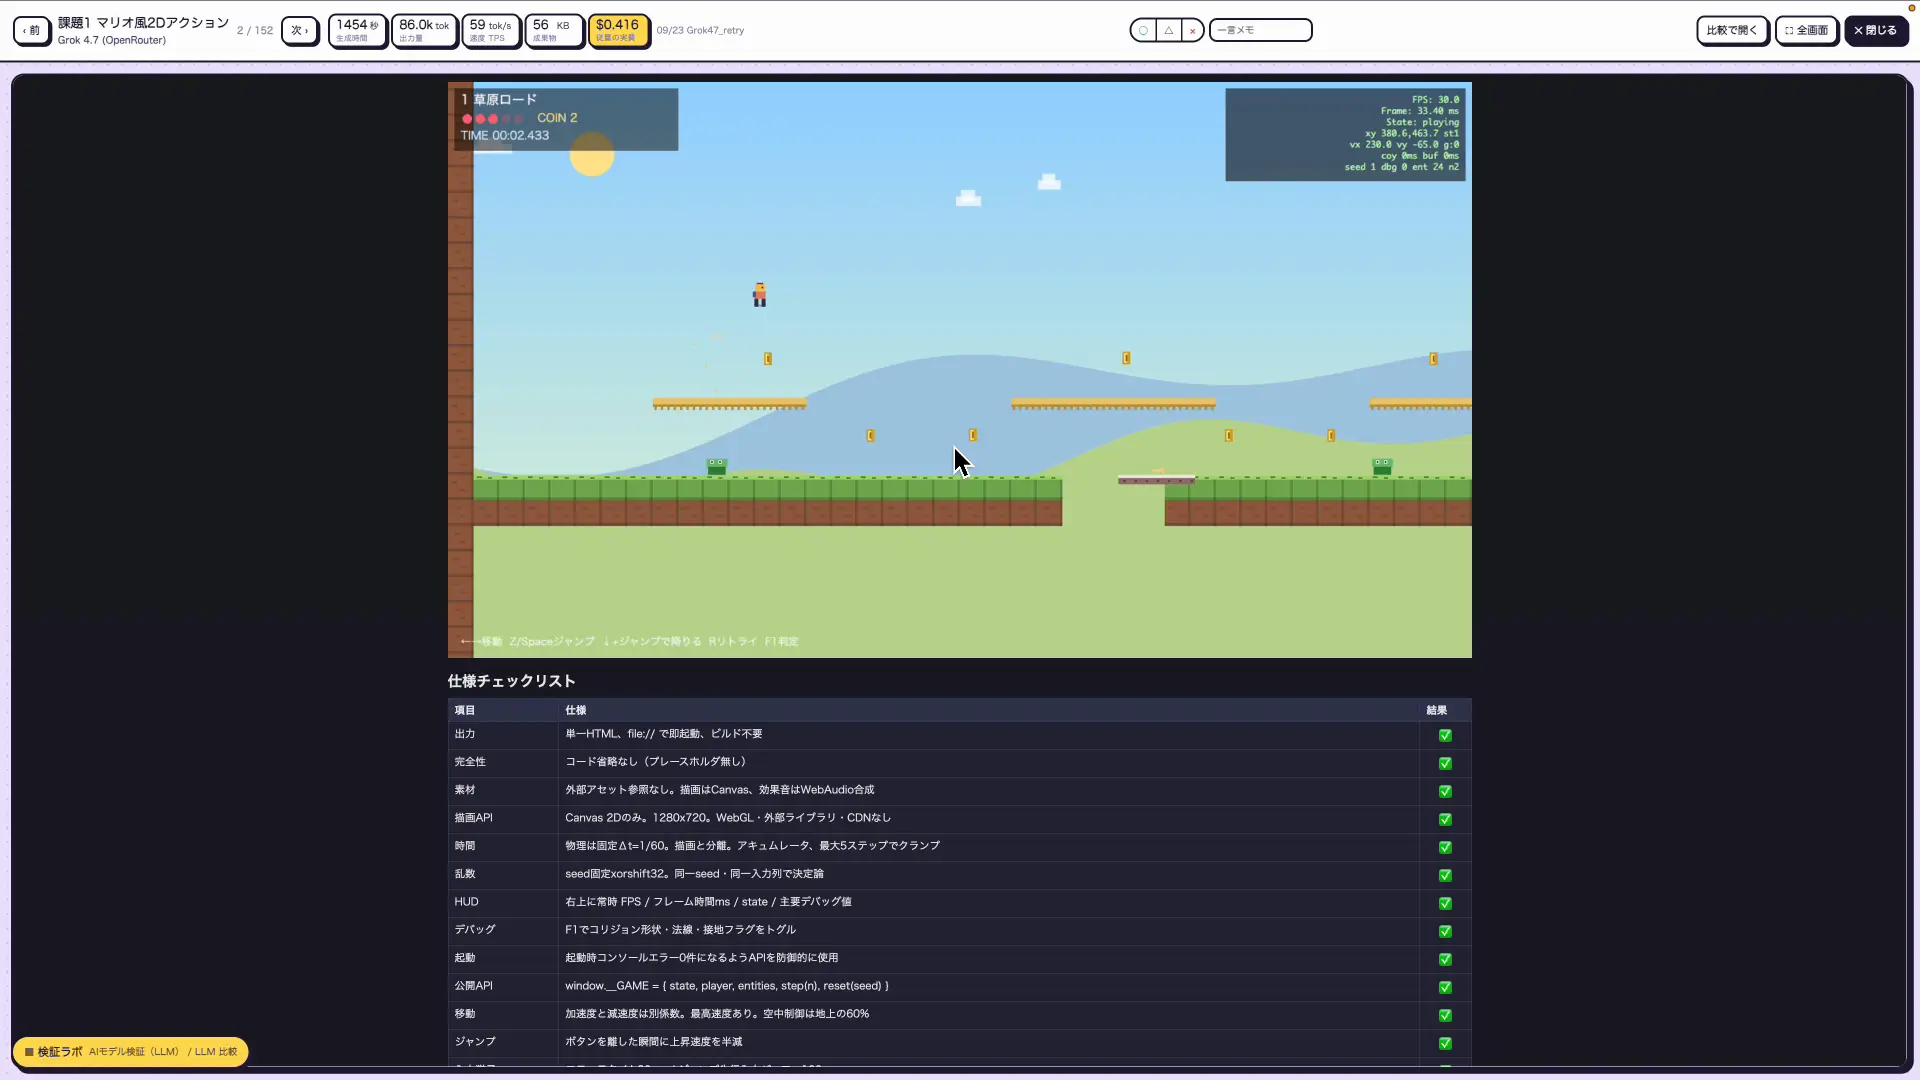
ここからは、実際に作らせたものを見ていきます。まずは2Dアクションゲームです。正直なところ品質はあまり高くなく、それでいて完成までに約1500秒かかりました。時間に見合った出来とは言いにくい結果です。
3Dアスレチックの出来|遊べるが少しカクつく
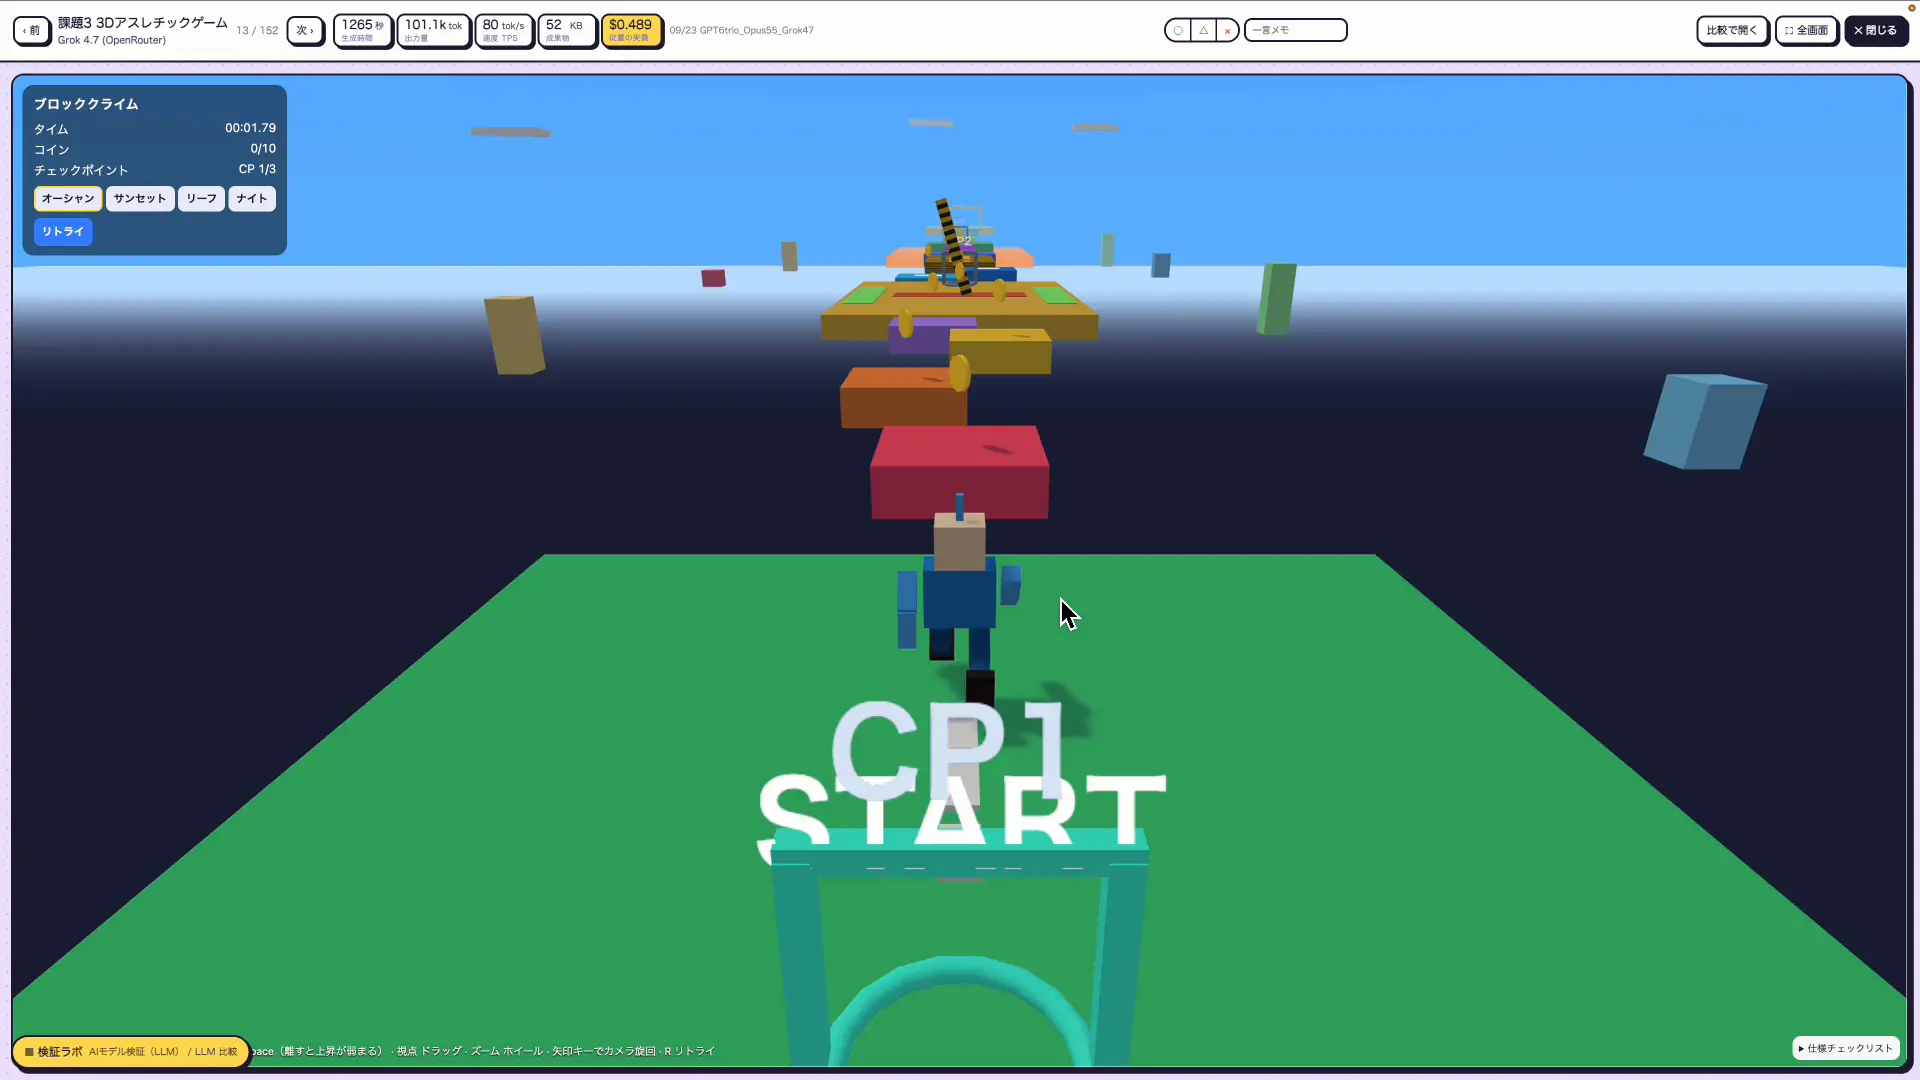
3Dのアスレチックゲームは、足場を渡ってゴールを目指す形でしっかり動きました。だいぶ精度は出せるようになっていて、遊べるレベルとしては問題ありません。
Grok 4.7に3Dのアスレチックゲームを作らせてみました。
・足場を渡ってゴールを目指す形で、遊べるレベルで動く
・ただ、ところどころカクつく
・作り込みはもう一歩#Grok47 #AIゲーム制作
3Dゲームを作るなら、どのモデルを選びますか?
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
ただ、ところどころゲームがカクつく場面がありました。3Dの作り込みについては、モデルの性能がまだ追いついていない印象です。手軽に遊べる試作を作る用途なら十分ですが、完成度を求めるなら上位のモデルに任せたほうが安心です。
マイクラ風・スマブラ風の作例|差が出にくいお題と出るお題
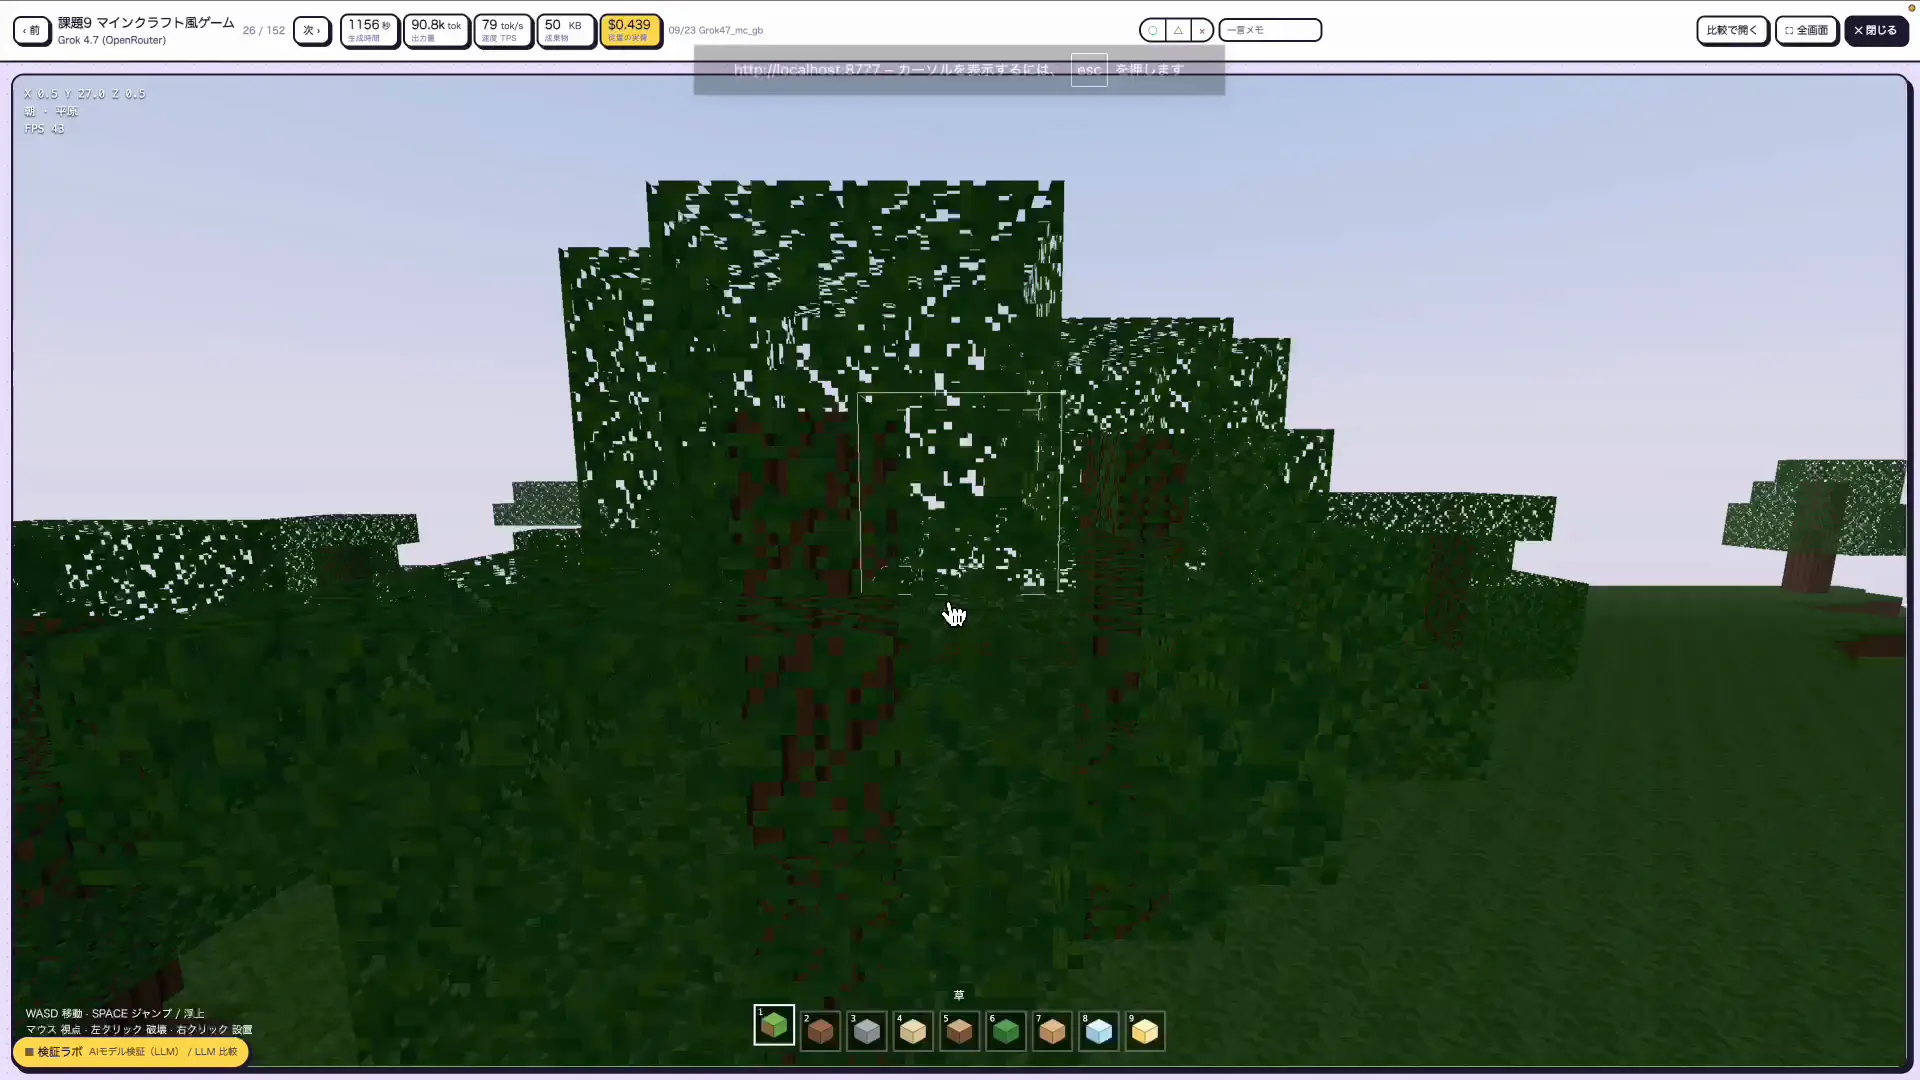
マインクラフト風のゲームは、ほとんどのモデルが問題なく作れるお題なので、Grok 4.7でも大きな差は出ませんでした。品質は中くらいで、それなりに表現してくれています。動作が少し重く感じたのは、僕のパソコンの負荷もあったかもしれません。
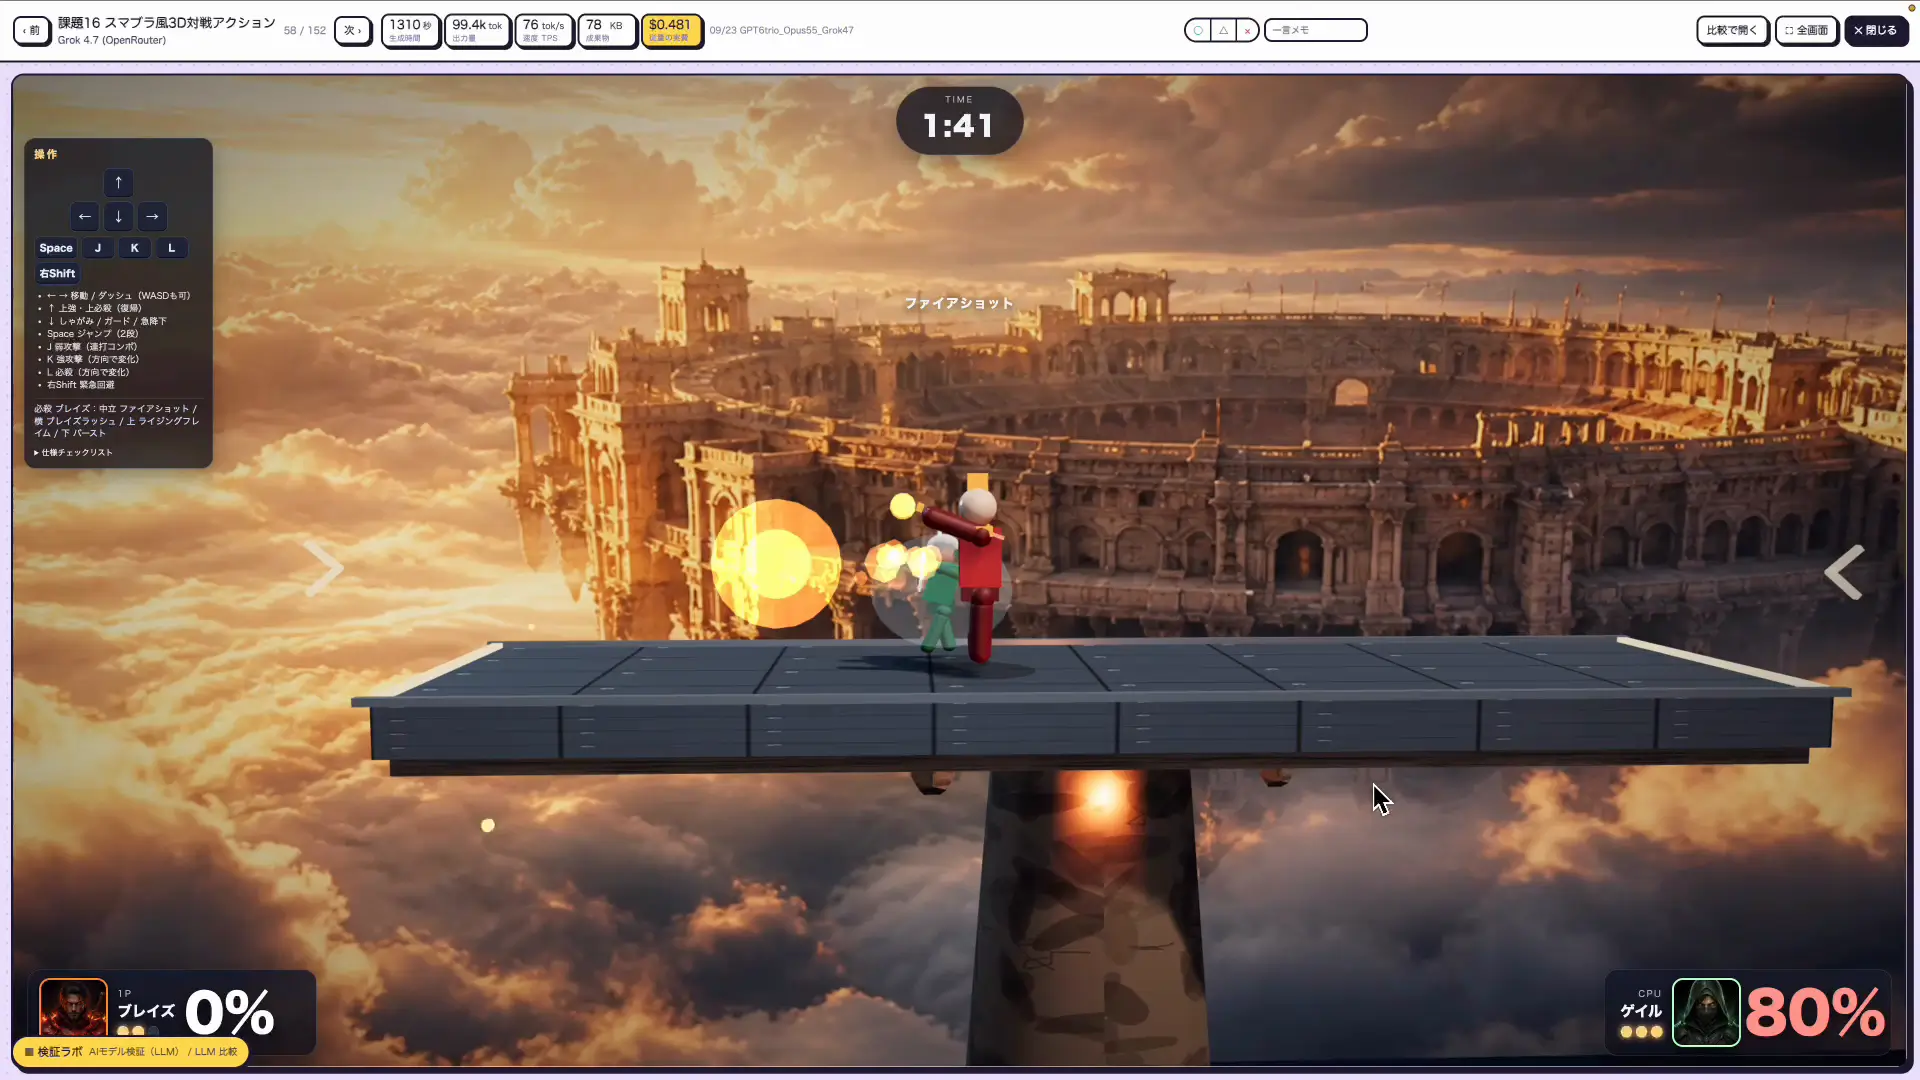
大乱闘スマッシュブラザーズ風のゲームでは、コースの設計や、場外に飛ぶと画面が暗転する演出まで入っていました。ただ、品質の高いOpusやFableで作ると4人で遊べる形まで仕上がるのに対し、Grok 4.7は対戦相手が1人だけの設計でした。
ブログ執筆の実力|公式画像を引用した読みやすい文章
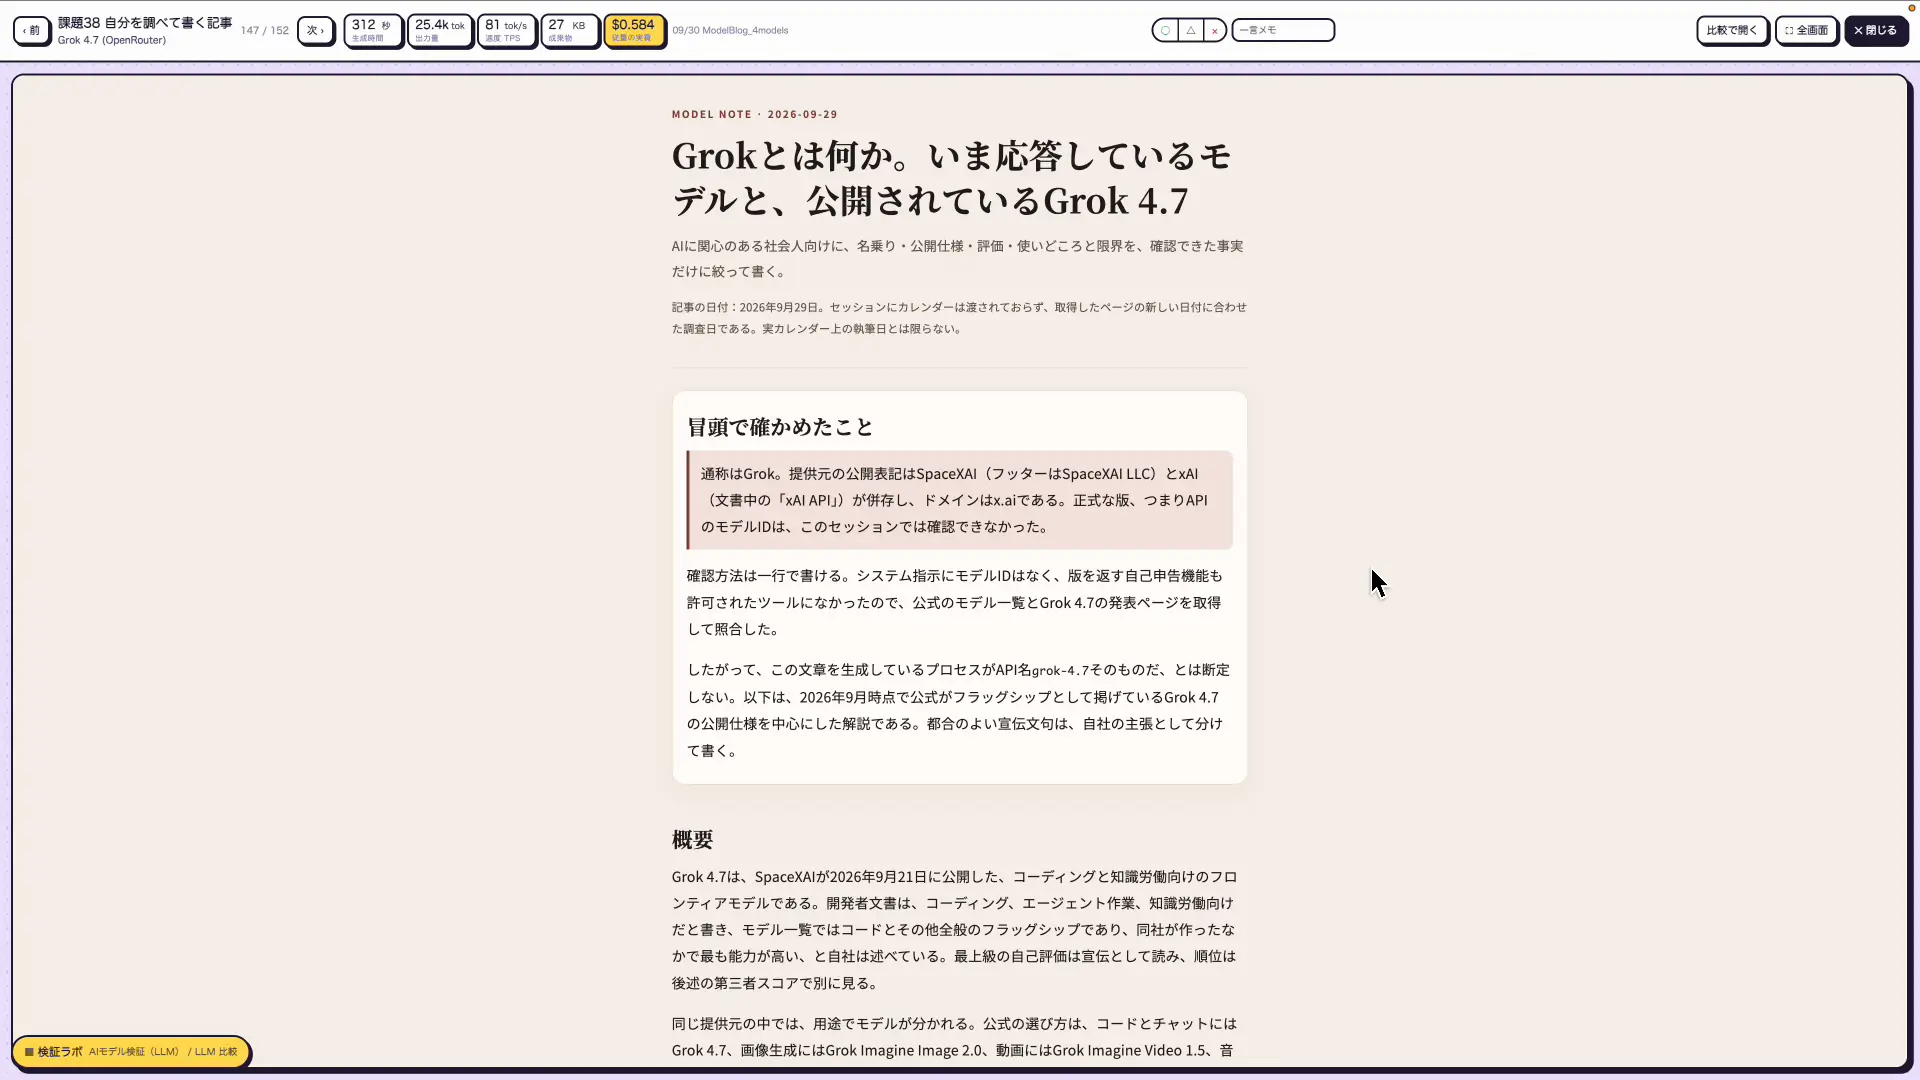
ゲームのほかに、「自分自身(Grok 4.7)についてのブログを書いて」という文章生成も試しました。すると、公式から画像を取ってきて貼り付け、引用まで入れた記事を書いてくれました。
ちょっと意外だったのが Grok 4.7 のブログ生成。
「自分について書いて」と頼んだら、公式の画像を取ってきて引用まで入れてきた。段落も読みやすい。
軽めのモデルとしては十分。僕なら叩き台に使って、仕上げは別のモデルに渡す。
#Grok47
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
段落でしっかり区切ってあり、文章も読みやすく仕上がっています。文章の作り方のレベルは、かなり上がったと感じました。文章生成ではClaude Opus 5.5のほうが一歩上ですが、軽めのモデルで文章を作りたいときには、Grok 4.7も候補に入ります。
同じ週に出たClaude Opus 5.5の文章力はClaude Opus 5.5とは|Fable 5.1並みの性能を4割の料金で使えるで比べています。
-
-
Claude Opus 5.5とは|Fable 5.1並みの性能を4割の料金で使える
続きを見る
苦手だったこと|鬼ごっこゲームは操作が逆に
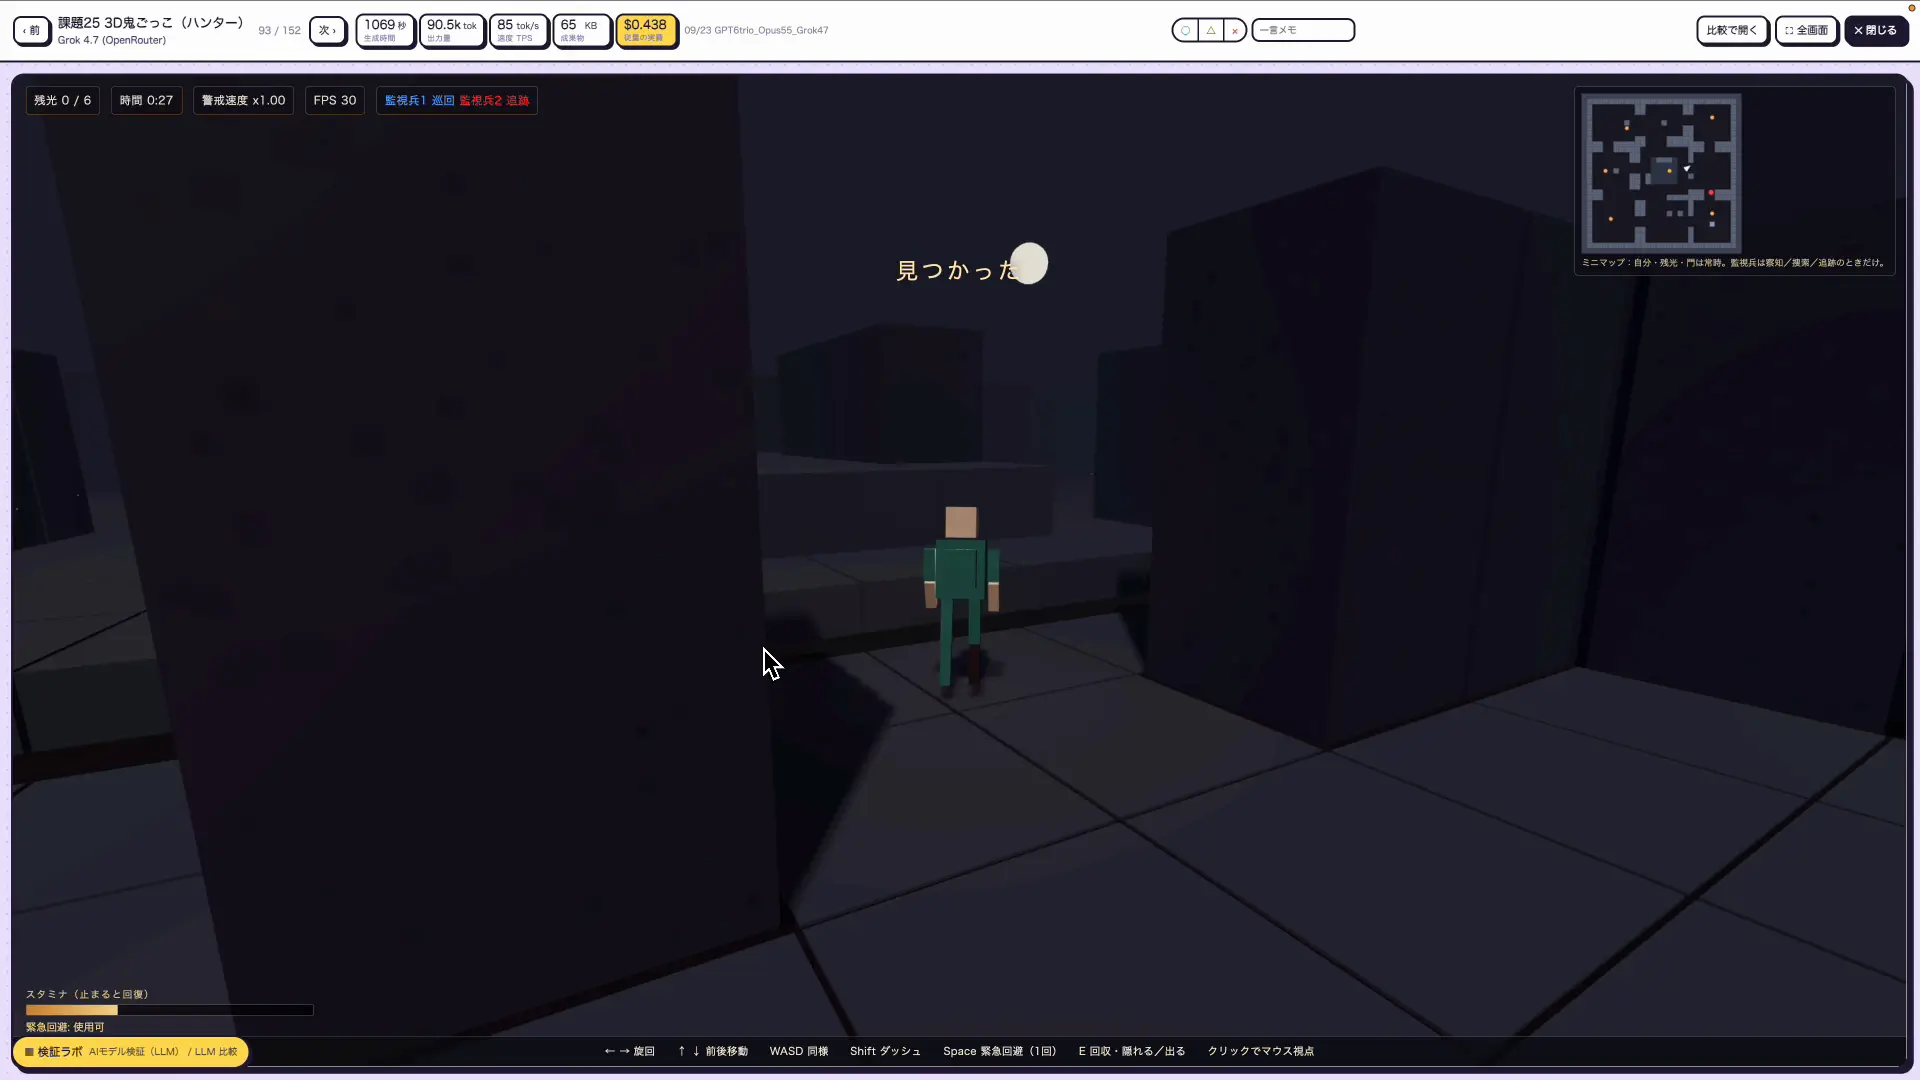
差がはっきり出たのが、鬼ごっこゲームです。このお題では、品質は正直低めでした。キャラクターの向きを変える矢印キーの左右が逆に設定されていて、肝心の鬼も追いかけてきません。
こうした不具合が残るので、ゲームの仕組みを一から組み立てる用途では、まだ精度を上げてほしいところです。生成されたものはそのまま使わず、動作を一度確かめてから使うようにしてください。
Grok 4.7が向く仕事・向かない仕事
ここまでの結果を、向く仕事と向かない仕事に整理します。
| 仕事 | 判定 | 理由 |
|---|---|---|
| 電気工学・法務などの専門作業 | 向く | EEBench・Harvey Legal Agentで上位モデルを上回った(公式ベンチ) |
| 軽めのモデルでの文章づくり | 向く | 公式画像の引用つきで、段落で区切った読みやすい文章になった |
| ゲームやWebアプリの試作 | 条件付き | 遊べる形にはなるが、カクつきや操作の不具合が残る |
| 速さが大事な作業 | 向かない | 同じお題でほかのモデルの約3倍の時間がかかった |
| 画像・動画の生成 | 向かない | 出力はテキストのみ(Grok Imagineを使う) |
まとめ
Grok 4.7の要点をまとめます。
- 料金は4.6から据え置きの入力$2・出力$6で、長い作業と資料づくりが強化
- 使えるのはAPI・OpenRouter・Cursor・Grok Buildなど(アプリ版はまだ)
- 電気工学と法務のベンチは上位、総合力は同じ週のClaude Opus 5.5に及ばない
- 生成時間はほかのモデルの約3倍で、トークン量も多い
- 文章づくりには使えるが、ゲームは不具合が残ることがある
期待していたほどの大きな進化ではありませんでしたが、CursorやGrok Buildなどのサービスと組み合わせると、効果的に使えるモデルになりそうです。今後のアップデートで精度が上がれば、僕自身の作業環境に組み込むことも考えています。まずはOpenRouterやCursorから、得意な作業で試してみてください。
最新のAI情報や活用事例は、公式LINEでも配信しています。新しいモデルが出るたびに同じお題で作らせた結果を紹介していますので、モデル選びの参考にしてください。

