この記事でわかること
- DeepSeekが自ら「上位版より下位版を」と案内した理由
- Flashで生成したゲームが実際にどこまで遊べるか
- 単価が3分の1でも請求が下がらない仕組み
- どの作業に任せて、どこで上位モデルに切り替えるか
「僕が実際に同じお題を解かせたら、単価3分の1以下のはずのモデルで請求がほとんど同じでした」
安いモデルが出たと聞くと、まず価格表を見にいきます。今回も出力単価は上位版の3分の1以下でした。ただ、同じ仕事をさせて請求を数え直したところ、差はほとんどありませんでした。なぜそうなるのかまで含めて、実際に7種類のゲームを作らせた結果と一緒にお伝えします。
こんにちは、ルーティンラボ(@rutinelabo)です。本記事では、2026年9月10日にDeepSeekがリリースしたDeepSeek-V4.1-Flashについて、公式ドキュメントで確認できる事実と、僕がOpenRouter経由で実際に叩いて計測した実測値をまとめます。
プロンプト配布中
LINE公式アカウントを友達追加していただければ、本記事やYouTubeで使用した使用したプロンプトを配布いたします。メンバーシップ登録で優先サポートも実施中です。
結論|速度は本物、ただし「安い」は条件つきだった
先に結論をお伝えします。DeepSeek V4.1 Flashで確かに速くなったのは生成の速度で、僕の実測では上位版のV4 Proに対して2.41倍でした。ここは宣伝どおりです。
ところが、同じお題を解かせたときの実費はほぼ同額でした。V4.1 Flashが0.003428ドル、V4 Proが0.003415ドルで、差は1.004倍です。出力単価は3.3分の1のはずなのに、請求が下がりませんでした。
理由は出力の中身にあります。V4.1 Flashが出した2,833トークンのうち1,723トークン、つまり61%が推論トークンでした。考えている分です。単価が下がっても、吐く量が2.4倍になれば請求は戻ります。
この一点だけ先に押さえておけば、この記事の残りは「では、どこで使えば得なのか」の話になります。
なぜ話題なのか|「上位版ではなく下位版を使ってください」という異例の案内
今回の発表で一番変わっていたのは、モデルの中身よりも案内の仕方でした。
普通、新しいモデルが出るときは「上位版へ移ってください」という話になります。ところがDeepSeekは、自社の上位版であるV4 Proよりも下位版にあたるFlashを使ってほしいと案内しました。海外メディアはこう書いています。
Most model launches ask customers to upgrade. DeepSeek's latest asks them to downgrade and pay less.
(たいていのモデル発表は顧客にアップグレードを求める。DeepSeekの今回はダウングレードして安く払えと言っている)
お金を払っている上位ユーザーを自分から安いほうへ流すわけですから、自社の内部比較が正しくなければ成立しません。だから比較を公開した、と読まれています。
背景もあります。DeepSeekは上海のSTAR Marketへの上場を準備中で、CITIC證券を起用したと報じられています。上場前に技術的な前進を見せる必要があるタイミングでの発表でした。資金調達ができれば開発がさらに加速する、という見方が広がっています。
受け止められ方も大きく、Hugging Faceでは公開初日に734のいいねが付きました。重みがMITライセンスで公開されているので、誰でも落として確かめられる状態です。
DeepSeek V4.1 Flashの正体|552Bのうち動くのは8B
スペックを整理します。数値はすべて公式のモデルカードと価格表から取りました(2026年9月時点・公式参照)。
| 項目 | 値 |
|---|---|
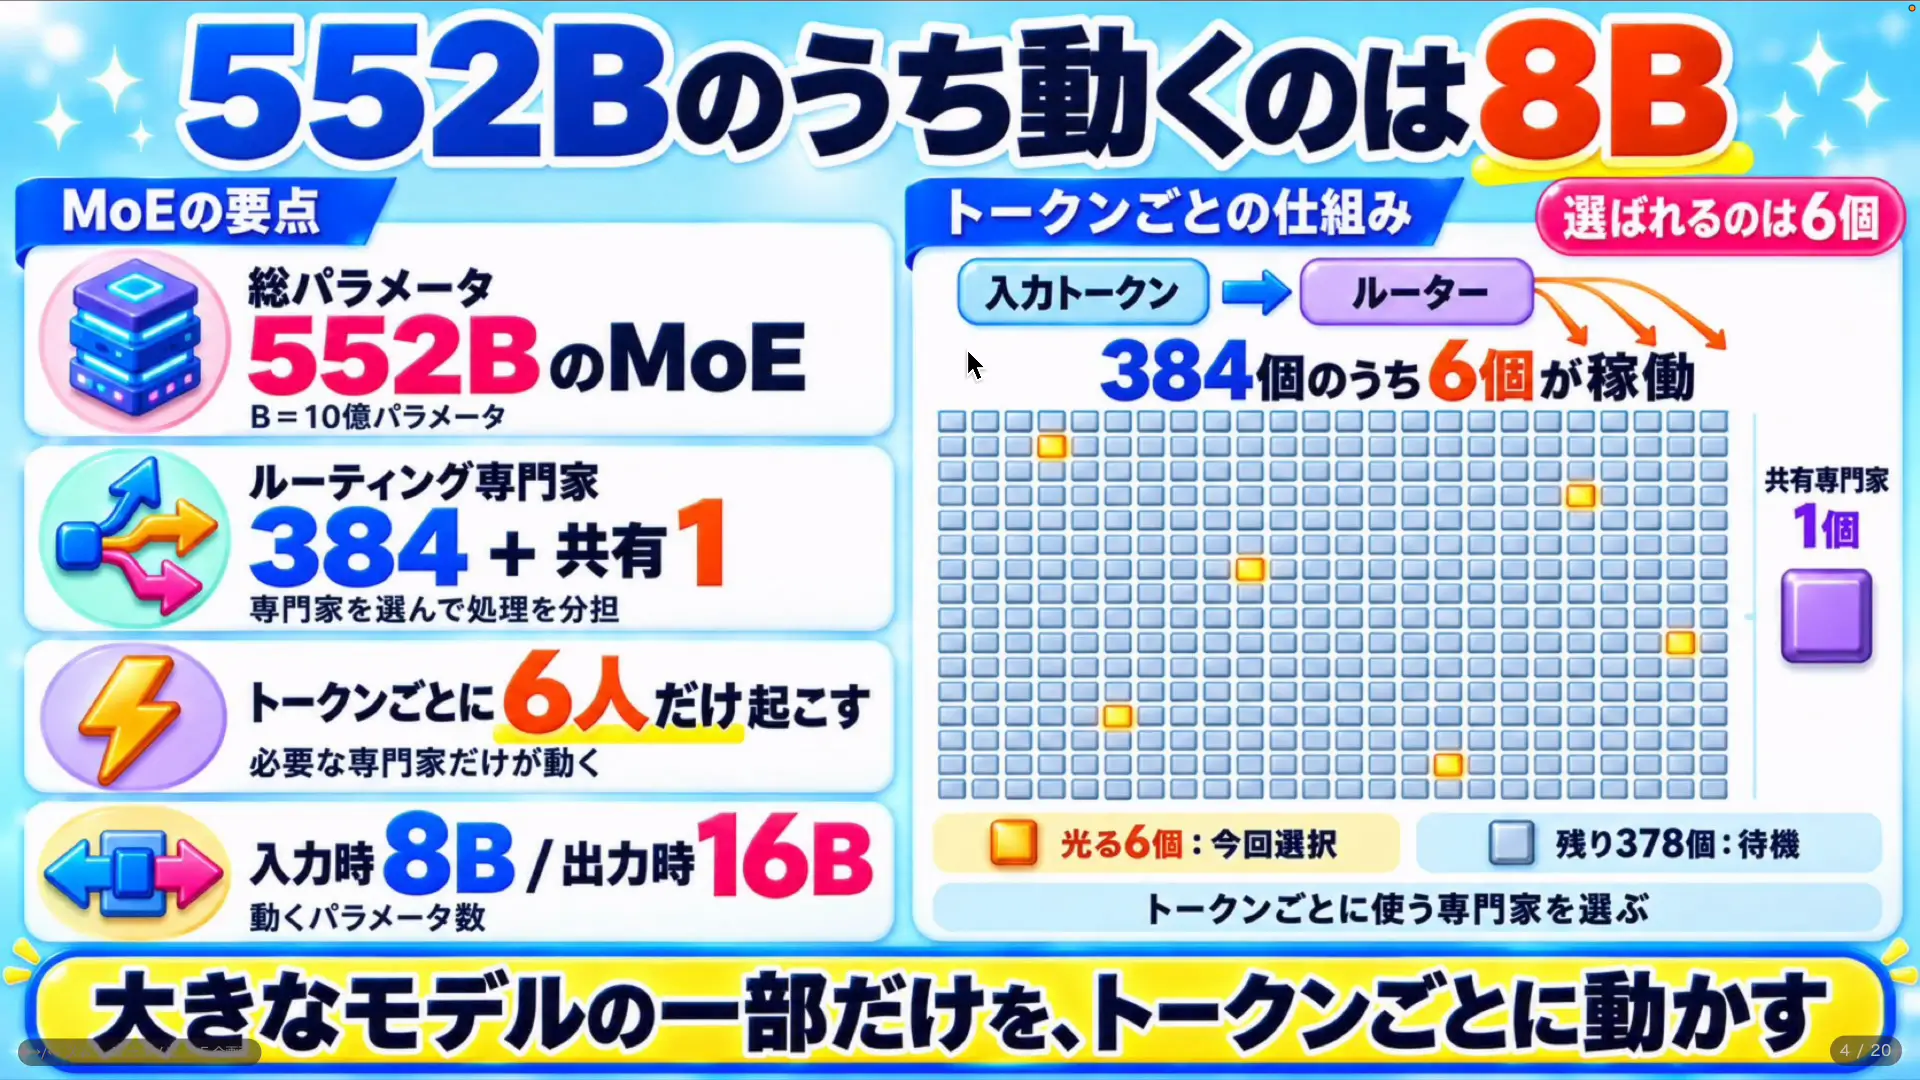
| 総パラメータ | 552B(MoE) |
| 実際に動く量 | 入力時 8B / 出力時 16B |
| アーキテクチャ | Causal Encoder-Decoder(20層+20層) |
| コンテキスト長 | 100万トークン |
| 最大出力 | 384,000トークン |
| ライセンス | MIT(オープンウェイト) |
| 画像入力 | 標準対応 |
ポイントはMoE(Mixture of Experts)という構造です。日本語にすると「専門家の集まり」で、モデルの中に役割の違う専門家がたくさんいて、入力に応じて必要な人だけを起こします。
V4.1 Flashの場合、ルーティング専門家が384個と共有専門家が1個あり、1トークンにつき6個だけが動きます。パラメータ数が大きいから全部が一斉に動く、というモデルではありません。だから「大きいのに速い」が成立します。
そして前世代との一番の違いが処理の構造です。前半のエンコーダで「何が必要か」を整理してから、後半のデコーダで必要な作業を専門家に振り分けます。V4 Proとは構造そのものが違う、というのが今回の特徴です。
メモリの消費が前世代の4分の1になった
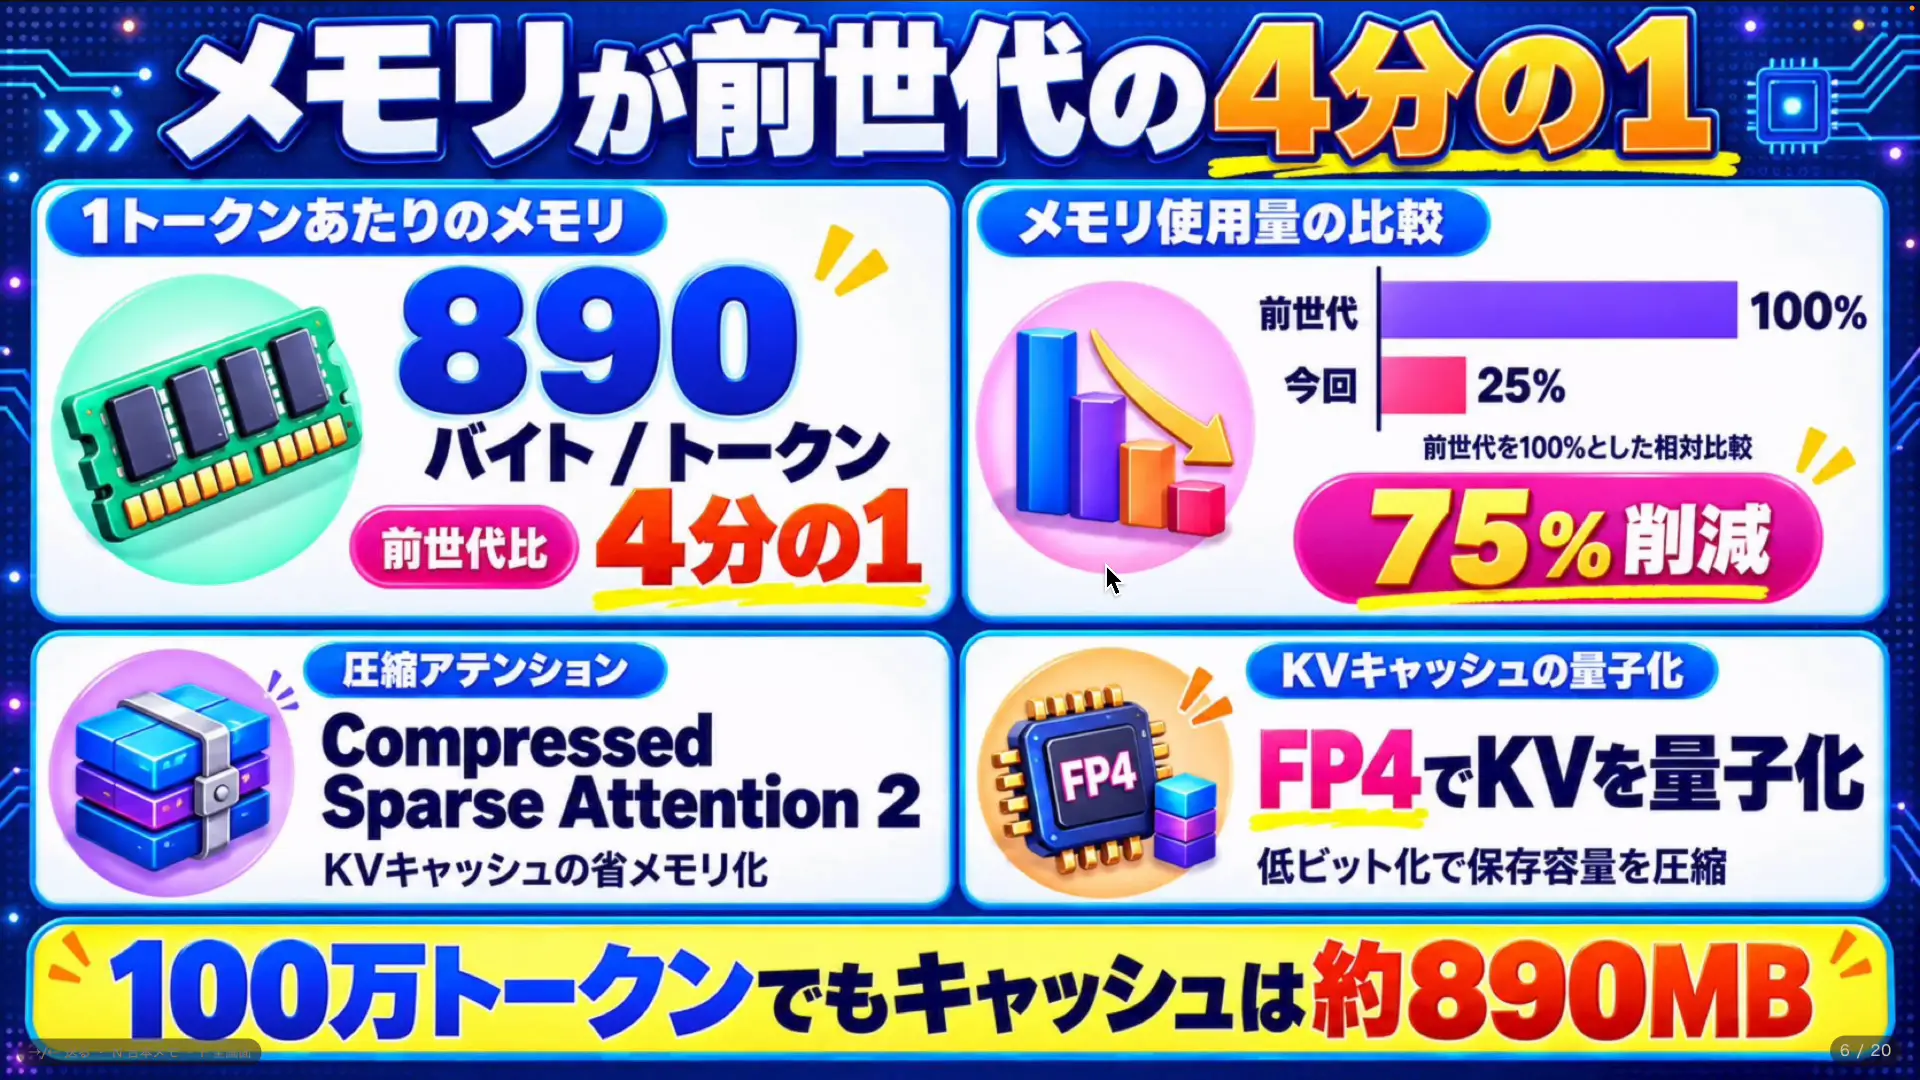
安く提供できる理由のひとつがここです。KVキャッシュと呼ばれる、長い会話を保持するためのメモリが1トークンあたり890バイトまで圧縮されました。前世代のFlashの約4分の1です。
100万トークンを読ませても、キャッシュは約890MBに収まる計算になります。長い資料を丸ごと投げる使い方が現実的になった、ということです。
ただし注意点があります。これは推論中のキャッシュの話で、モデル本体の重みは別です。552Bは4bitに圧縮しても約276GB相当あるので、「MITで公開されたから自分のパソコンで動かせる」という話にはなりません。ここは後ほど詳しくお伝えします。
ゲームがちゃんと遊べる|Flashとは思えない完成度
DeepSeek V4.1 Flash【安いモデルで3Dゲームが遊べた】
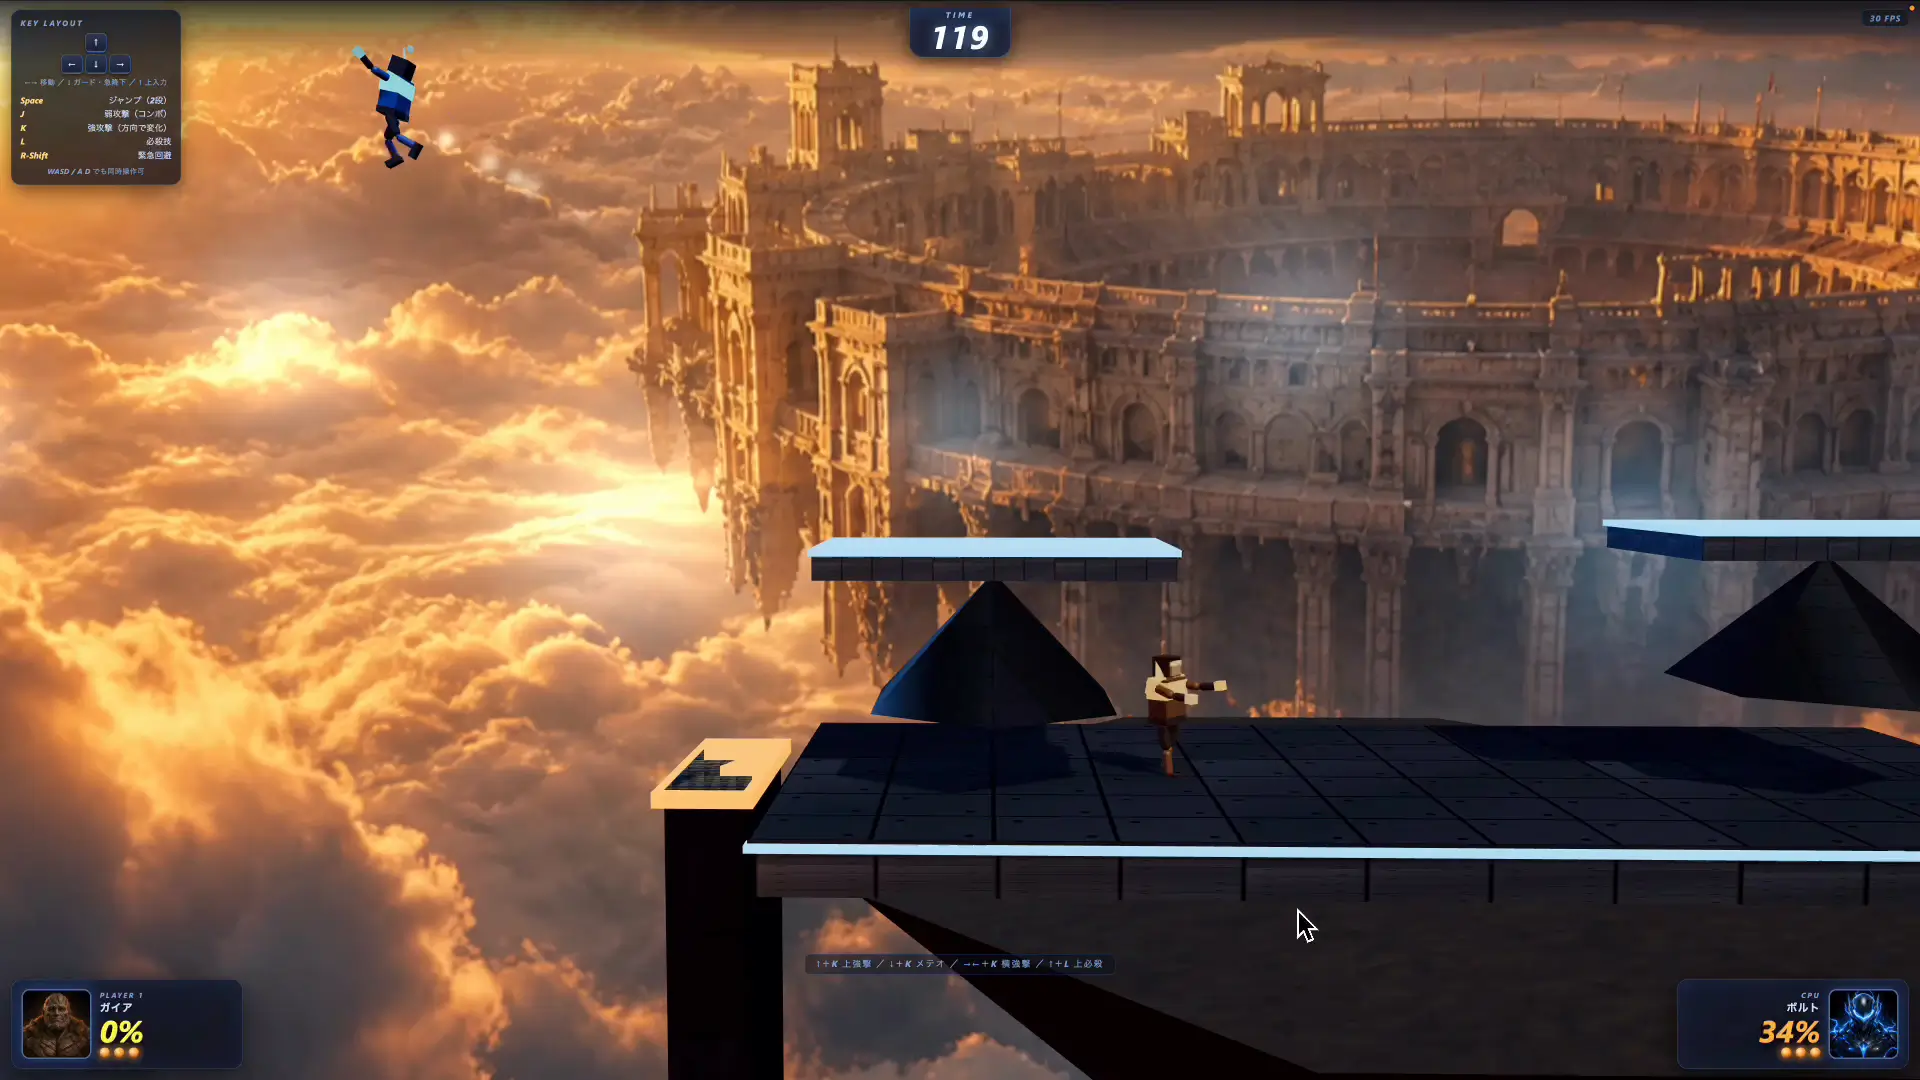
大乱闘風の対戦ゲームをワンショットで生成。
・キャラがめちゃめちゃ吹っ飛ぶ
・必殺技もしっかり強い
・前世代のFlashは3Dが動きもしなかった#DeepSeek #生成AI
安いモデル、どこまで任せていますか?
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
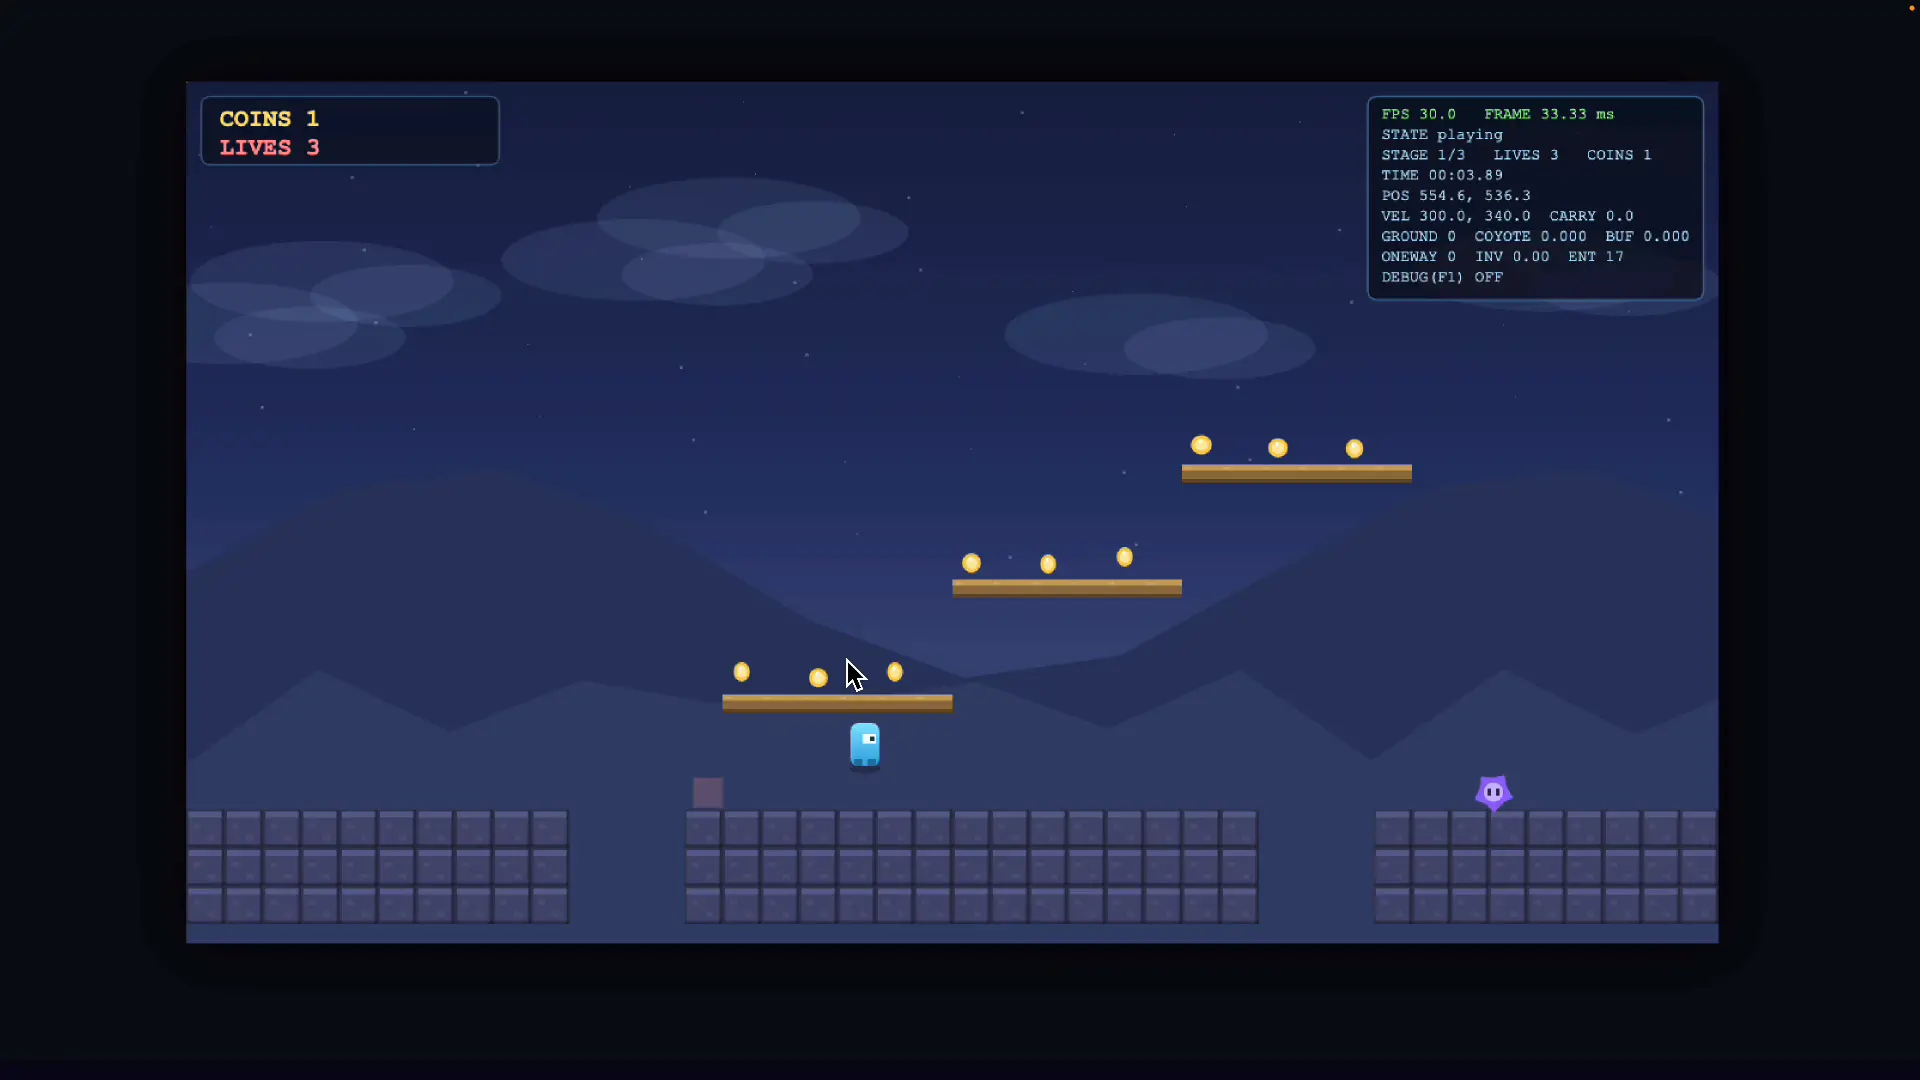
ここからが実測です。いつもどおり、同じお題でゲームをワンショット生成させました。追加の指示は出していません。
まず2Dアクションゲームです。キャラクターがするする動き、敵を踏んだときのアニメーションも入っていて、画像も埋め込まれていました。これを一発で作っています。以前のFlashのモデルと比べると、明らかにクオリティが上がっているのが分かります。
ただ、粗も見つかりました。自分を追いかけてくる敵が崖をそのまま落ちていきます。経路の判断まではできていません。ここは少し頭の弱さを感じました。
次に大乱闘風の対戦ゲームです。これが今回いちばん驚いた生成物でした。キャラクターがめちゃめちゃ吹っ飛びますし、必殺技もかなり強く設定されています。以前のFlashのモデルでは3Dのゲームは動きもしなかったところが、遊べるレベルまで来ました。
鬼ごっこゲームも作れる|敵に見つからずアイテムを回収する
DeepSeek V4.1 Flash【鬼ごっこゲームも成立した】
敵に見つからずアイテムを回収しきるルール。
・鬼が来たら隠れる動きまで作れている
・最後は捕まったけど、ゲームとして遊べる
・7本作らせて、遊べたのはこれと大乱闘風#DeepSeek #AIゲーム
Flashクラスに何を作らせたいですか?
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
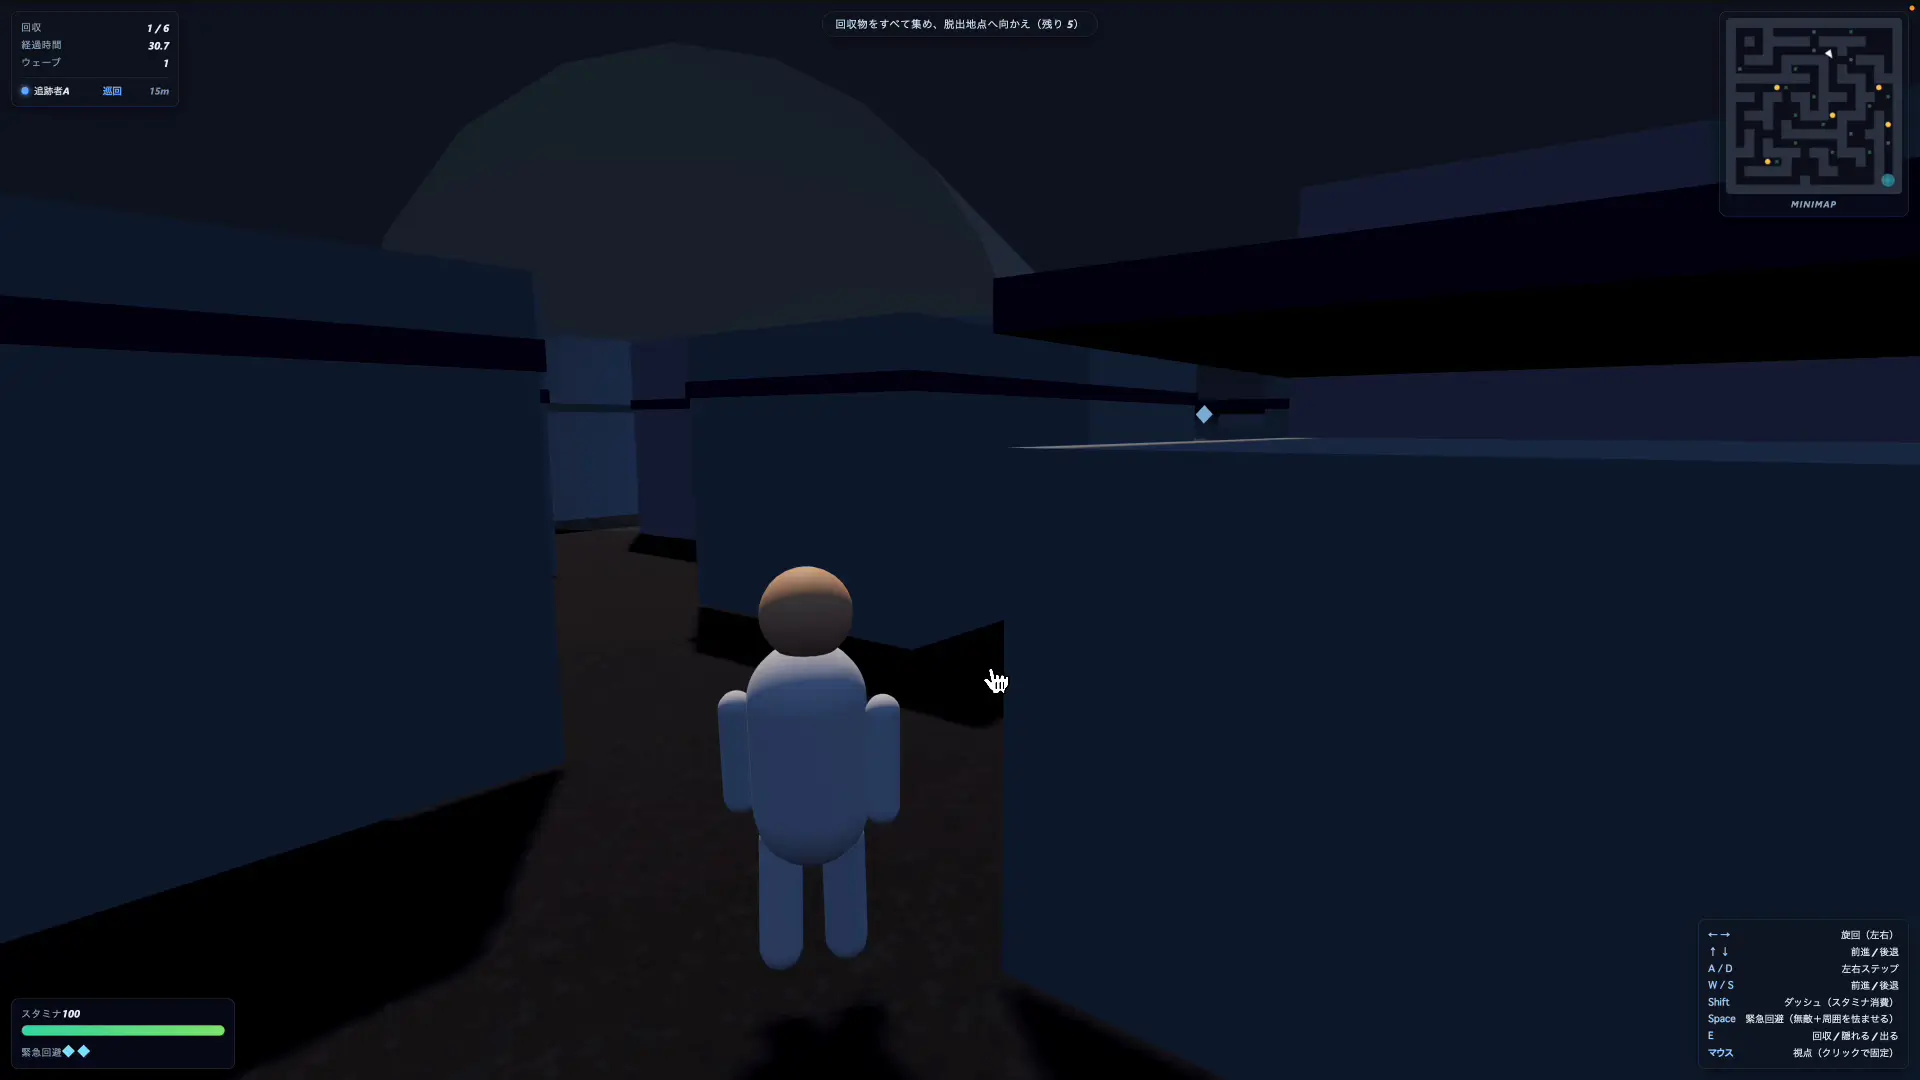
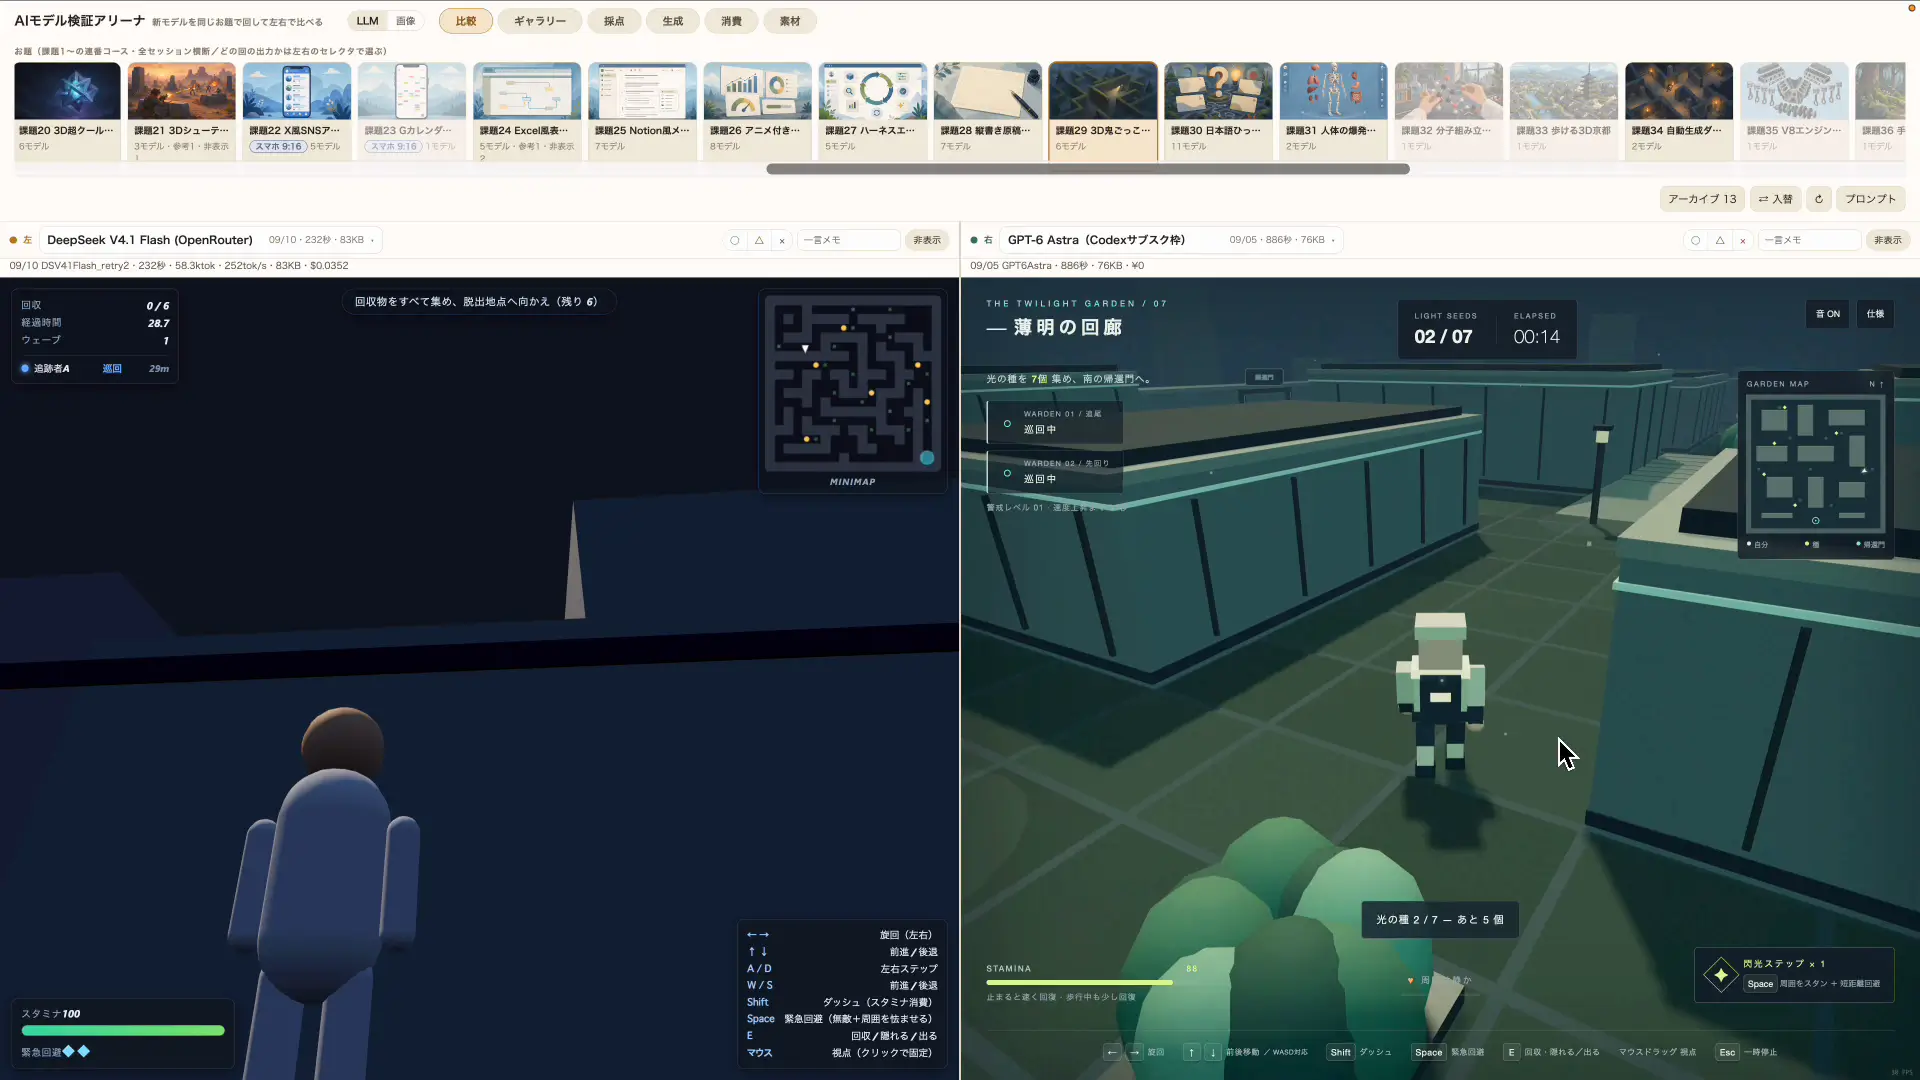
このチャンネルでよく作る鬼ごっこゲームも試しました。敵に見つからないようにアイテムを回収しきる、というルールのゲームです。
実際に遊んでみると、鬼が来たら隠れるという駆け引きが成立していました。プレイ中に鬼に見つかって捕まってしまいましたが、ゲームとしてはきちんと機能しています。
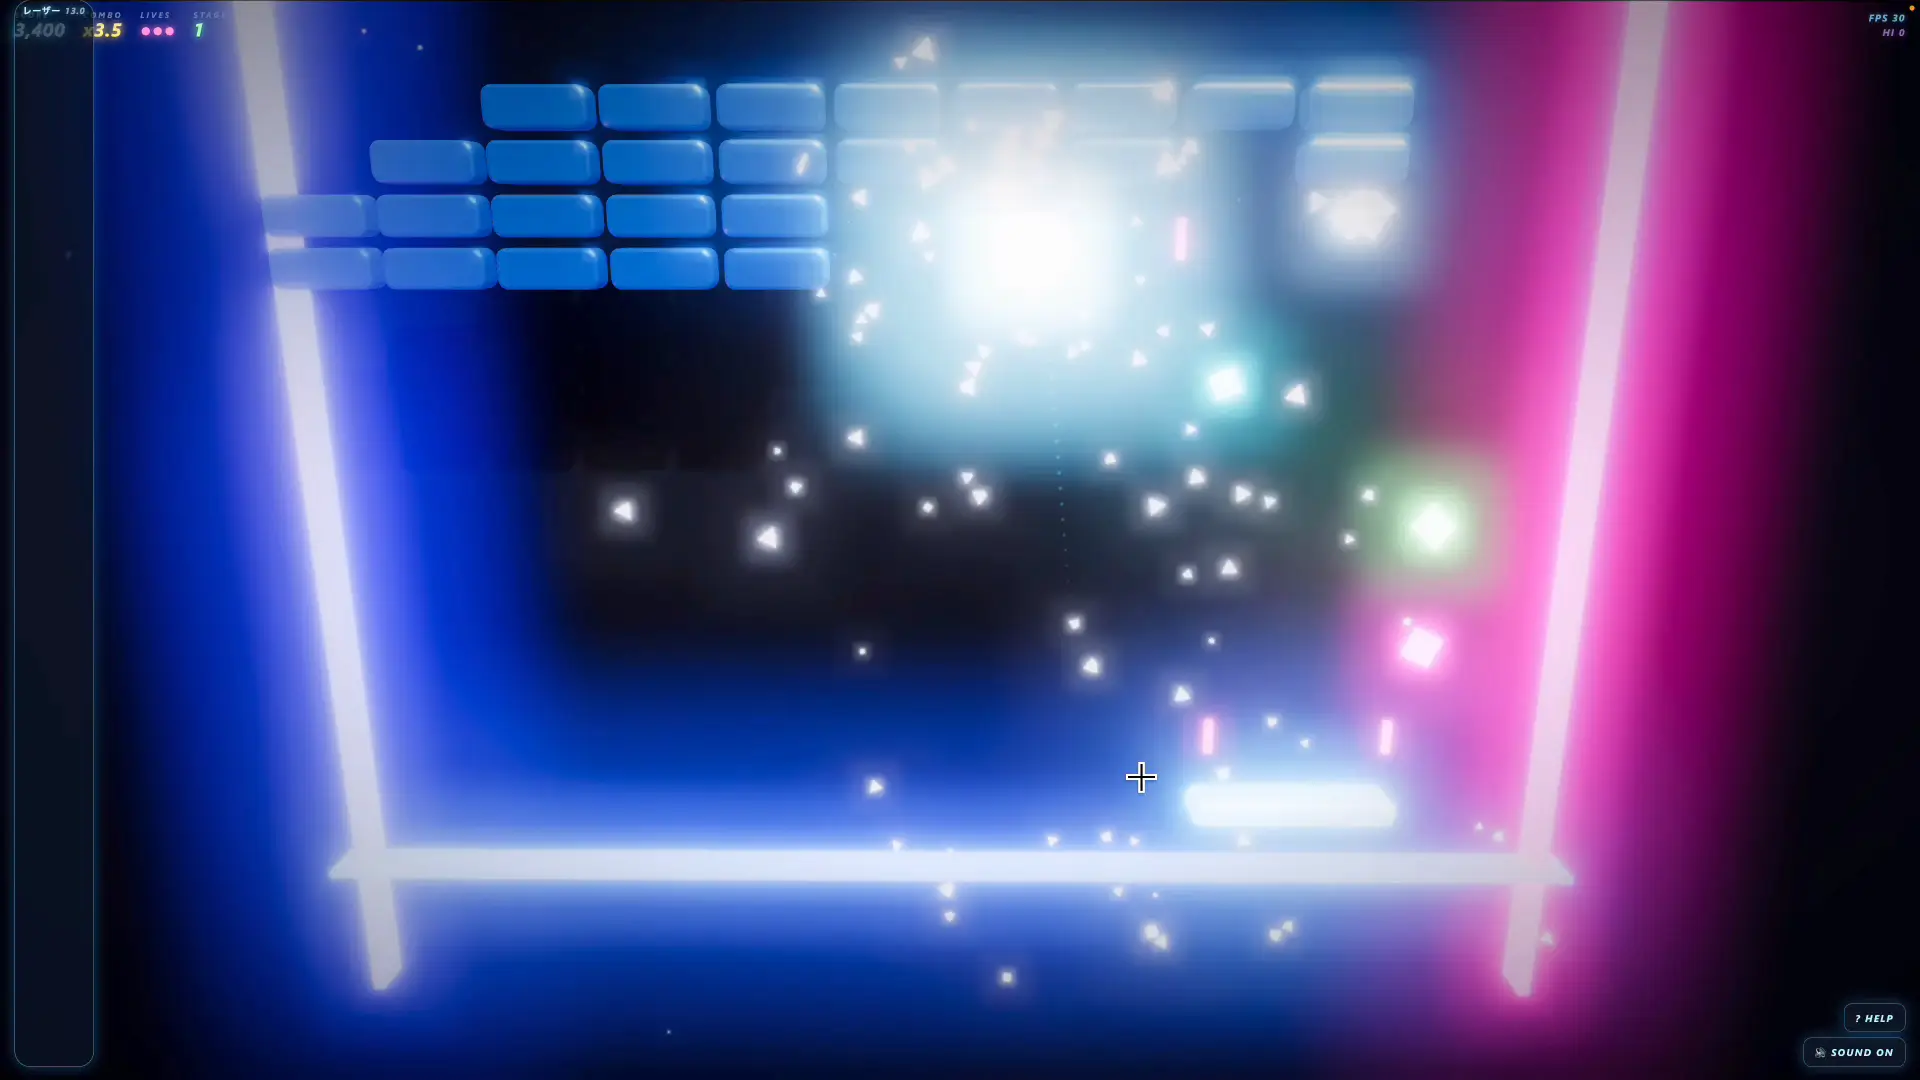
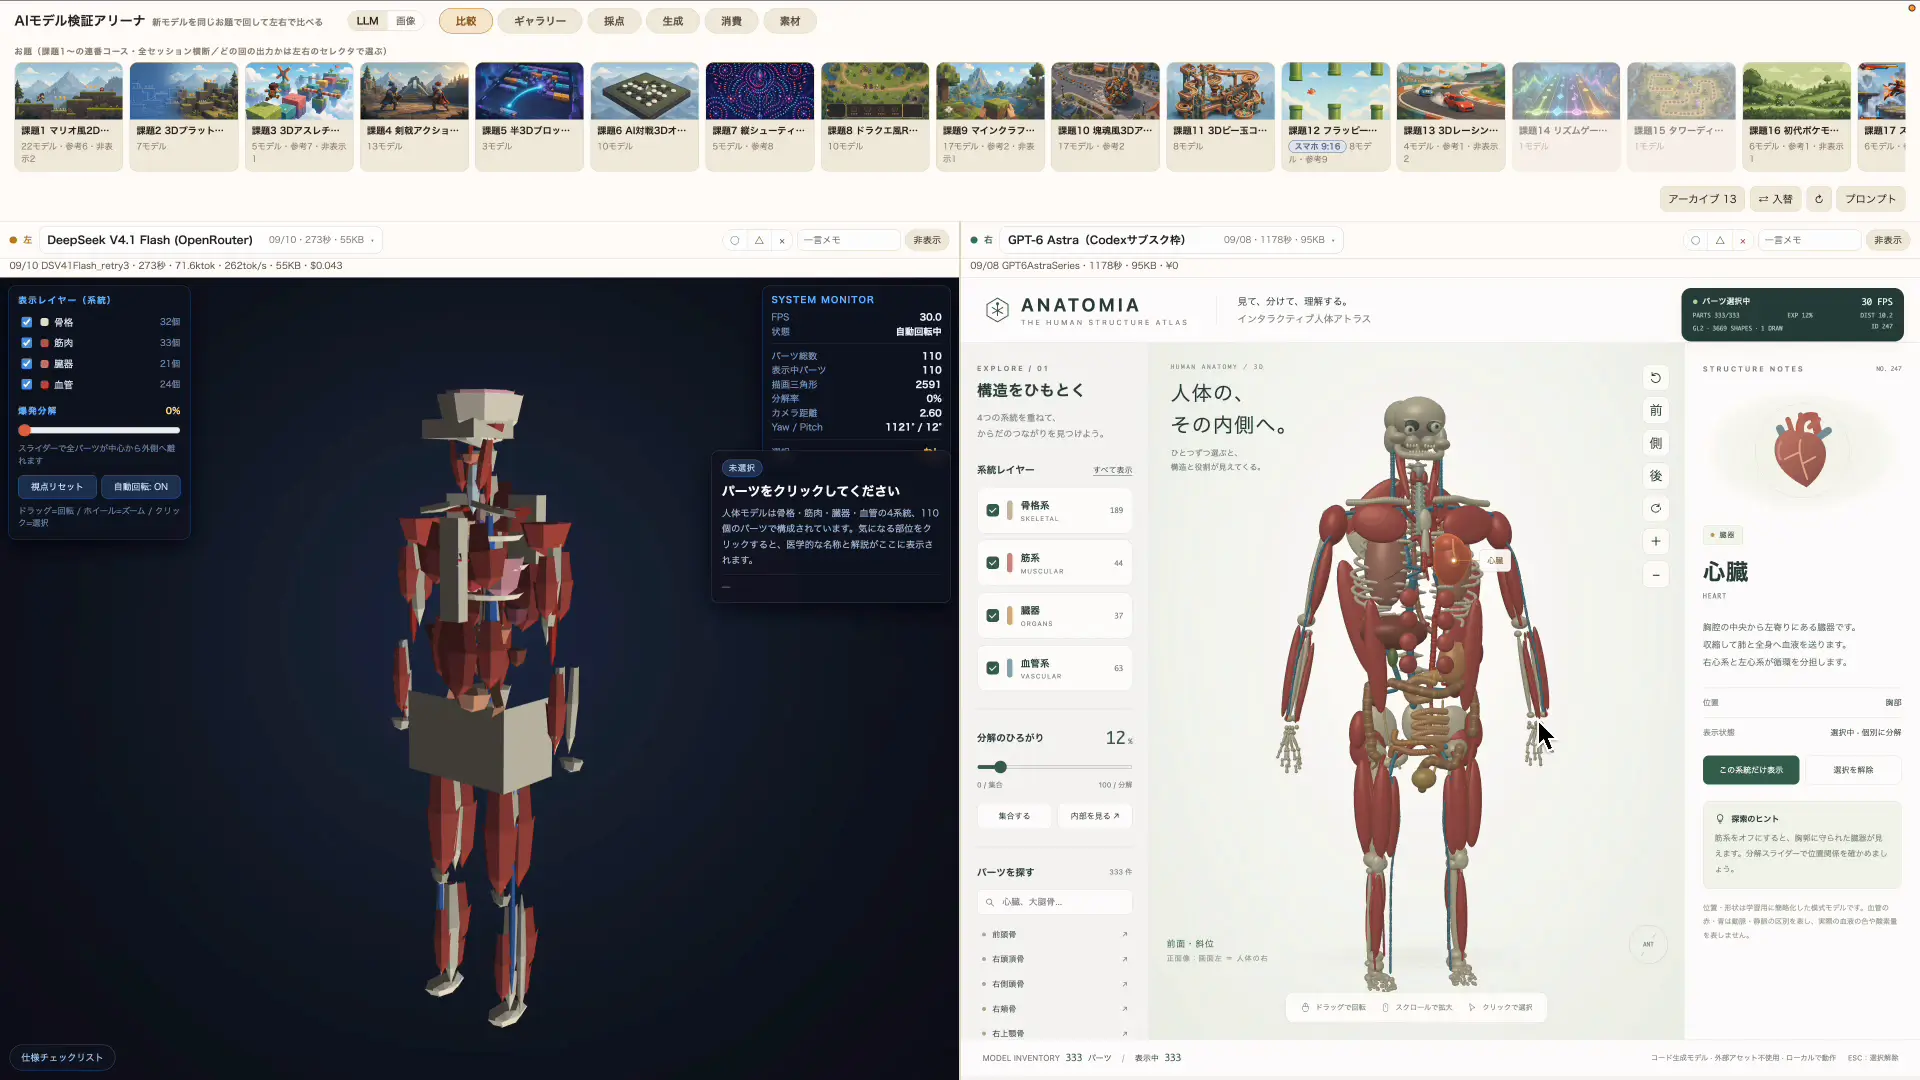
他にもブロック崩し、シューティング、ロボットの対戦ゲーム、人体模型の3D表示まで作らせました。結果に差はありました。
| お題 | 結果 |
|---|---|
| 2Dアクション | アニメーション付きで一発生成。敵の経路判断は弱い |
| 大乱闘風の対戦 | 遊べるレベル。前世代は動きもしなかった |
| 鬼ごっこ | 隠れる駆け引きが成立。十分遊べる |
| ブロック崩し | ボールがぼやけた見た目。アウト判定が分かりにくい |
| シューティング | ぎりぎり遊べる程度。デザインの詰めが甘い |
| ロボット対戦 | クオリティは高いが操作方法が難しい |
| 人体模型の3D | 正直、全然ダメでした |
全部がうまくいったわけではありません。特に人体模型は形にすらなっていませんでした。ただ、安いモデルだからこそ何度でも回せると考えると、この当たり外れは許容できる範囲だと感じています。
上位モデルと並べて比較|GPT-6 Astraとの差はどこに出るか
⚖️ DeepSeek V4.1 Flash vs GPT-6 Astra【同じお題で並べた】
左がFlash、右がAstra。
・作り込みはAstraが別格
・ただAstraで同じことをするとコストは何倍にも
・「勝てるか」より「どこまで任せられるか」で見る#DeepSeek #AIモデル比較
あなたなら品質と値段、どっちを取りますか?
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
同じお題を上位モデルにも解かせて、左右に並べて比べました。左がDeepSeek V4.1 Flash、右がGPT-6 Astraです。
結論から言うと、クオリティではAstraが明らかに上でした。人体模型で言えば、Astraのほうがきちんと人体の構造になっています。3Dの鬼ごっこゲームで比べても、Astraの作り込みは別格でした。
ただ、ここで比べるべきなのは出来栄えだけではありません。Astraで同じことをすればコストは何倍にもなります。Flashは価格が武器のモデルなので、同じ土俵で品質だけを比べても意味がありません。
デザイン性を担保しながら作り上げてくれる感触はあったので、「Astraに勝てるか」ではなく「どこまでをFlashに任せられるか」で見るのが正しい向き合い方だと思います。
公式が出したベンチマーク|勝っている所と負けている所
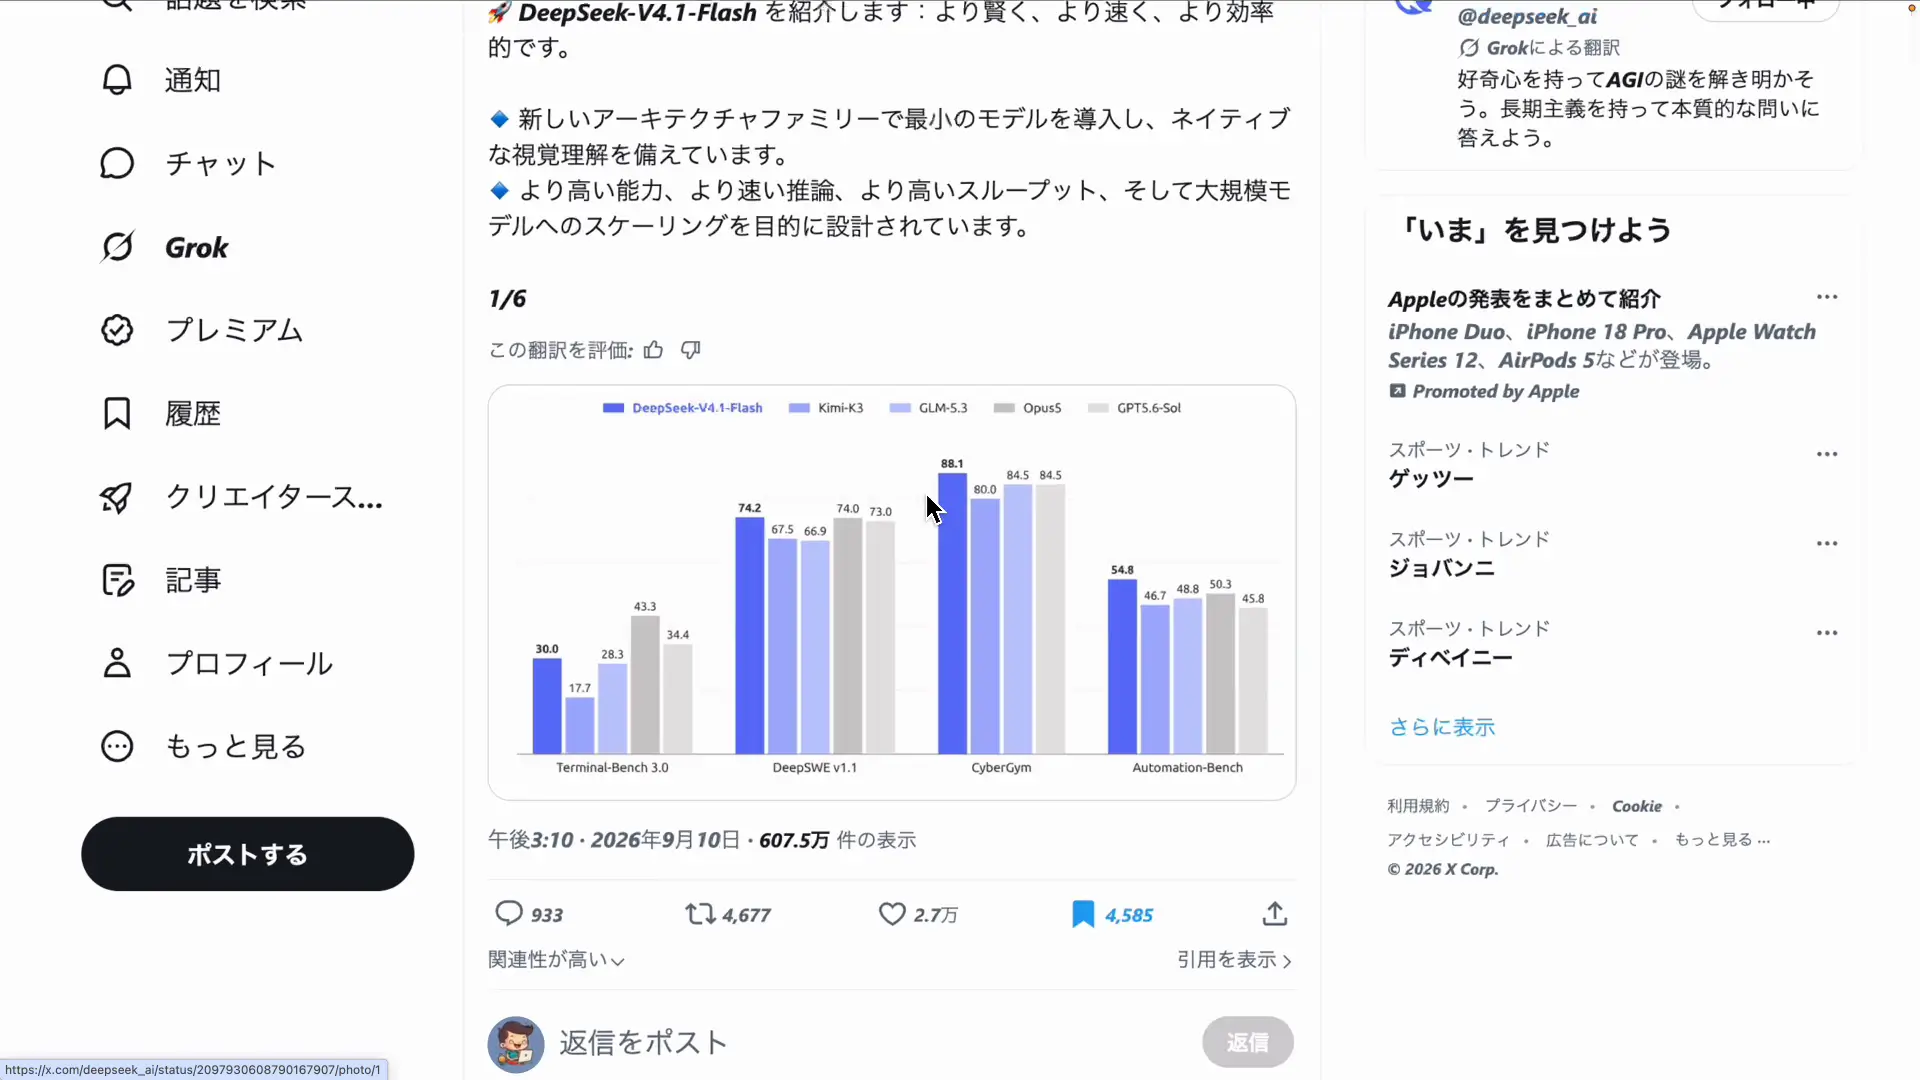
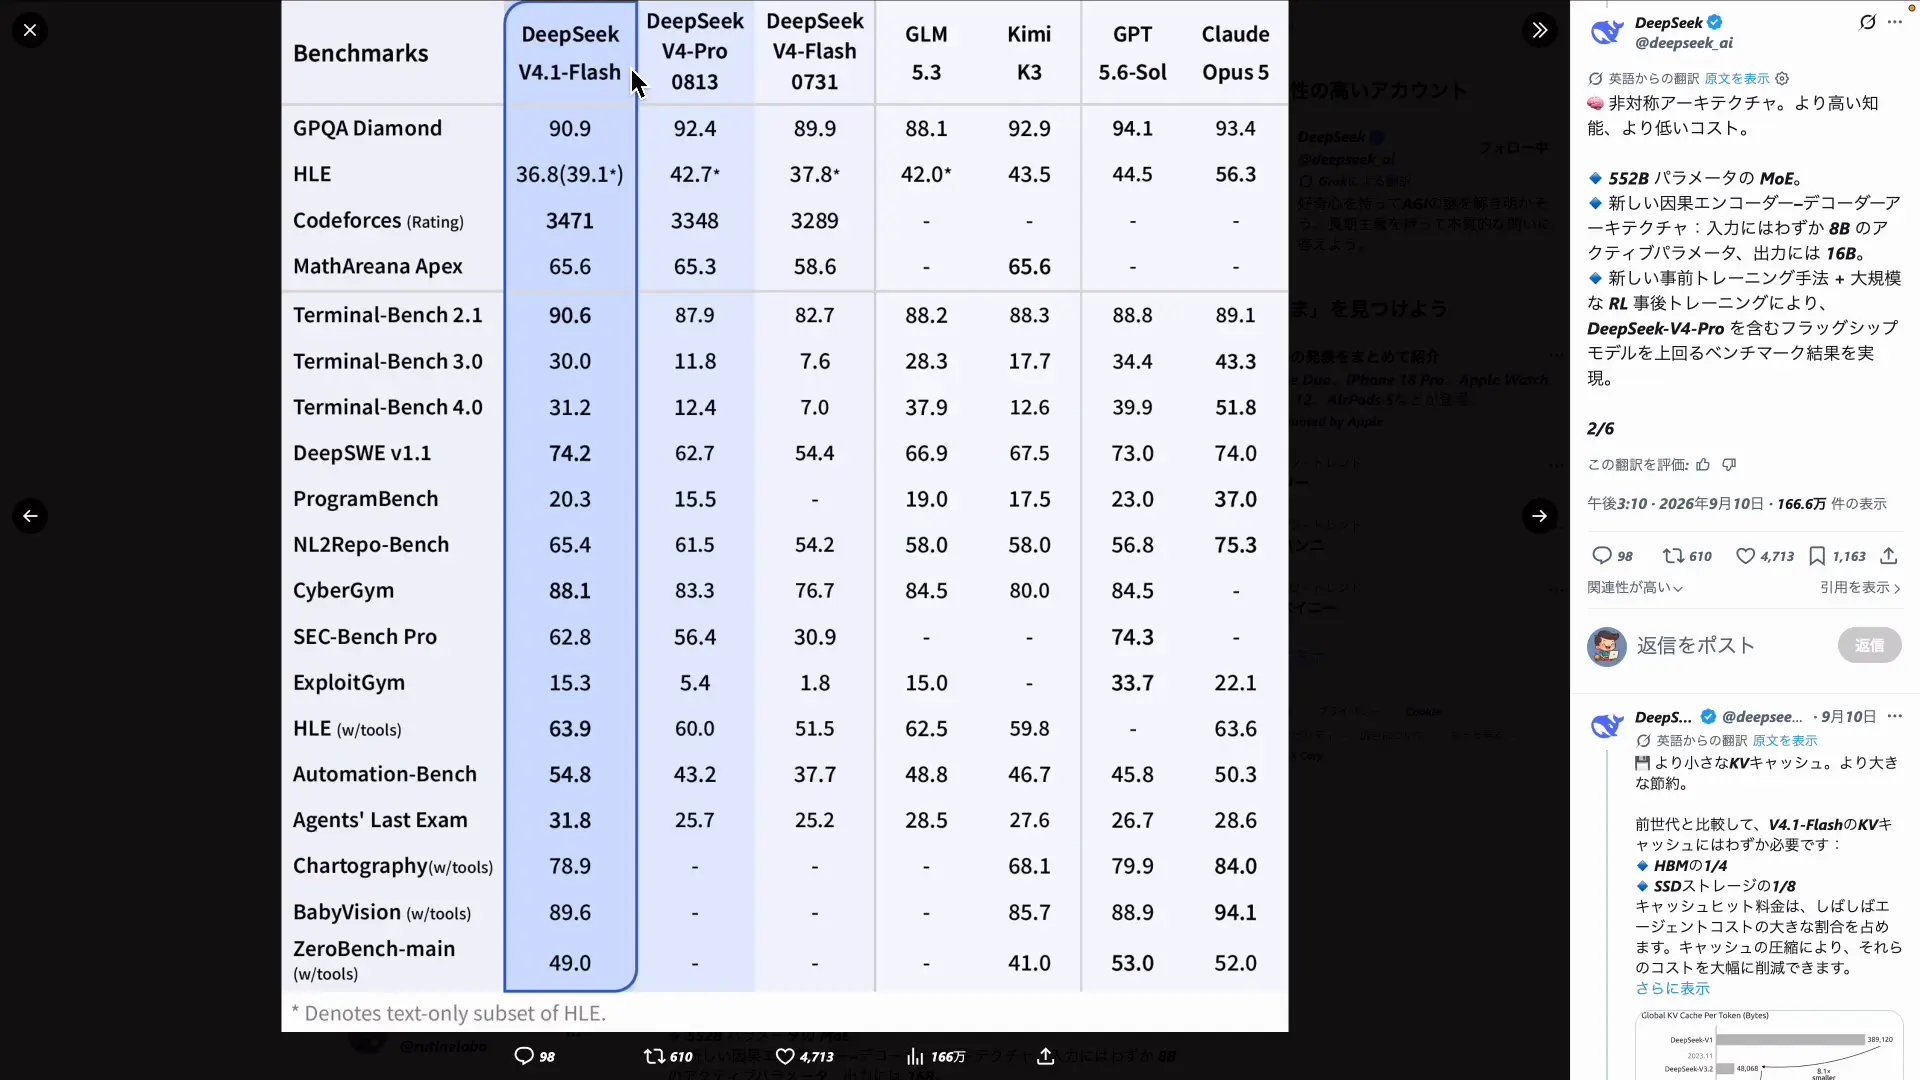
DeepSeekはChange Logに自社のスコアを並べて公開しています。他社比較ではなく、公式が自分で出した数値なので、そのまま見ていきます。
| 勝っている | スコア | 負けている | スコア |
|---|---|---|---|
| GPQA Diamond | 90.9 | ExploitGym | 15.3 |
| Terminal-Bench 2.1 | 90.6 | ProgramBench | 20.3 |
| CyberGym | 88.1 | Terminal-Bench 3.0 | 30.0 |
| DeepSWE v1.1 | 74.2 | Terminal-Bench 4.0 | 31.2 |
| Automation-Bench | 54.8 | Agents' Last Exam | 31.8 |
注目したいのはTerminal-Benchの版ごとの差です。2.1では90.6という高いスコアなのに、3.0では30.0、4.0では31.2まで落ちます。新しい版の課題になると崩れる、という性格がはっきり出ています。
もうひとつ、HLEというベンチマークは条件で結果が変わります。道具を持たせない状態では36.8ですが、道具を持たせると63.9まで上がります。素の知識では弱いけれど、検索やツールを渡すと化けるモデル、という理解が正しいです。
ベースモデル同士の比較では、知識量を測るSimpleQA-Verifiedが42.3で、前世代のV4 Proの55.2に負けています。多言語のMultiLoKoも45.5対50.9で下です。すべての面で上回ったわけではありません。
とはいえ、TerminalベンチとDeepSWEのスコアでV4 Proを上回っているので、コーディング周りはかなり任せられると判断しました。
料金|単価は3分の1以下、ただし時間帯で2倍変わる
公式の価格表です。100万トークンあたりのドル建てで、V4 Proと並べました(2026年9月時点・公式参照)。
| 項目 | V4.1 Flash | V4 Pro |
|---|---|---|
| 入力(キャッシュヒット) | $0.003 / $0.006 | $0.022 / $0.044 |
| 入力(キャッシュミス) | $0.15 / $0.30 | $0.66 / $1.32 |
| 出力 | $0.60 / $1.20 | $1.98 / $3.96 |
| 同時実行数 | 2,500 | 500 |
| 画像入力 | 対応 | 非対応 |
※ 各セルは「オフピーク / ピーク」の順です。
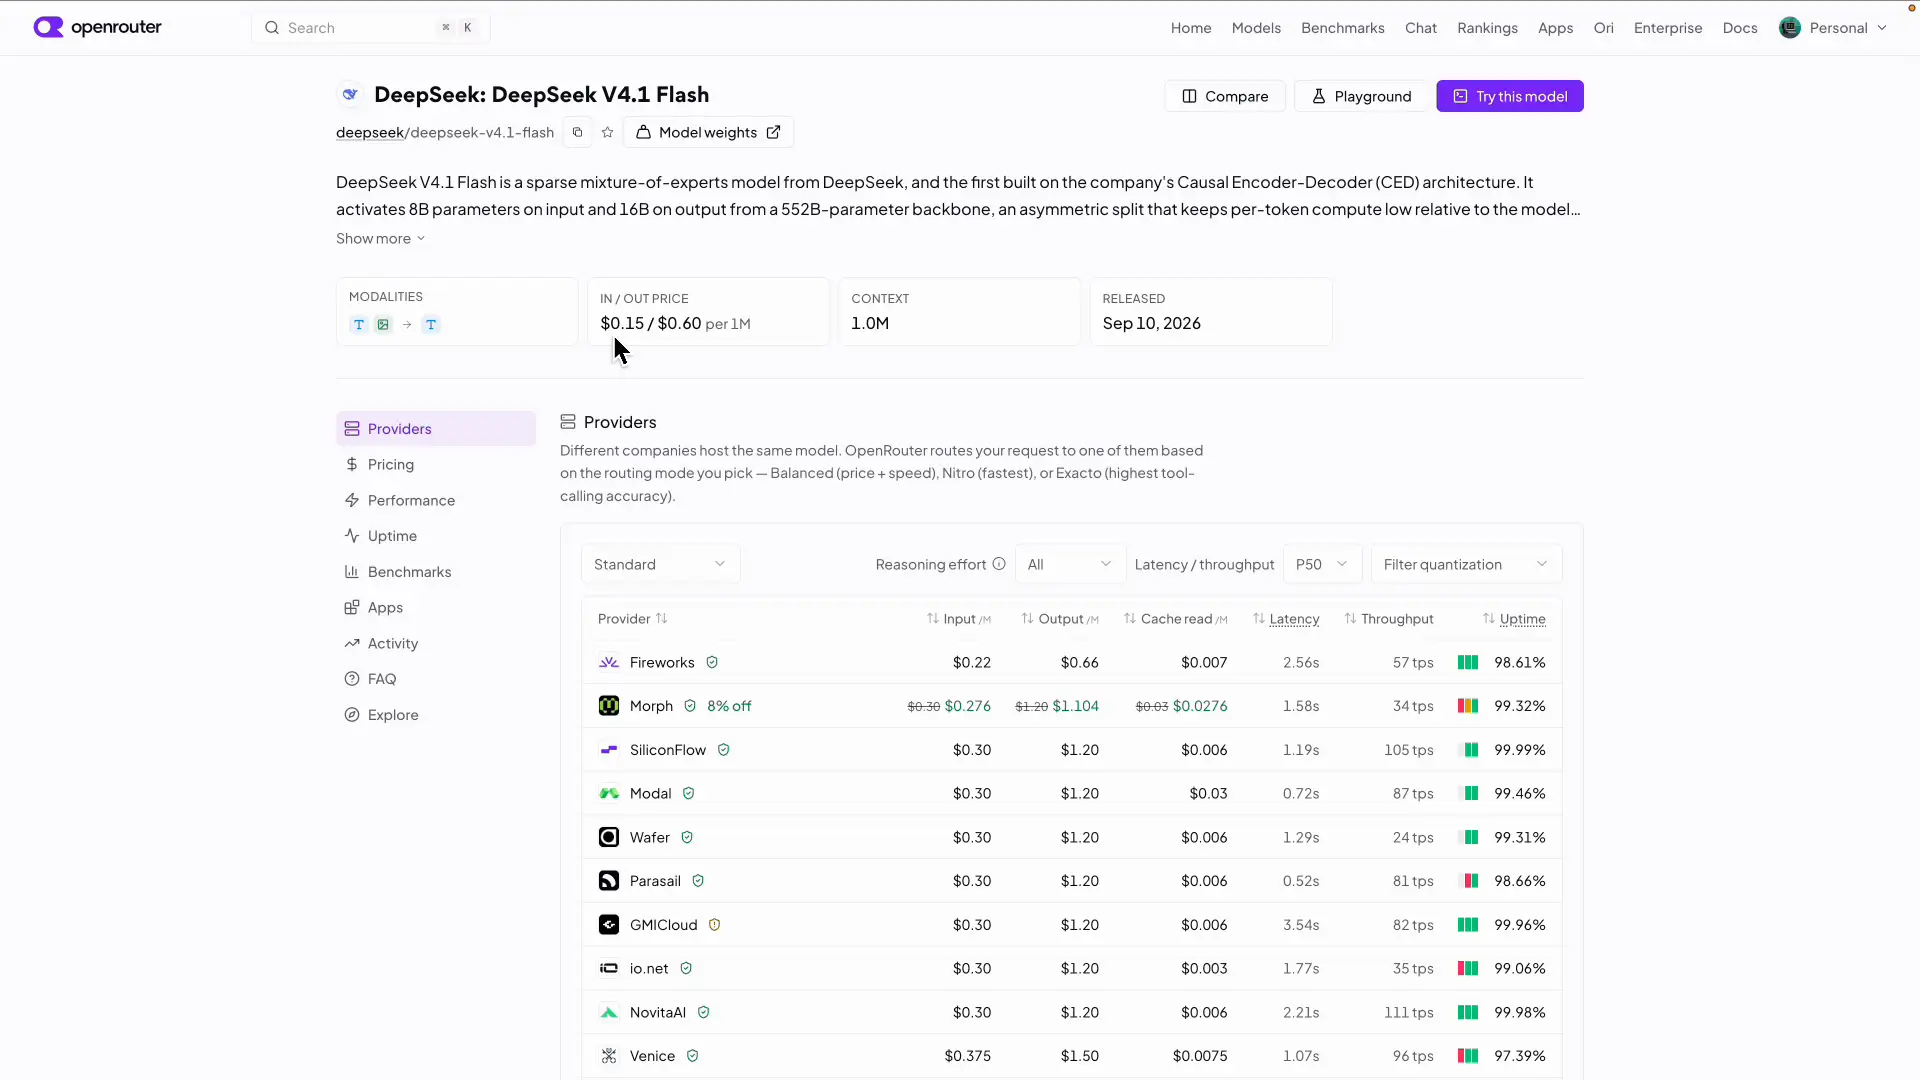
出力単価はV4 Proの3.3分の1、同時実行数は5倍、そしてV4 Proが対応していなかった画像入力にも対応しています。値下げと機能追加が同時に来ているのは事実です。
ピーク料金の時間帯が、日本の業務時間と重なる
ここが日本から使う人にとって見落としやすい点です。DeepSeekの料金にはピークとオフピークがあり、ピークはオフピークのちょうど2倍です。
公式のピーク時間帯は平日のUTC 01:00〜04:00と06:00〜10:00。日本時間に直すと10:00〜13:00と15:00〜19:00になります。平日の業務時間、合計7時間がまるごとピークです。
つまり、仕事で使っている時間帯はほぼ高いほうの単価にあたり、安い0.60ドルが効くのは日本の深夜から早朝だけ、ということになります。まとめて回すバッチ処理があるなら、夜に寄せるだけで実質半額です。
単価が3分の1でも、請求が3分の1になるとは限らない
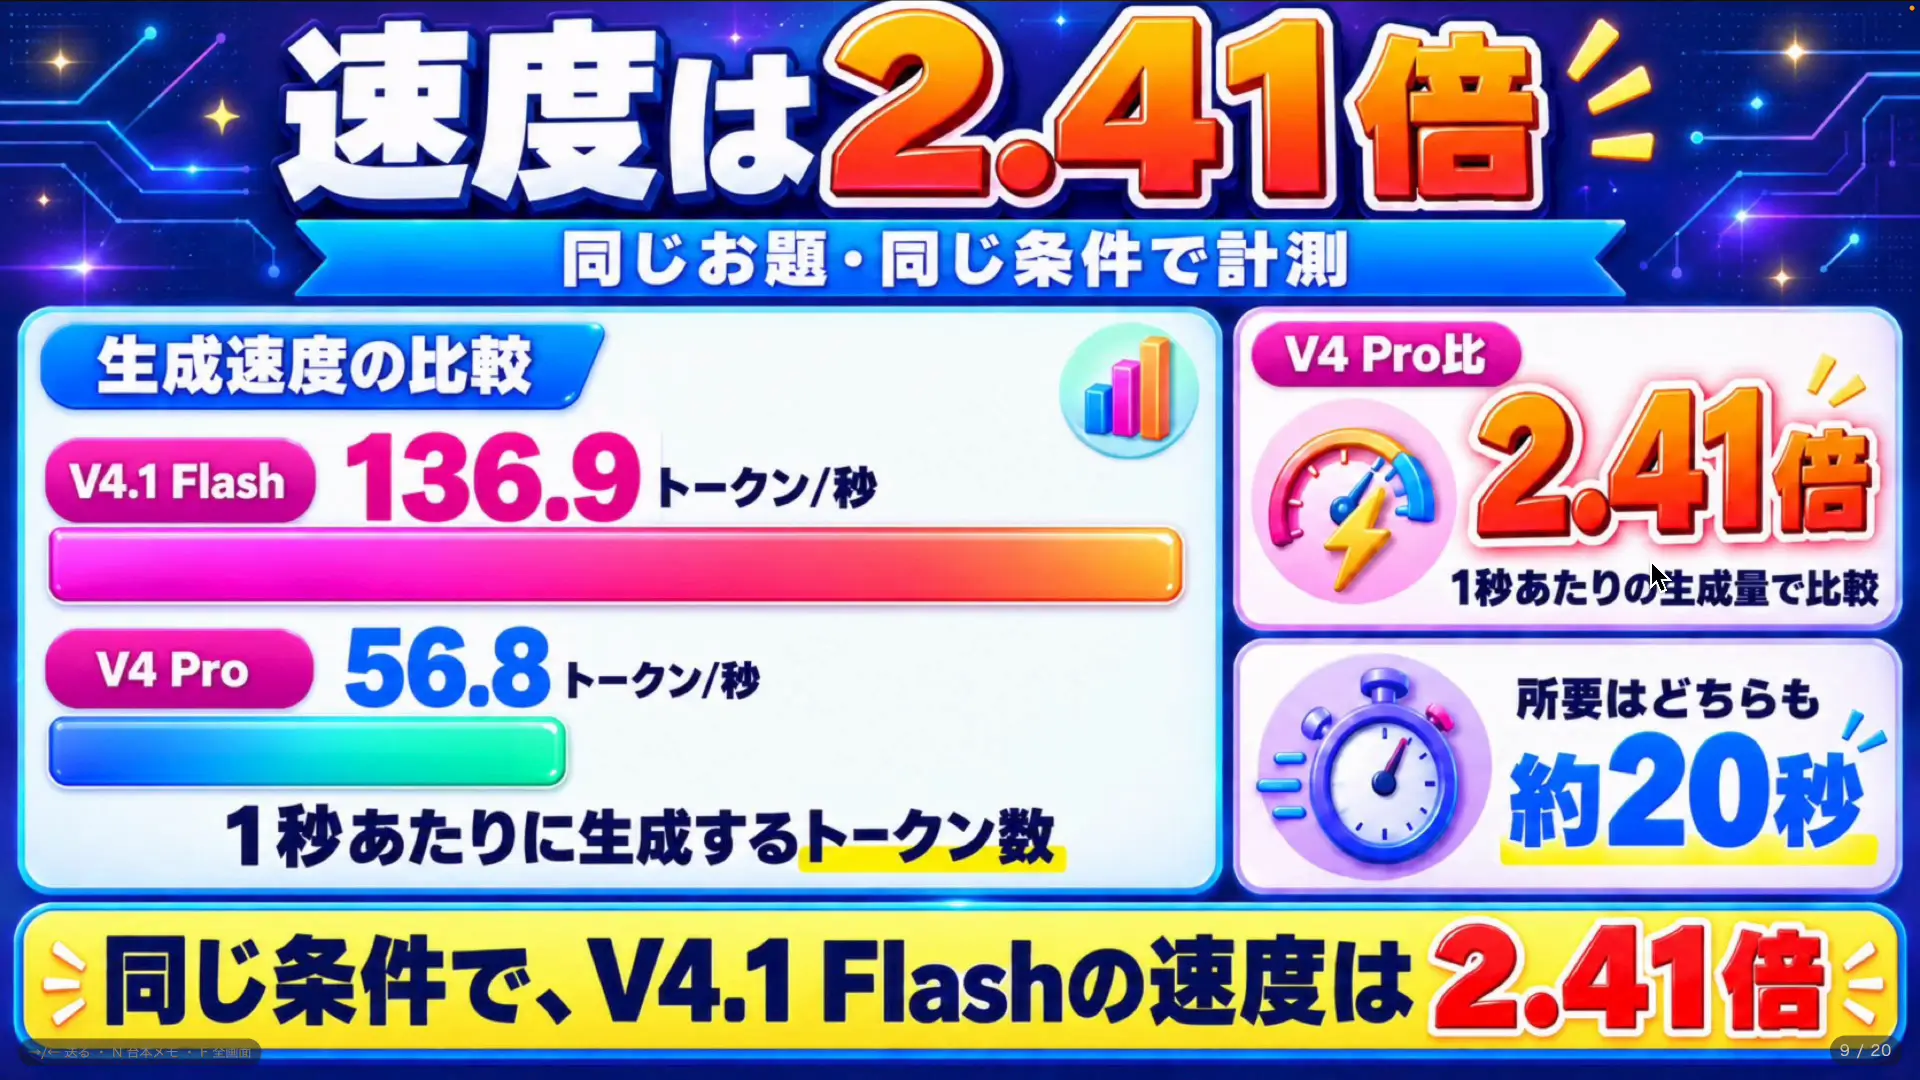
冒頭でお伝えした実測に戻ります。同じお題を解かせて、usageの実数字で比べました。
| モデル | 所要 | 出力トークン | うち推論 | 実費 | トークン/秒 |
|---|---|---|---|---|---|
| V4.1 Flash | 20.7秒 | 2,833 | 1,723(61%) | $0.003428 | 136.9 |
| V4 Pro | 20.6秒 | 1,172 | 291(25%) | $0.003415 | 56.8 |
速度は2.41倍。ここは宣伝どおりでした。ところが実費は1.004倍で、ほとんど同じです。
理由は推論トークンの割合でした。V4.1 Flashは出力の61%が「考えている分」で、V4 Proの25%を大きく上回ります。単価が下がっても、吐くトークンが2.4倍になれば請求は戻ります。
この計測はOpenRouter経由で1回だけ行ったものです。乗り換えを判断するなら、単価表ではなくご自身のお題で実際に測り直してみてください。
使い方|OpenRouterでAPIキーを引いて試すのが手軽
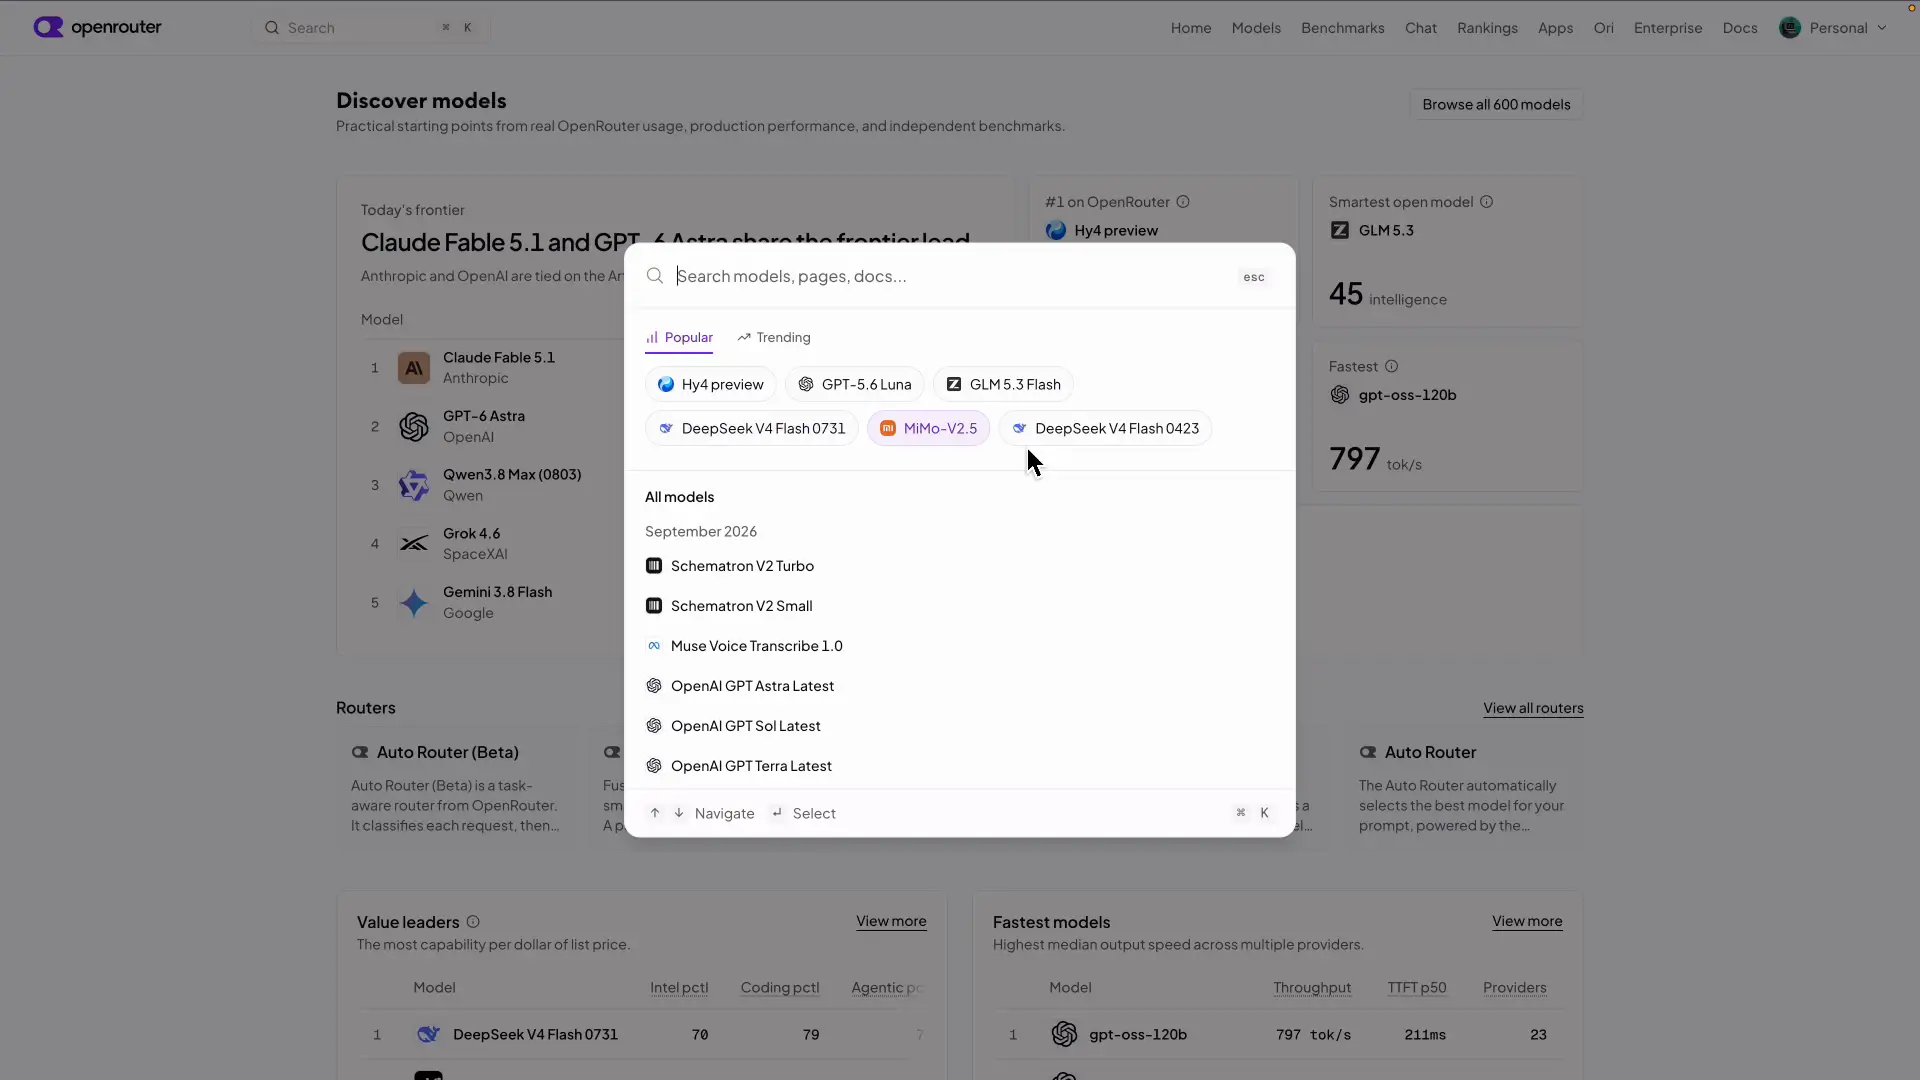
僕が普段やっているのは、OpenRouterでAPIキーを引っ張ってきて試す方法です。重みが公開されているとはいえ容量もメモリも相当食うので、ブラウザベースで使うほうが現実的です。
エージェント系のツールで使う場合は、どれも「OpenAI Compatible」を選んで3つ入れるだけです。
| 項目 | 値 |
|---|---|
| Base URL | https://api.deepseek.com(/v1 は付けない) |
| Model | deepseek-flash |
| API Key | DeepSeekのキー |
Cursorなら Settings → Models → Add Model に入れてVerify、Cline / Roo Code / Kilo / OpenCode も同じ流れです。なお旧モデル名の deepseek-chat と deepseek-reasoner はすでに廃止されています。
ローカルで動かしたいなら27B級を選ぶ
Hugging FaceやLM Studioで重みが公開されているので確認してみましたが、100GBを超える表示が出ます。手軽にローカルで動かせるサイズではありません。
本当にローカルで動かしたい場合、僕のおすすめはQwenの3.8 27Bあたりです。かなり賢く作業できますし、現実的に手元で回せます。ローカル運用を考えている方は、Qwen3.8 27Bをローカルで動かす方法もあわせて参考にしてみてください。
どこで使い、どこで使わないか
いろいろ調べたのと、実際に使ってみた経験からお伝えします。
向いているのは、調べものやデータを読む作業、ピンポイントでのコードやバグの修正です。ここは完全におすすめできます。あとは大量の作業を並列で回すとき。Flashの良さは速さと安さなので、ある程度型が決まっている作業に割り当てる使い方が一番効きます。
逆に使うべきでないのは、コードベース全体を改善するような仕事です。そういう作業は圧倒的にFable 5.1やGPT-6 Astraのような上位モデルに切り替えたほうがいい結果になります。
| 向いている | 任せてはいけない |
|---|---|
| 調べもの、データを読む | コードベース全体の改善 |
| ピンポイントのバグ修正 | 複数サービスにまたがる設計変更 |
| 型が決まった繰り返しの作業 | 本番への不可逆な操作 |
| 大量の作業を並列で回す | じっくり設計する、難しい問題を考える |
面白いのは、この「任せてはいけない」がさきほどのベンチマークの弱点と同じ方向を指していることです。ExploitGymが15.3、ProgramBenchが20.3、Terminal-Bench 3.0が30.0。数字の弱点と、実際に使った体感が一致しています。
運用の型としては、Flashから始めて、検証に2回失敗したら上位モデルへ上げるという切り替えが分かりやすいです。判断するときに見るのは単価ではなく、受け入れられたタスク1件あたりのコスト。総コストを、検証に通った数で割った値です。安いモデルを使うほど得かどうかは、単価ではなく一発で通る率で決まります。
補足|9月14日に消えるはずだったV4 Proは、結局残りました
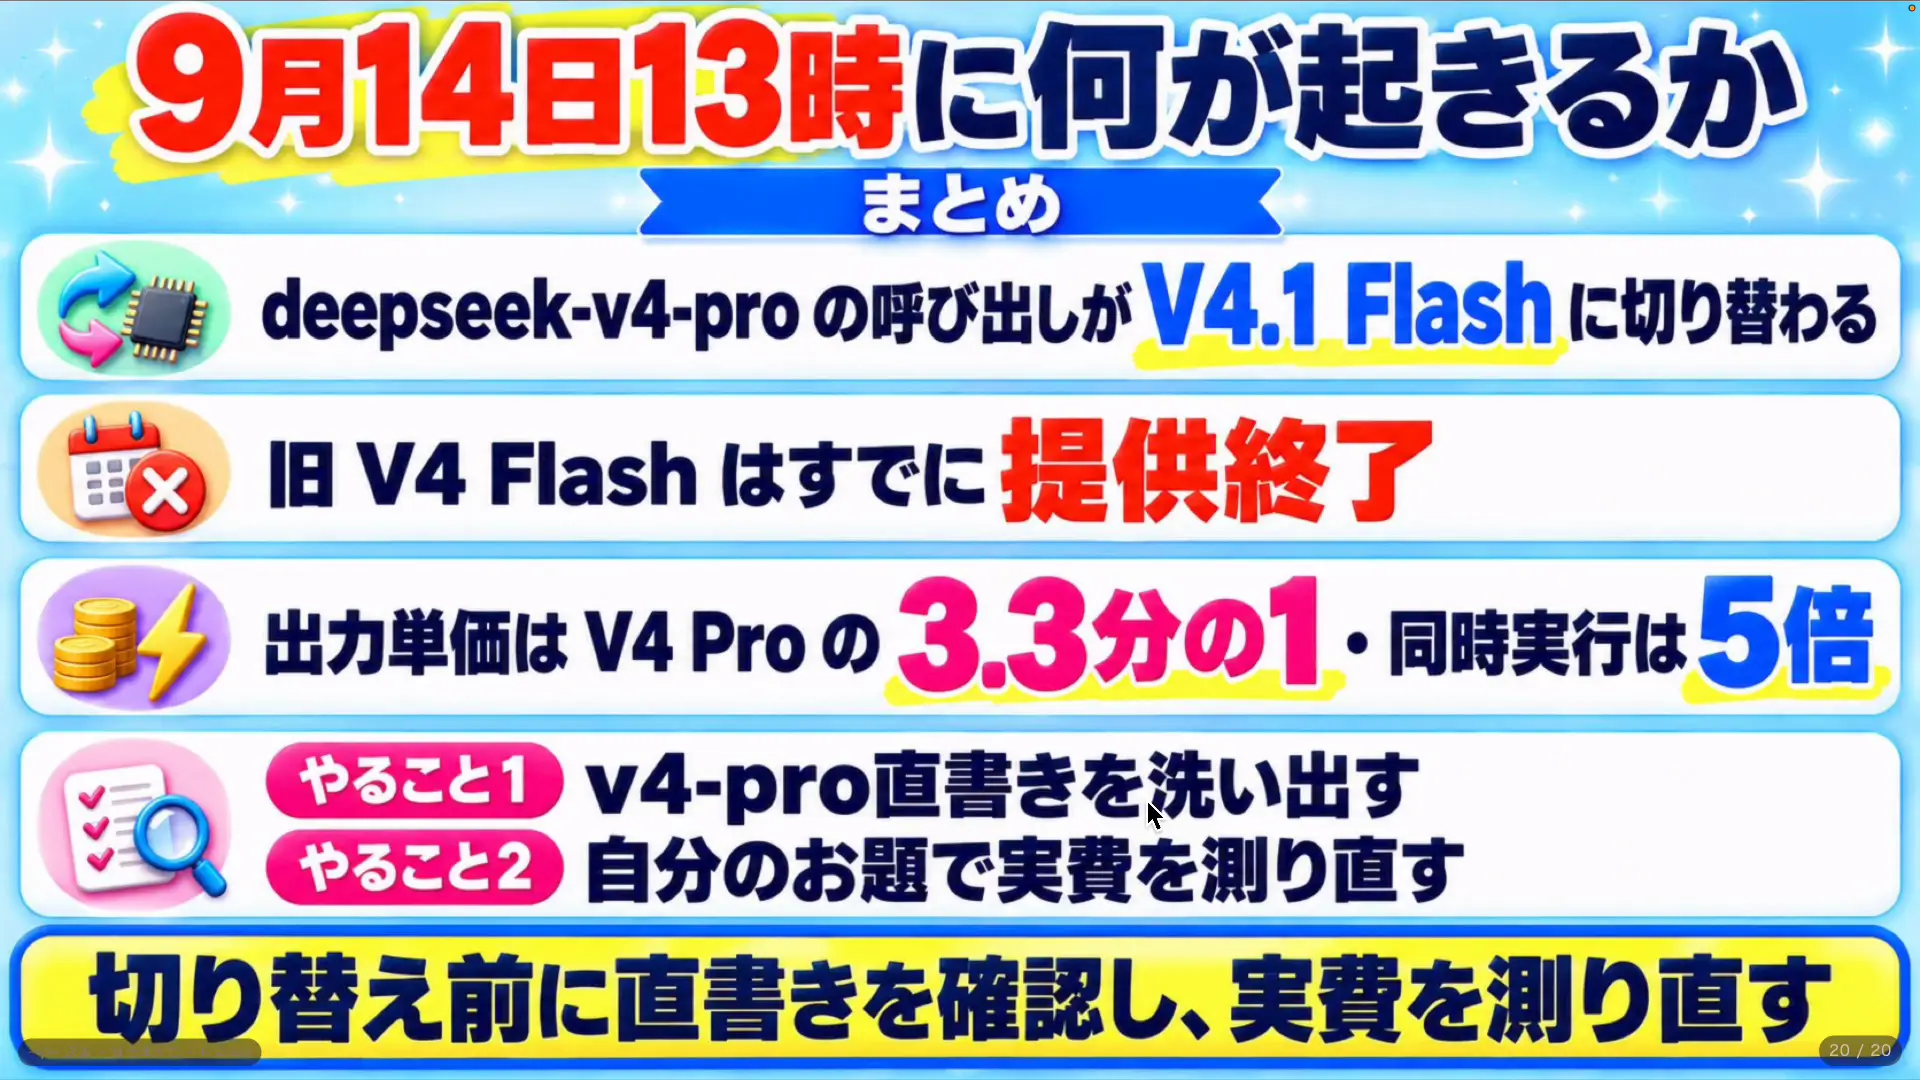
動画の収録時点では、2026年9月14日13時(日本時間)以降、V4 Proへの呼び出しがV4.1 Flashに切り替わるという案内が出ていました。動画内でもそのようにお伝えしています。
ただ、その後DeepSeekが方針を変更しました。公式の価格表に、次のように追記されています。
In response to user demand, we have decided to continue providing API services for DeepSeek V4 Pro after September 14, 2026, with the billing method remaining unchanged.
(ユーザーの要望に応え、2026年9月14日以降もDeepSeek V4 ProのAPI提供を継続する。課金方法も変更しない)
つまりV4 Proは消えませんでした。価格表にも列が残ったままです。乗り換えを急ぐ必要はなくなったので、落ち着いてご自身のお題で比べてから決められます。
ただし旧世代のV4 FlashとV4 Flash Vision Expは予定どおり提供終了しています。deepseek-v4-flash という名前を直接書いている場合、中身はV4.1 Flashに差し替わっているので、こちらは確認しておいてください。
まとめ
- 速度はV4 Proの2.41倍で本物。ただし実費はほぼ同額だった(出力の61%が推論トークン)
- 出力単価はV4 Proの3.3分の1、同時実行は5倍、画像入力にも対応
- ピーク時間帯は日本時間の10〜13時と15〜19時。業務時間はほぼ2倍料金にあたる
- ゲームは遊べるレベルに到達。ただし人体模型のような精密な3Dは苦手
- 調査・ピンポイント修正・大量の並列処理に向く。設計の大変更は上位モデルへ
- 9月14日に消える予定だったV4 Proは、方針変更で存続した
安いモデルが出るたびに乗り換えを考えるより、どの作業をどのモデルに割り当てるかを決めておくほうが、結果的にコストは下がります。決まりきったタスクを回す部分をFlashに任せて、設計や難しい判断は上位モデルに残す。この使い分けができると、月の請求がはっきり変わってきます。
みなさんがDeepSeekをどんな作業に使っているか、「ここは任せられる」という使い方があれば、ぜひコメント欄で教えてください。

