この記事でわかること
- LM Studioに並ぶQwen3.8の名前の違い(27B・2.4T・4bit・MLX)
- 自分のMacのメモリなら、どの版を選ぶべきか
- ローカルAIで実際に何が作れて、何が苦手なのか
- 完全無料でオフラインのAIを手元に置く手順
「電気代以外は一円もかからないAIで、3Dのブロック崩しが一発で動きました。ネットを切っても使えます」
これまでローカルで動くAIといえば、性能を我慢して使うものでした。それが今回のモデルでは、手元のMacに置いたまま3Dゲームのコードが書けるところまで来ています。しかもライセンスはapache-2.0で、商用利用も改造も自由です。
こんにちは、ルーティンラボ(@rutinelabo)です。本記事では、アリババがリリースしたオープンウェイトの生成AI「Qwen3.8 27B」を、実際にMacへダウンロードして動かした結果をまとめます。以前Qwen3.8の最新モデルを実機検証した記事ではAPI経由での性能を見ましたが、今回は同じ名前でも中身がまったく違う、手元で動くほうの話です。
-

-
Qwen3.8を実機検証|Fable 5に次ぐは本当か?料金と使い方も解説
続きを見る
プロンプト配布中
LINE公式アカウントを友達追加していただければ、本記事やYouTubeで使用した使用したプロンプトを配布いたします。メンバーシップ登録で優先サポートも実施中です。
オープンウェイトとは何か
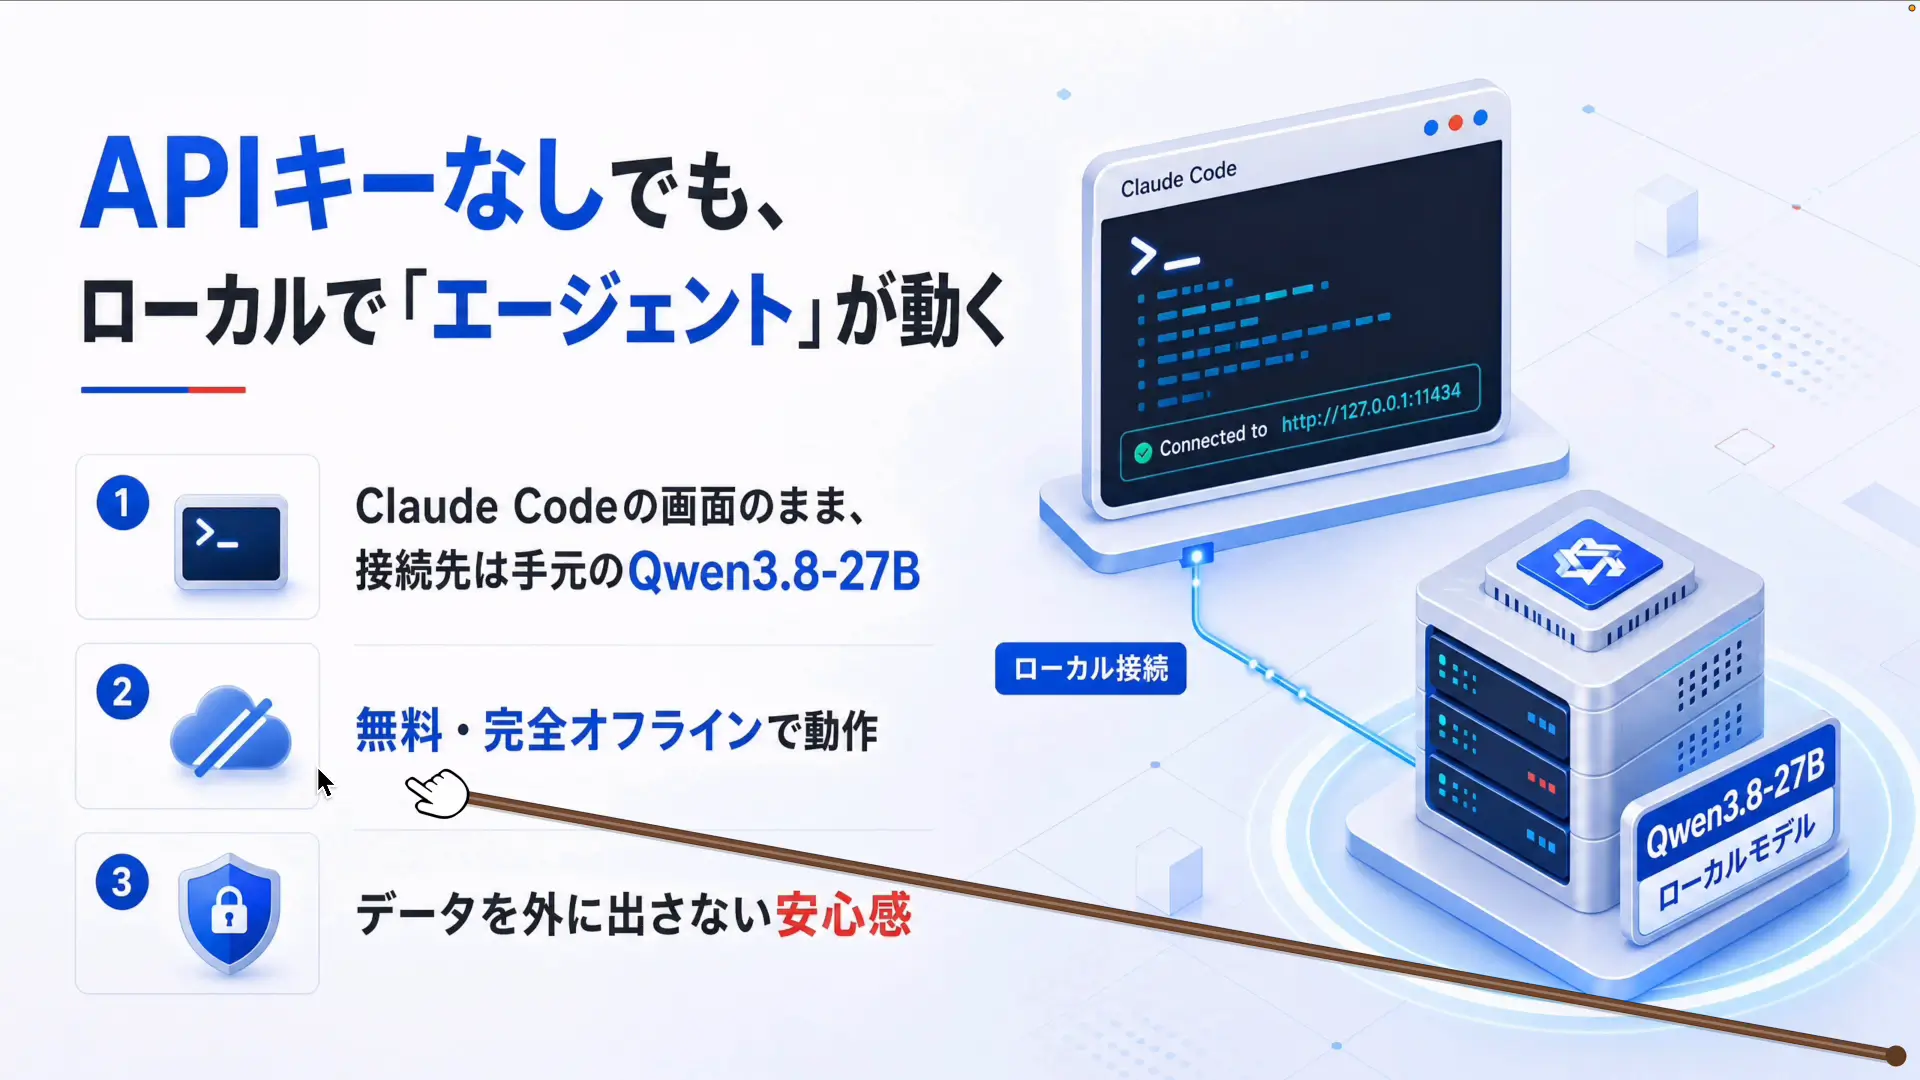
普段使っているChatGPTやClaudeは、サブスクに登録するかAPIキーで使った分だけ支払う仕組みです。処理は提供元のサーバーで動いていて、こちらは結果を受け取っているだけになります。
オープンウェイトはこの前提が変わります。モデルそのものを自分のパソコンにダウンロードして動かす方式で、計算しているのは手元のGPUです。そのため使用料は発生せず、インターネット接続も要りません。飛行機の中でも同じように動きます。
弱点もあります。クラウドの最上位モデルより精度は落ちますし、速度は自分のマシンの性能そのものです。それでも「無料」「オフライン」「情報が外に出ない」の3つは、クラウド側では原理的に手に入りません。
Qwen3.8 27Bとは|2.4Tとは名前が似ているだけの別物
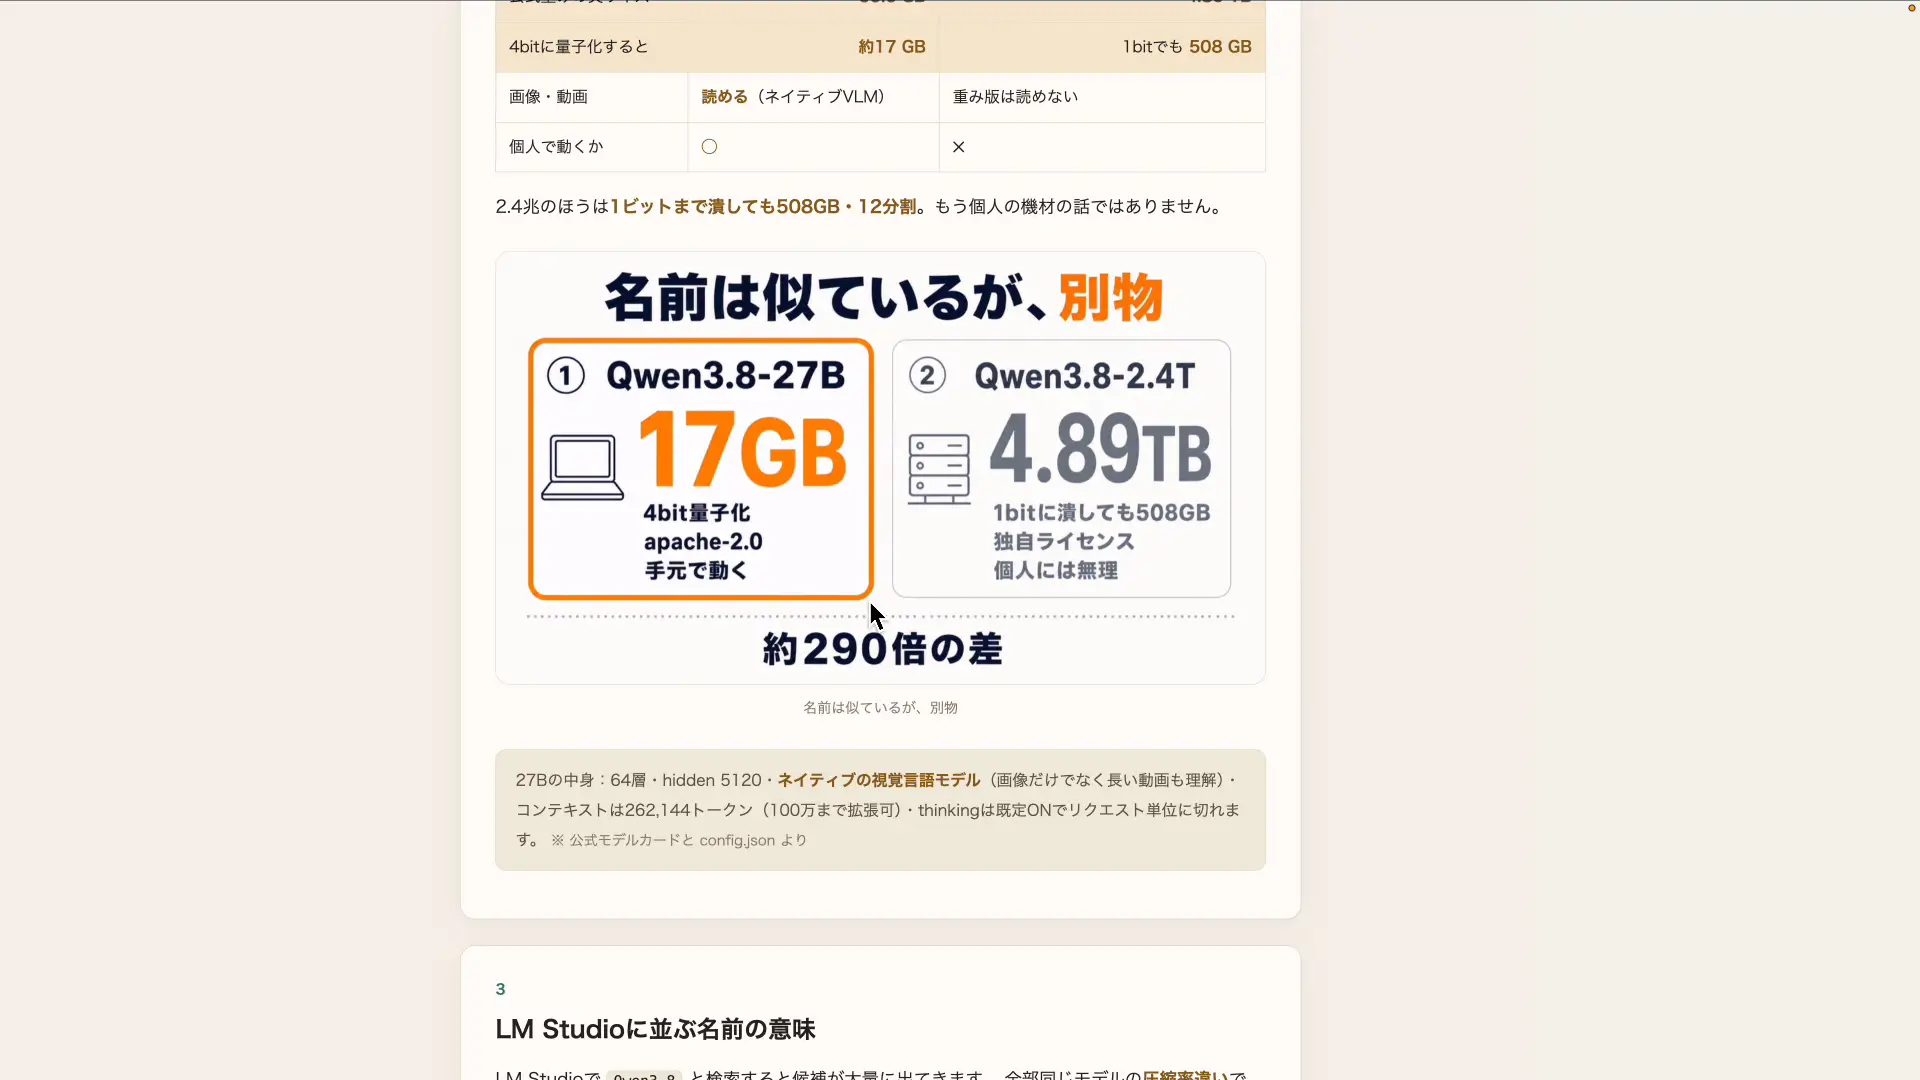
Qwen3.8 27Bが公開されたのは2026年8月14日、日本時間では15日の未明にあたります。ライセンスはapache-2.0で、承認申請なしにそのままダウンロードできます。
ここが最初のつまずきポイントです。Qwen3.8には「27B」と「2.4T」という2つのオープンウェイトがあり、名前が似ているだけで実体はまったく違います。片方は個人のパソコンで動き、もう片方は動きません。
数字で並べると差が分かりやすくなります。公式が配っている重みのファイルサイズを実際に足し合わせた値が以下です。
| 項目 | Qwen3.8-27B | Qwen3.8-2.4T-A95B |
|---|---|---|
| 構造 | 27B デンス(全部使う) | 2.4兆 MoE(一部だけ動く) |
| 公式重みの実サイズ | 55.6 GB | 4.89 TB |
| 限界まで圧縮すると | 2bitで 9.0 GB | 1bitでも 508 GB |
| ライセンス | apache-2.0 | 独自ライセンス(条件つき) |
| 個人のPCで動くか | 動く | 動かない |
(2026年8月時点・Hugging Face公式リポジトリのファイルサイズを実測)
2.4兆のほうは1ビットまで潰しても508GBあり、もう個人が持ち歩く話ではありません。実際いいね数は27Bが9,895、2.4Tが611と約16倍の差です。もうひとつ大きいのがライセンスで、27Bはapache-2.0のため商用利用も改造も自由ですが、2.4Tは条件つきの独自ライセンスなので同じ扱いにしないでください。
この「巨大すぎて個人には届かない」問題は、以前Kimi K3のオープンウェイトを検証した記事でも同じ壁にぶつかりました。動画でも解説しています。
-

-
Kimi K3のオープンウェイトは個人で動くか|1.56TBの現実と使い方
続きを見る
LM Studioに並ぶ名前の読み方|MLXとGGUF、量子化の数字

ローカルでAIを動かす入口はいくつかありますが、今回はLM Studioという無料ソフトを使います。GUIで完結するので、ターミナルを触らずに始められるのが利点です。
ところがLM Studioの検索窓に「Qwen3.8」と打つと、候補が大量に出てきて手が止まります。27Bの後ろに4bitや8bit、MLXやGGUFといった文字が並ぶからです。ここを2つのルールで整理します。

| LM Studio上の表記 | 実体 | サイズ | 誰向け |
|---|---|---|---|
| Qwen3.8-27B Q4_K_M | 4bit量子化・GGUF | 17.1 GB | Windows・Linuxの定番 |
| 同 Q6_K | 6bit・GGUF | 22.4 GB | 品質を上げたいとき |
| 同 Q8_0 | 8bit・GGUF | 29.0 GB | ほぼ無劣化 |
| 同 UD-IQ2_XXS | 2bit(極限圧縮) | 9.0 GB | 低スペック機の最終手段 |
| MLX 4bit | Apple Silicon専用 | 16.1 GB | Macならこれ |
| MLX 8bit | Apple Silicon専用 | 31.5 GB | メモリに余裕のあるMac |
| mmproj-…BF16 | 画像認識用の追加部品 | 0.9 GB | 画像を読ませるなら必須 |
(2026年8月時点・Hugging Faceのファイル一覧を実測。いずれも10進GB表記)
ひとつ注意点があります。LM Studioの画面に出る数字は、上の表と少しずれて見えます。8bitなら約29.5、Q4_K_Mなら約17.7といった具合です。これはGBとGiBという単位の違いによるもので、中身は同じファイルです。ディスクの空き容量を見積もるときは、大きいほうの数字で考えておくと安全です。
覚えるルールは2つだけ
覚えることは2つだけです。数字が大きいほど高品質で重いこと、そしてMacはMLX、WindowsとLinuxはGGUFを選ぶこと。この2点さえ押さえれば、大量に並んだ候補が一気に絞り込めます。
画像を読ませたい人がハマる落とし穴
Qwen3.8 27Bは画像や動画を理解できるモデルですが、本体だけを落としても画像は読んでくれません。mmprojという0.9GBの追加部品を一緒に入れる必要があります。同じ画面から一緒にダウンロードできるので、忘れずにチェックしてください。
自分のMacはどれを選ぶべきか|メモリ別の早見表
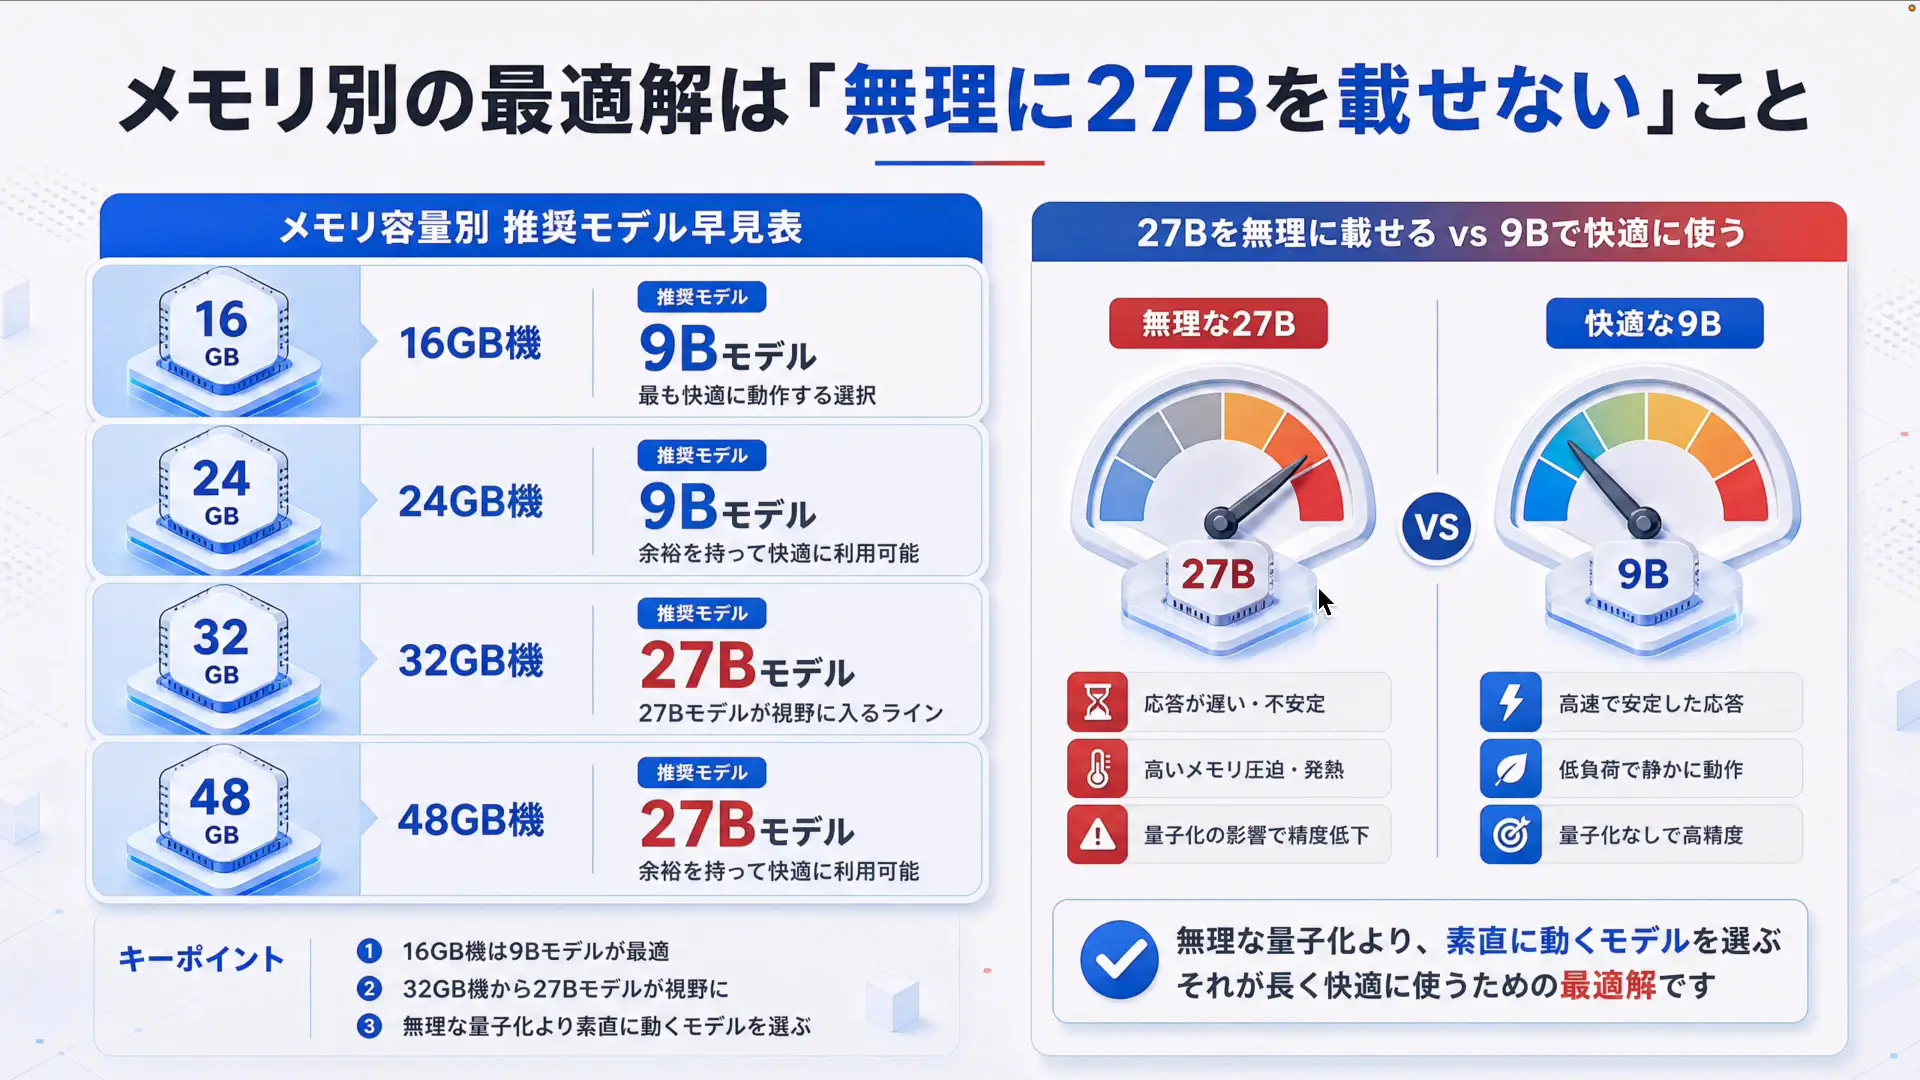
次に迷うのが「自分のマシンで動くのか」です。ここは搭載メモリから逆算すると答えが出ます。
Apple Siliconは統合メモリという仕組みで、CPUとGPUが同じメモリを分け合います。そのうちGPUに回せるのは搭載メモリの約75%で、64GBのマシンなら約48GBが上限です。ここにモデル本体と文脈の分、さらにmacOSとアプリの使用分が乗ります。
| 搭載メモリ | GPUに回せる上限 | 選ぶべき版 | サイズ |
|---|---|---|---|
| 16 GB | 約12 GB | Qwen3.5-9B MLX 4bit(27Bは載らない) | 6.0 GB |
| 24 GB | 約18 GB | Qwen3.5-9B MLX 8bit | 10.4 GB |
| 32 GB | 約24 GB | Qwen3.8-27B MLX 4bit | 16.1 GB |
| 48 GB以上 | 約36 GB〜 | Qwen3.8-27B MLX 8bit | 31.5 GB |
(2026年8月時点・実機のsysctlとHugging Faceのファイルサイズから算出)
僕はMacBook Pro M3 Maxの64GBで検証したので、MLX 8bitを選びました。一方でMacBook AirやMac miniは16GBの方が多いはずです。16GBで27Bを動かすのは諦めるのが正解で、2bitまで潰せば起動はしますが、劣化した27Bより素直に動く9Bのほうが実用では勝ちます。
17GBはストレージかメモリか
多くの人が混乱するのが「17GBはストレージなのかメモリなのか」という点です。答えは両方で、消費するタイミングが違います。
| 何に必要か | いつ消費するか | |
|---|---|---|
| ストレージ | ダウンロードして置いておく | 消すまでずっと占有 |
| メモリ | ロードするとほぼ丸ごと乗る | ロード中だけ(解放できる) |
ここを取り違えると、ストレージに余裕があるからと大きい版を落として、いざロードしたらメモリが足りずに落ちる、という事故が起きます。
なお、MacBook Airにはファンがありません。数分でサーマルスロットリングが入るうえ、推論の速度はメモリ帯域でほぼ決まるため、Pro系のチップとは体感が変わります。長時間まわす用途には向かないと考えておいてください。
実際にダウンロードして動かす手順
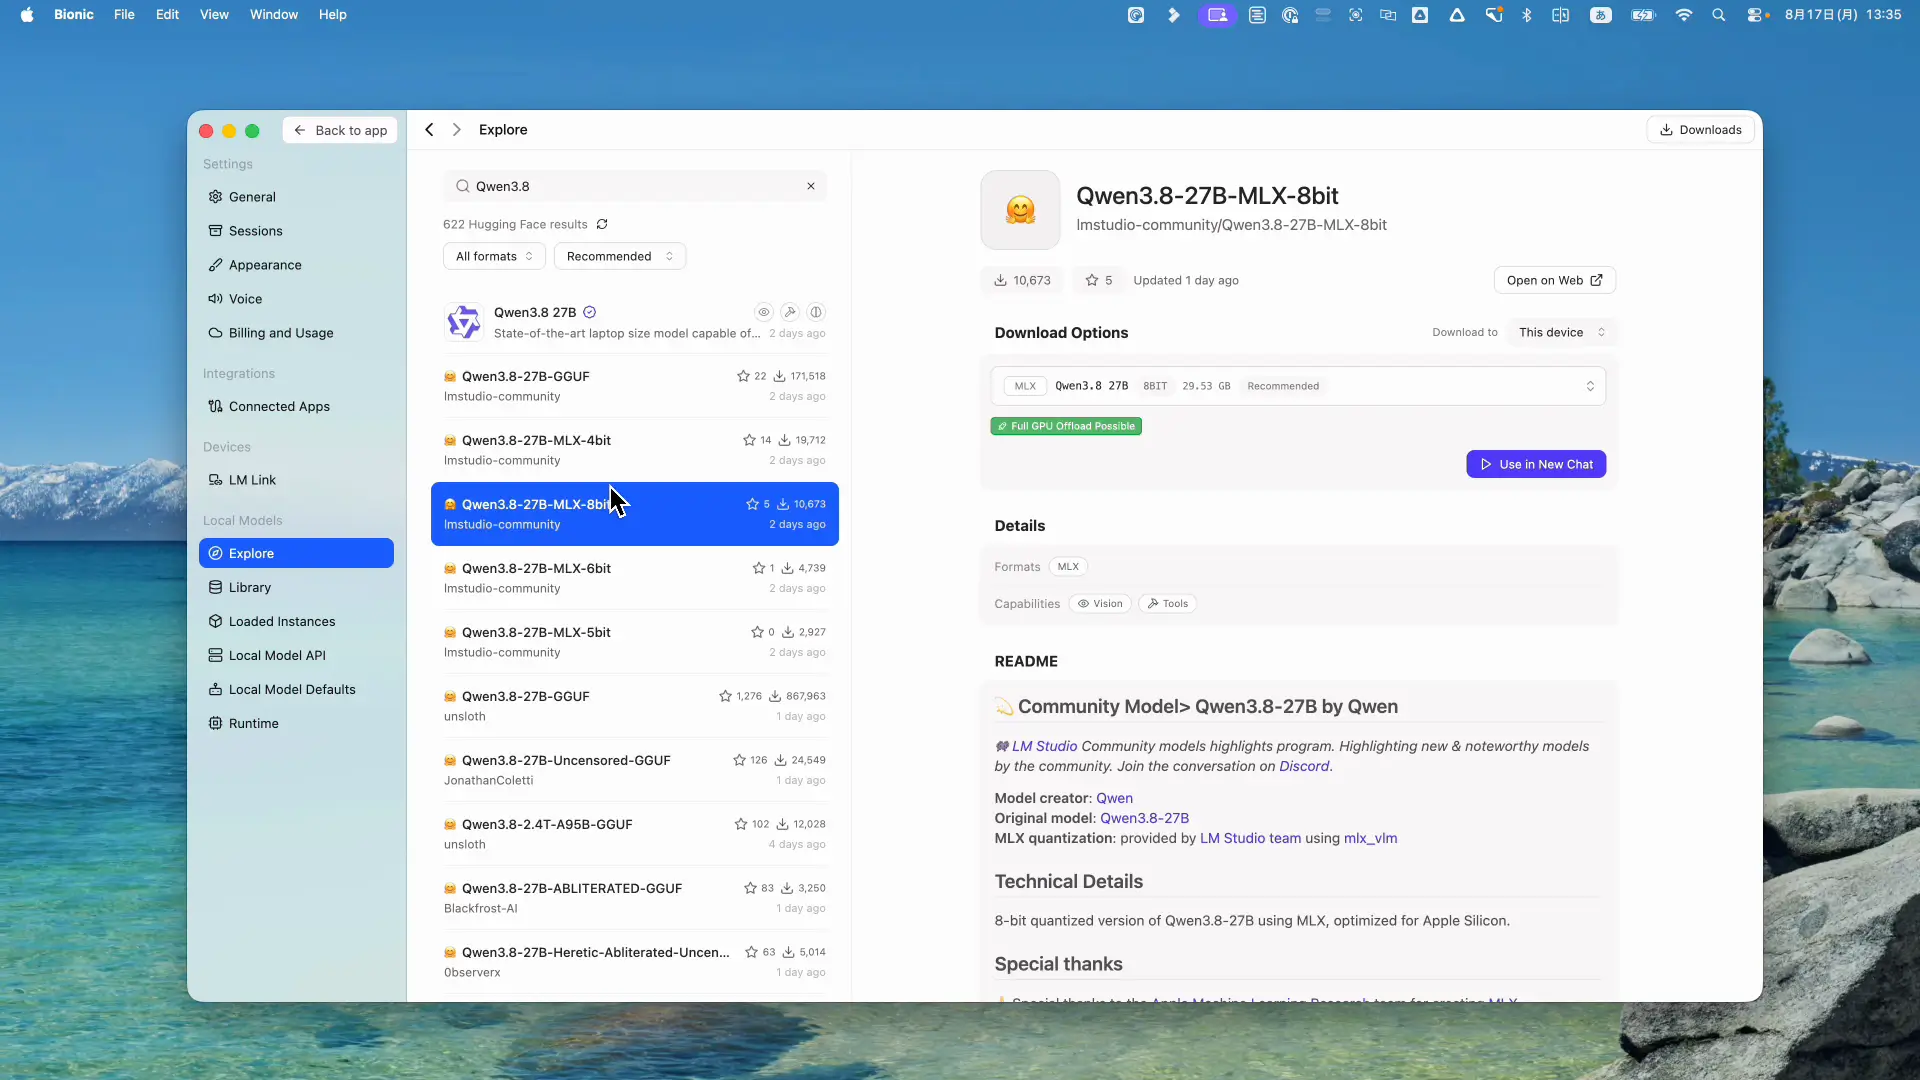
ここからは実際の流れです。LM Studioを入れてしまえば、あとは検索窓からダウンロードするだけで動きます。
step
1LM Studioの検索窓でモデルを探す
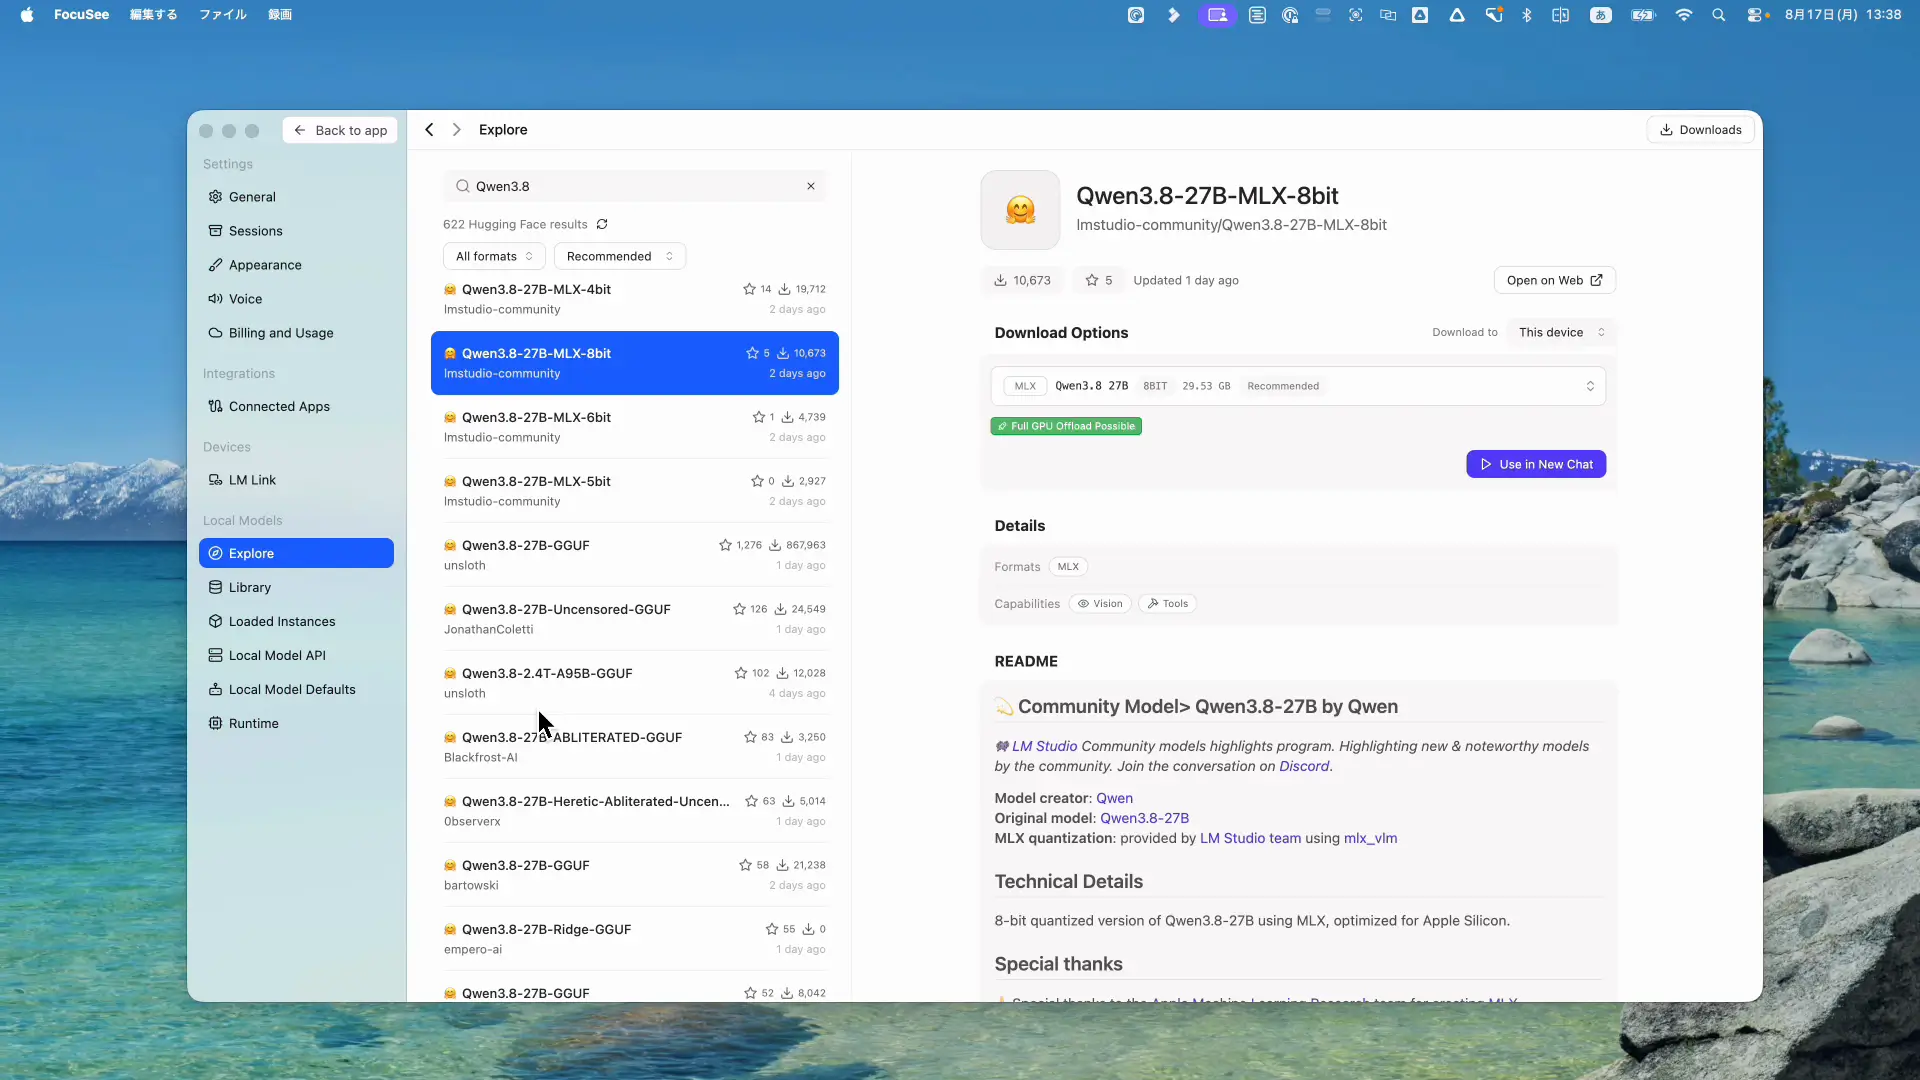
検索窓に「Qwen3.8-27B」と入力すると、前の章で整理した候補がずらりと並びます。Macなら表記にMLXが入ったもの、WindowsとLinuxならGGUFのものを選びます。
step
2メモリに合った量子化を選んでダウンロードする
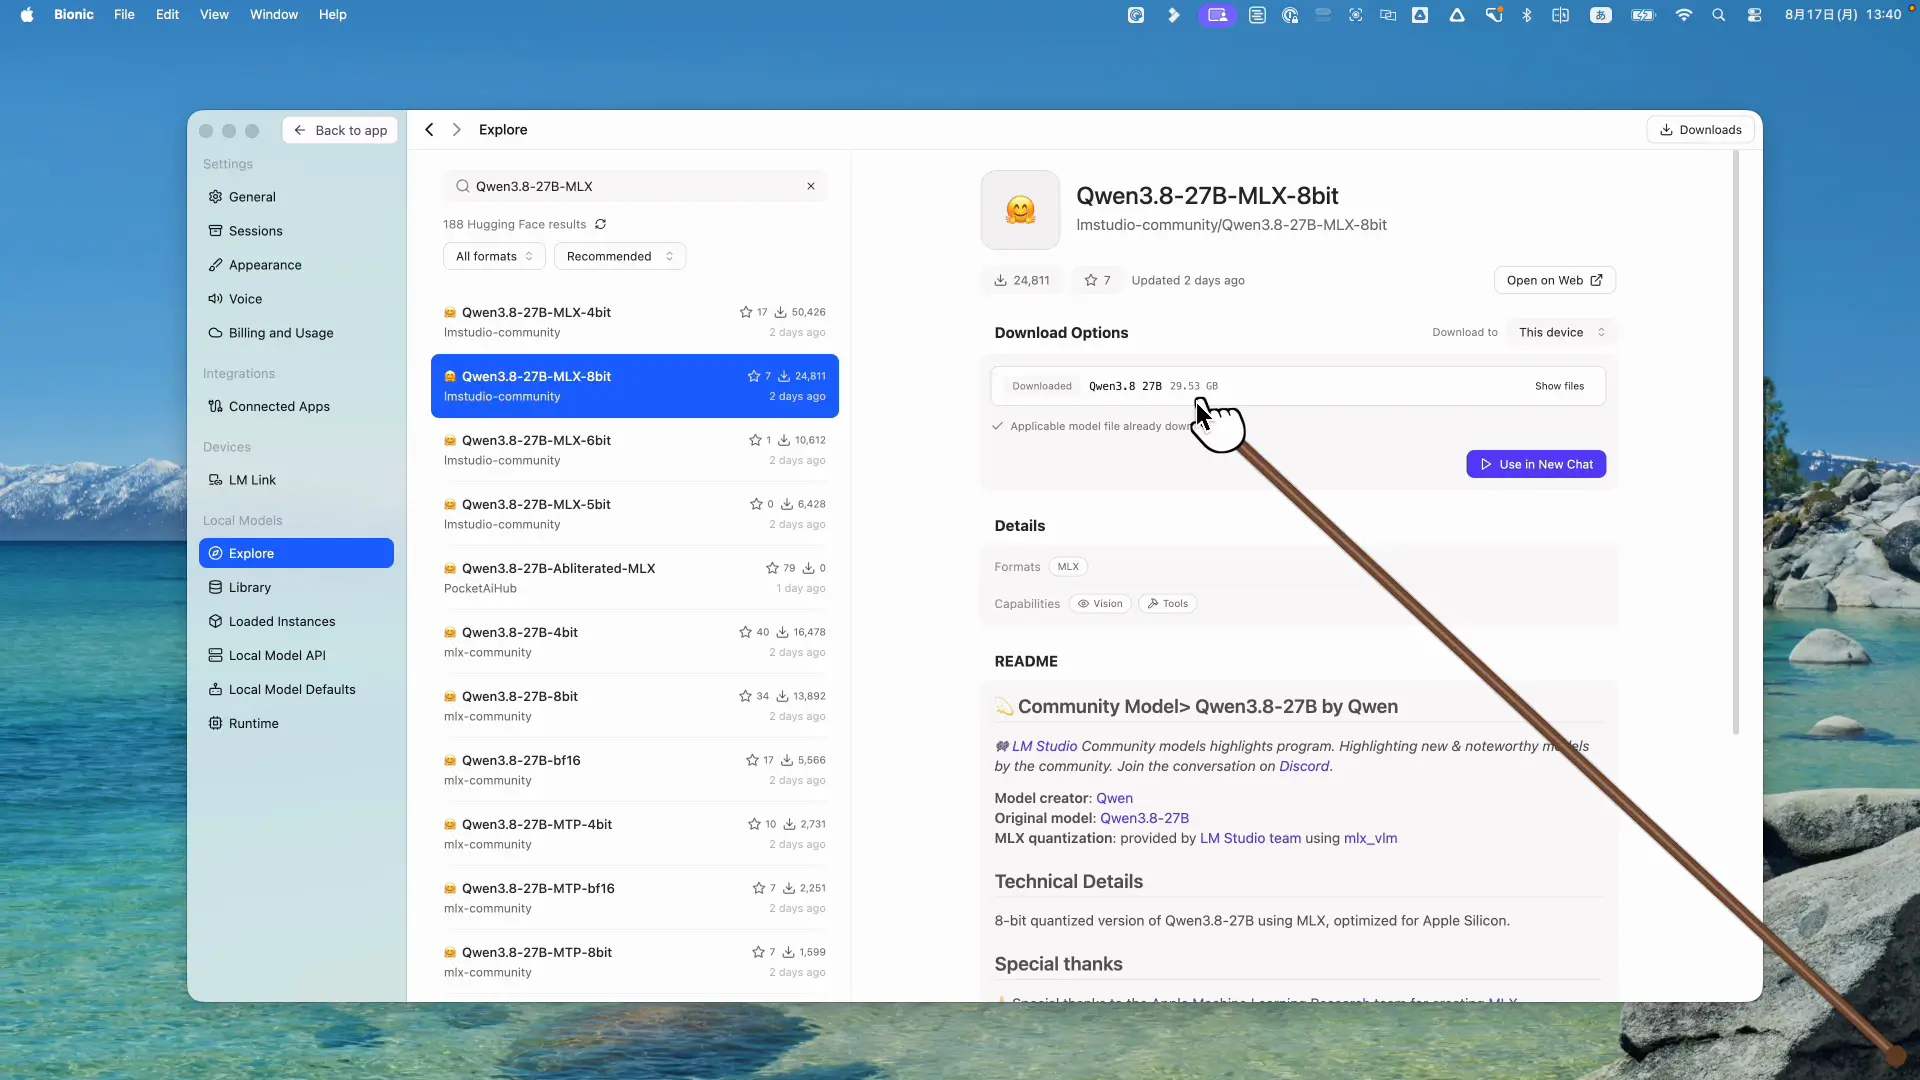
前章の早見表に沿って版を決めます。画像も読ませたい場合は、mmprojが一緒に入るかをここで確認してください。緑色の「Full GPU Offload Possible」というバッジが出ていれば、そのマシンのGPUメモリに全部載るという意味です。
step
3ロードして動作を確認する
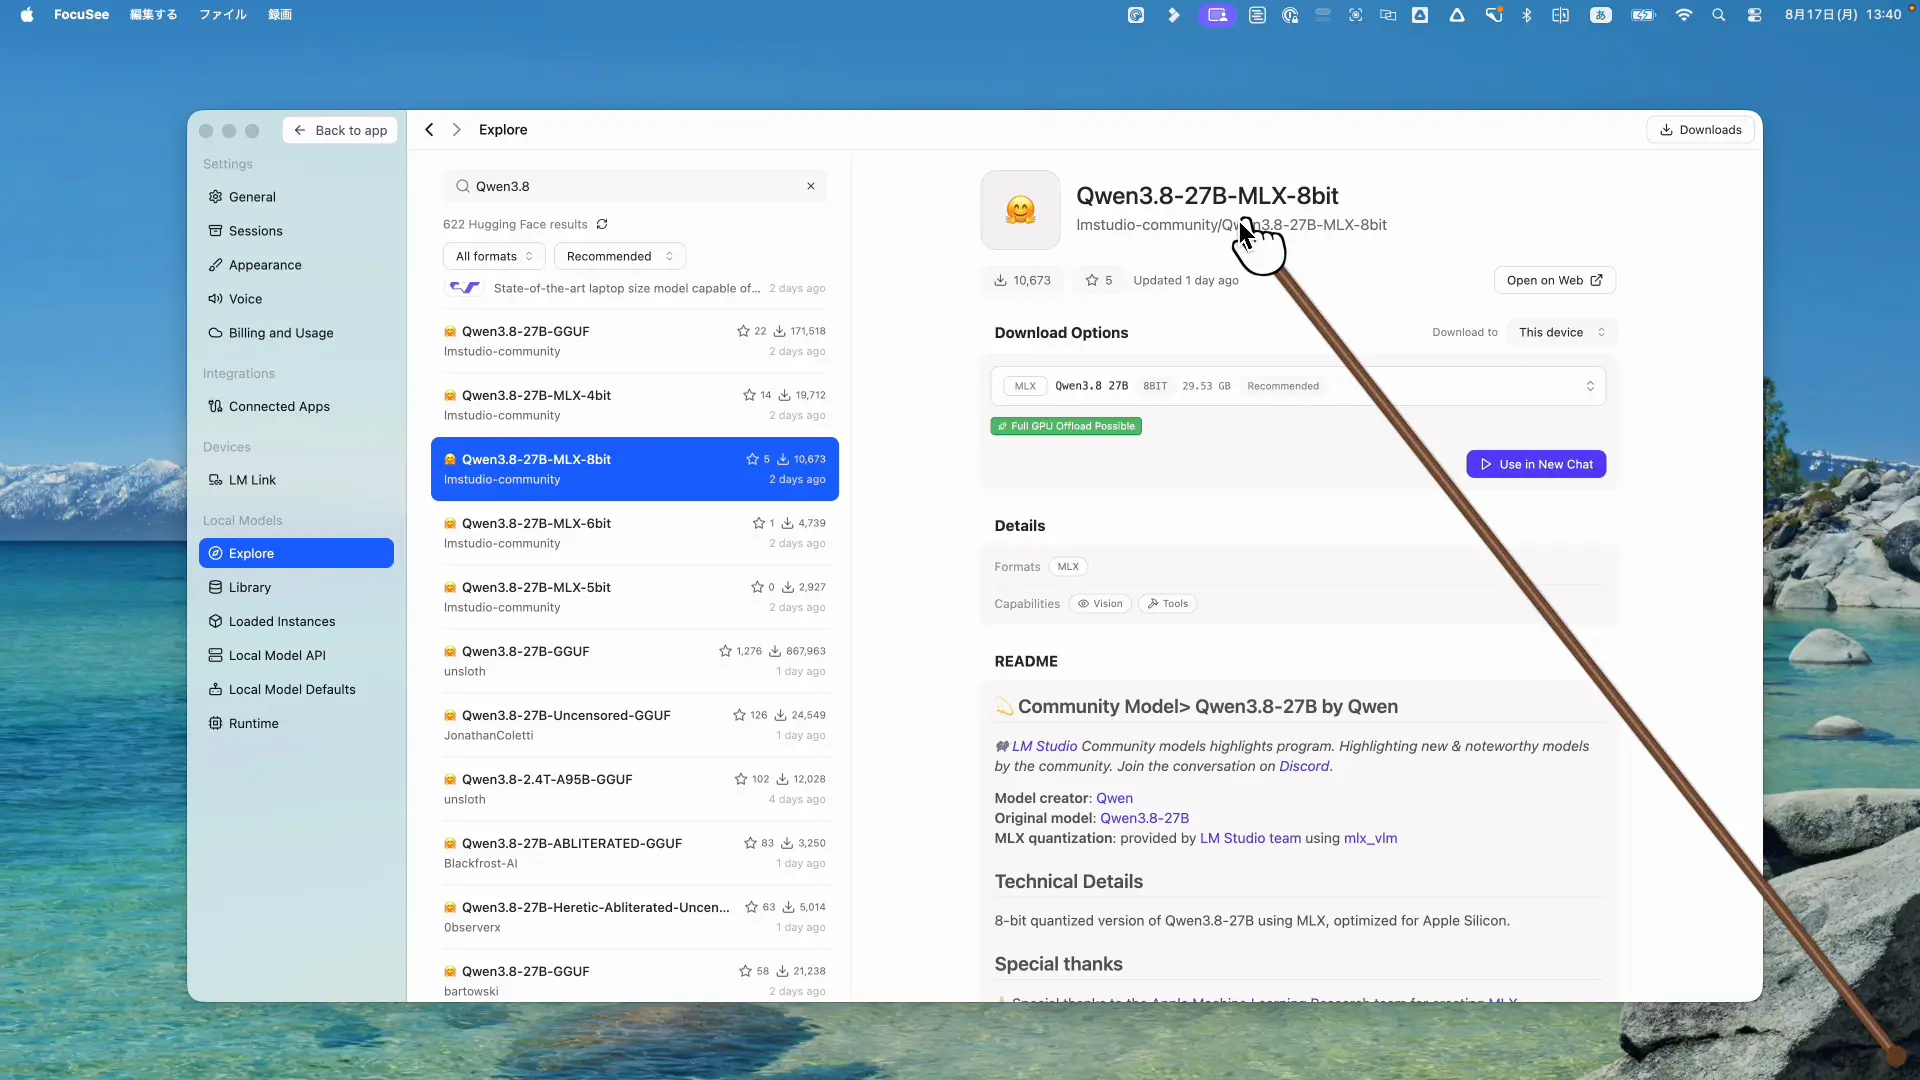
ロードするとメモリ使用量が一気に跳ね上がります。アクティビティモニタを開いておくと、モデルがメモリに乗る様子がそのまま見えます。あとは通常のチャット画面と同じように使えます。
ダウンロードでつまずいたときのコツ
30GB近いダウンロードは途中で止まることがあります。ただし部分的にダウンロードした分は保持されるので、再開すれば続きから進みます。もうひとつ、重いダウンロードと重い生成を同時に走らせると生成側が接続エラーで落ちました。どちらかが終わってから次を始めるのが安全です。
実際に作らせてみた|3Dは得意、細かい挙動は苦手
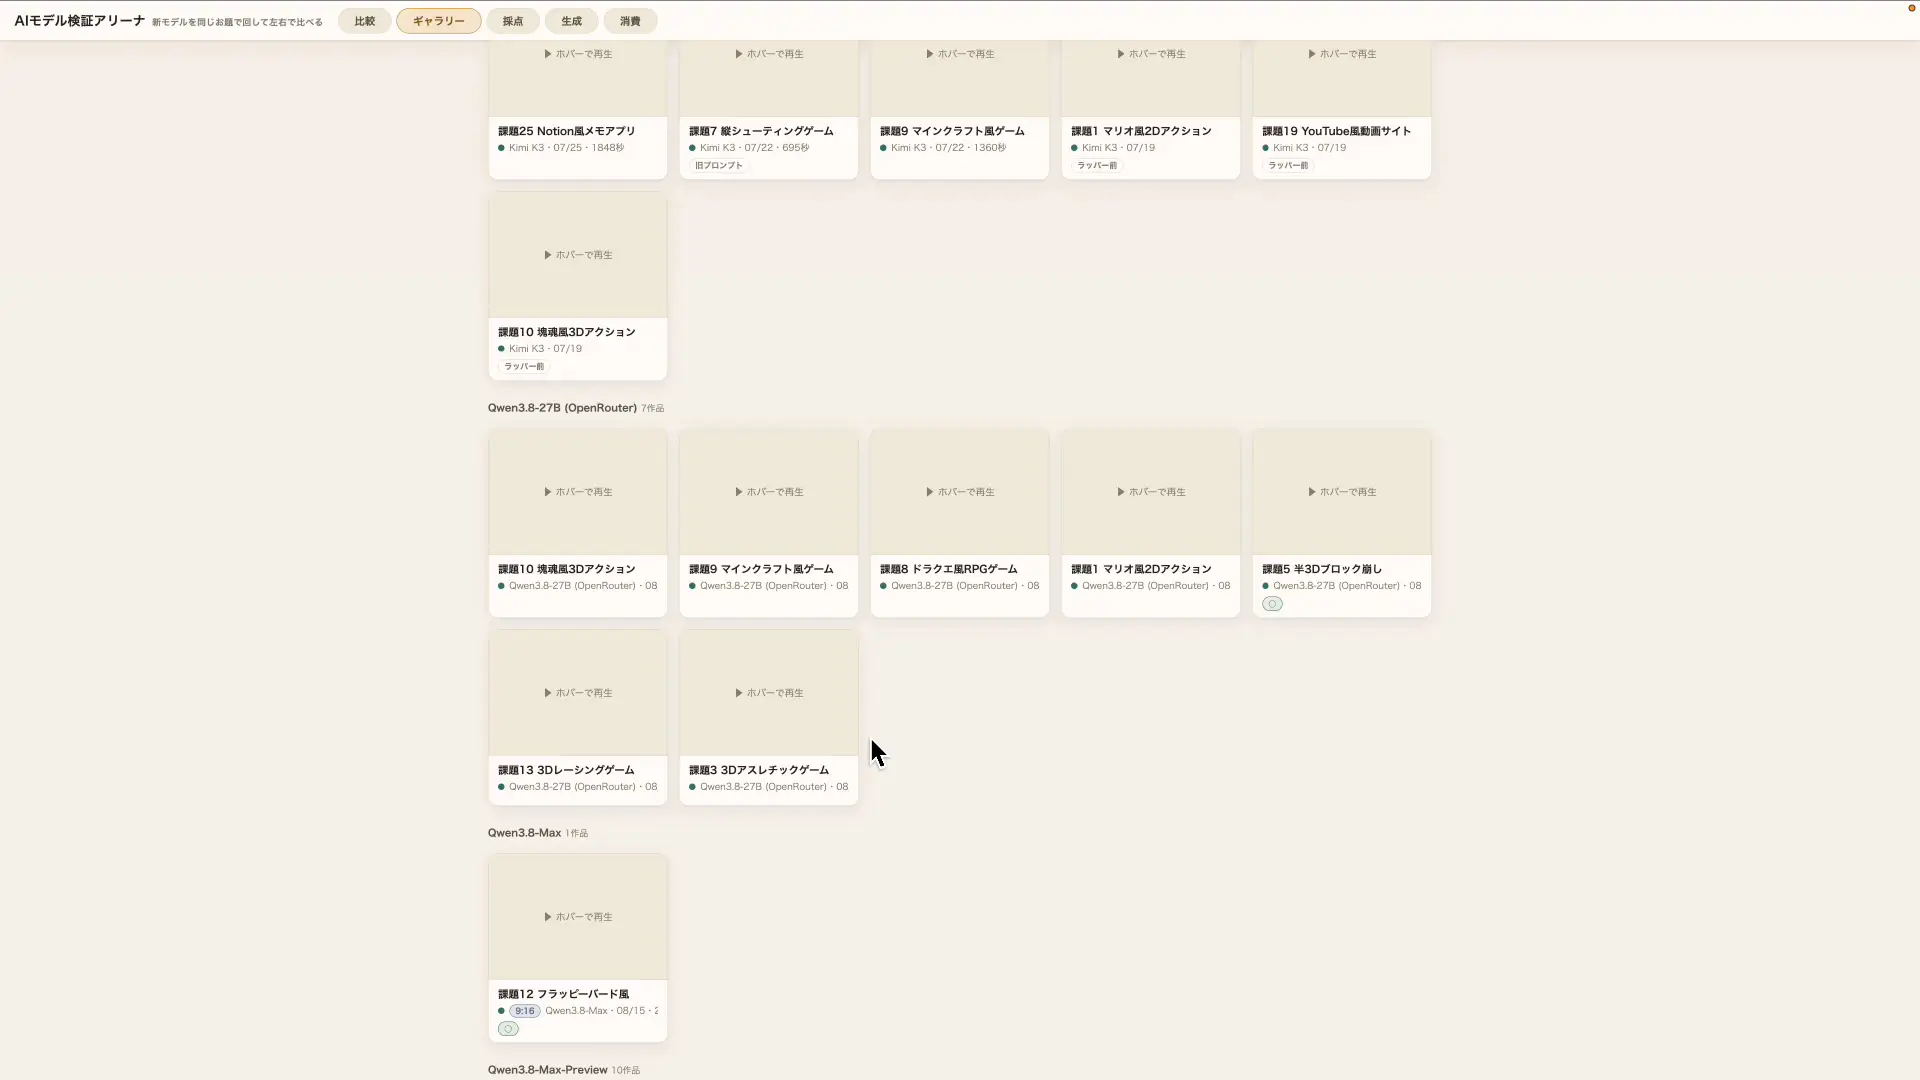
ここからが本題です。どこまでのものが作れるのかを、ゲームのコード生成で確かめました。なお今回の生成物は時間の都合でOpenRouter経由のAPIで回しています。同じモデルなので出力の傾向は変わりませんが、手元で動かしたときの速度はマシンの性能に依存します。
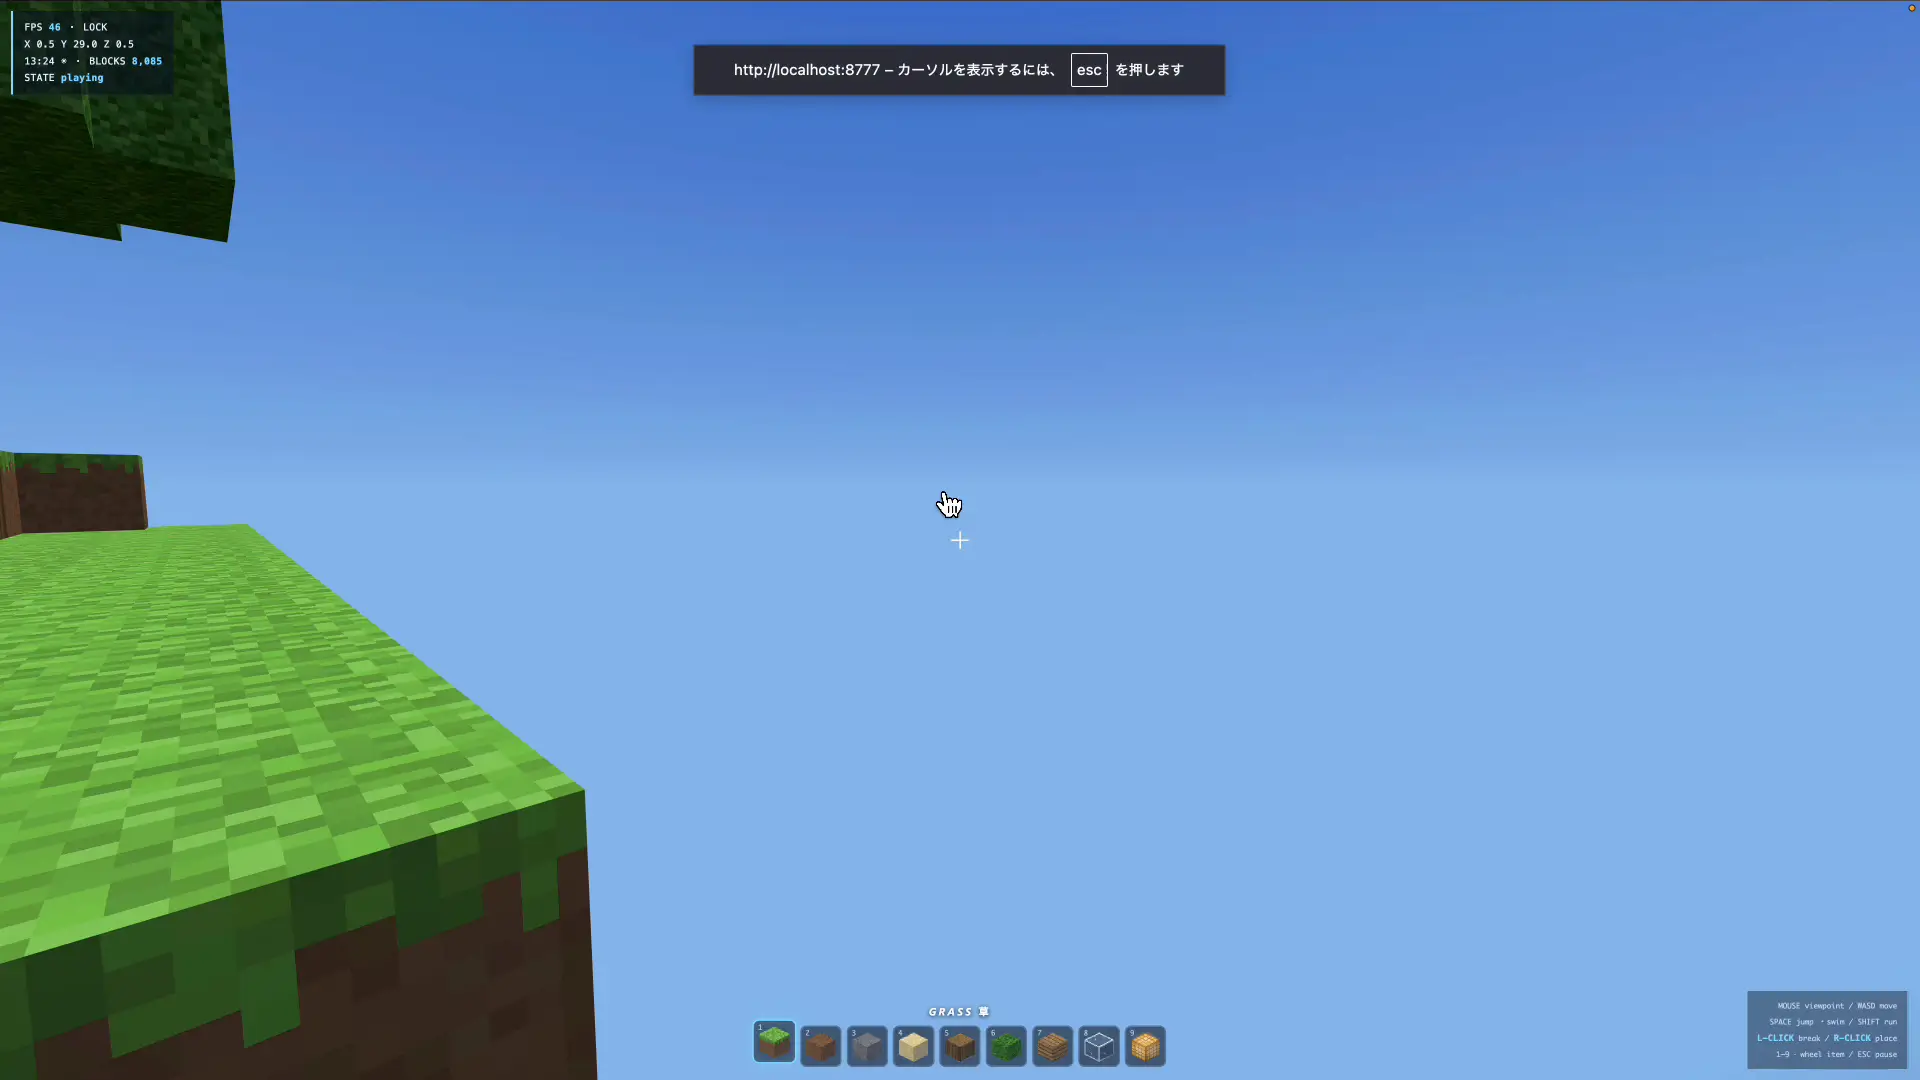
いちばん驚いたのがマインクラフト風のゲームです。ステージの構成まで組まれていて、ブロックを壊すときの滑らかさも破綻がありません。これがワンショット、つまり一度の指示で出てきました。
3Dのブロック崩しや、玉を転がして物を集めるタイプのゲームも問題なく動きました。立体表現とその中での物理的な動きは、かなり得意な部類だと感じています。

一方で、うまくいかなかったところも正直に書きます。キャラクターが移動できない、2Dのアクションゲームでジャンプが機能しない、壁をすり抜けてしまう、といった不具合が出ました。派手な3D表現は一発で通るのに、細かい当たり判定のほうが崩れるという、少し意外な傾向です。
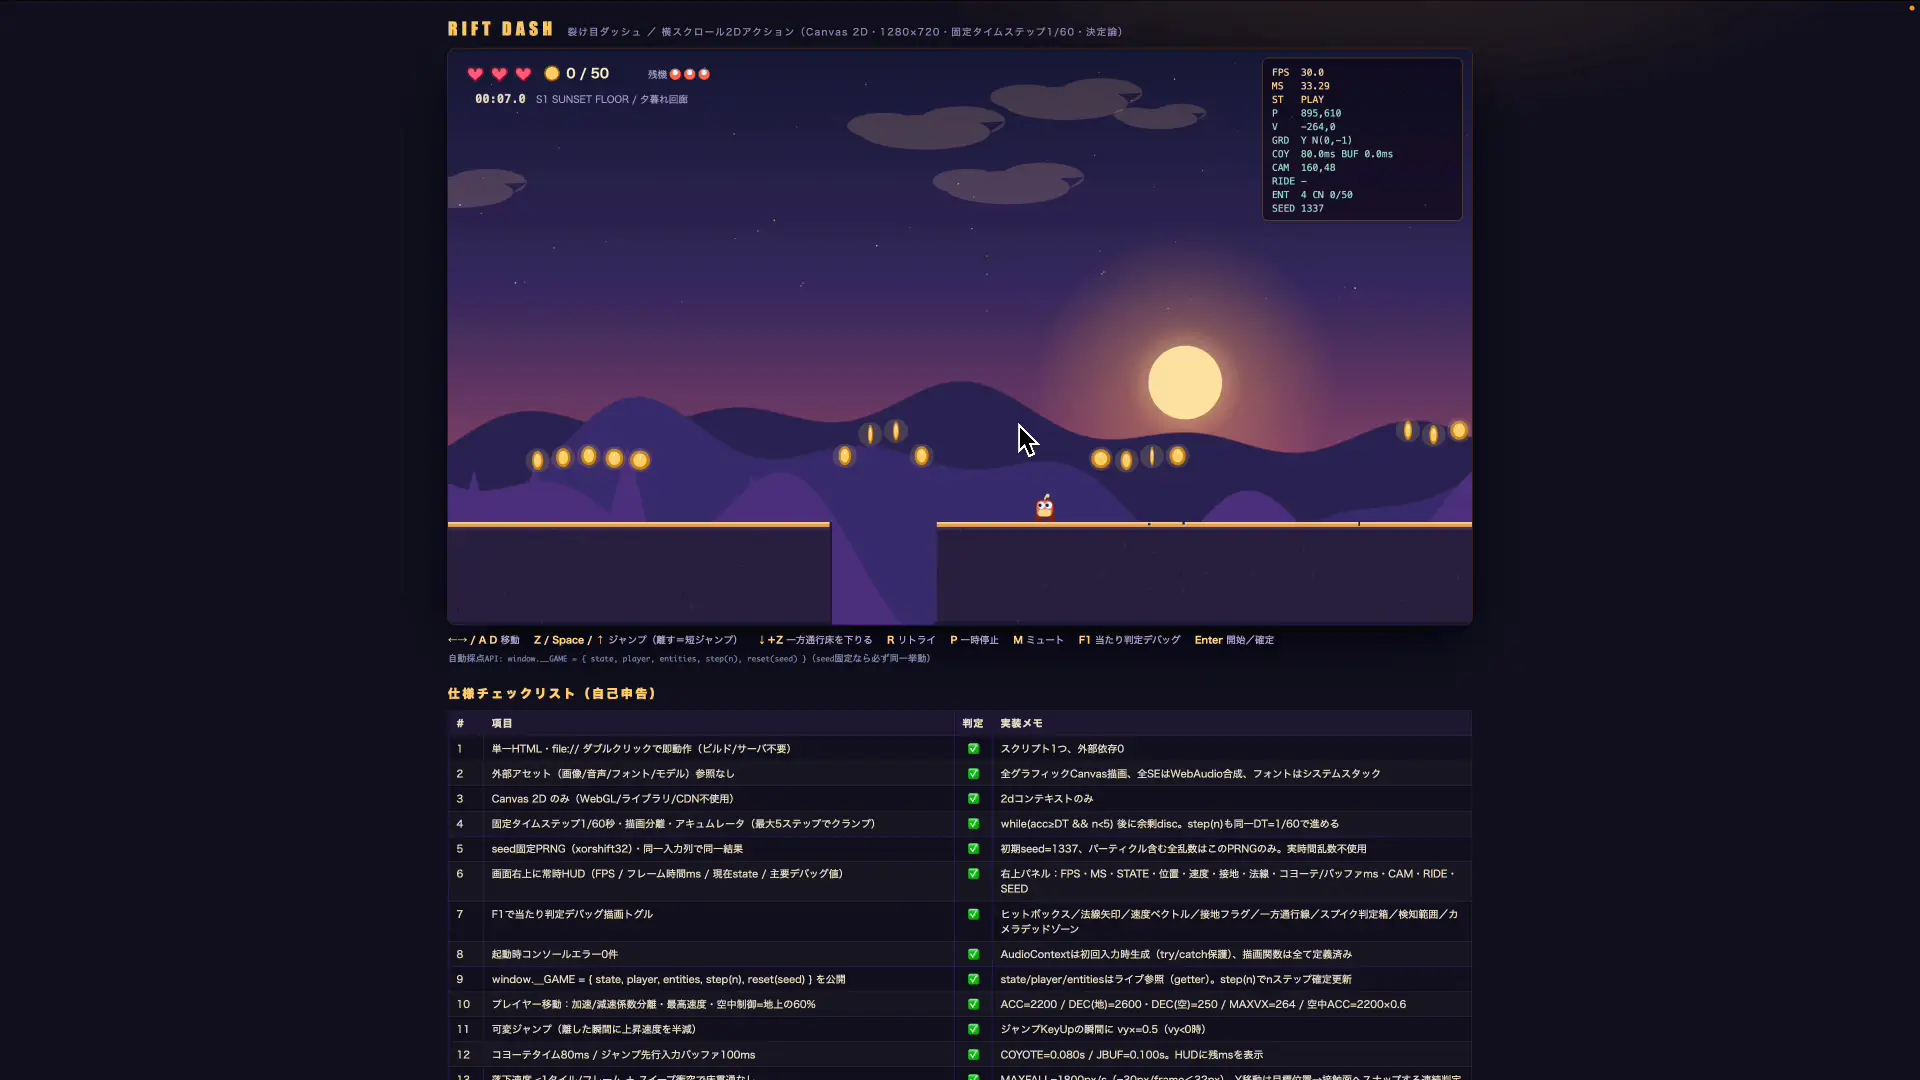
この差は使い分けの指針になります。立体的なものを一気に形にするのは得意なのでプロトタイプ向きですが、細かい挙動を詰める作業は修正の往復が増えると考えておくとよいでしょう。
得意なこと、苦手なこと
ひと通り触って見えた輪郭を整理します。前提として、クラウドの最上位モデルと同じ土俵で戦うモデルではありません。
- 得意:3Dの表現を含むコード生成、プロトタイプを一気に形にする作業
- 得意:画像や動画を読み取らせる使い方(mmprojが必要)
- 得意:262Kの長い文脈を使った読み込み
- 苦手:細かい当たり判定など、シンプルだが正確さが要る実装
- 苦手:長時間の自律作業。時間がかかりすぎるという声が多い
- 苦手:全体の構成を設計しながら進める、複雑な仕組みづくり
長時間まわす自律的な作業に向かないという点は、ネット上の利用者の声とも一致しています。短い試行を何度も回す使い方のほうが、このモデルの持ち味は出ます。
公式のベンチマークをどう読むか
公式モデルカードにはベンチマークの比較表が載っています。読む前に知っておきたい前提が2つあり、数値はすべてQwenの自己申告であること、比較相手がClaude Opus 4.6 Maxであることです。
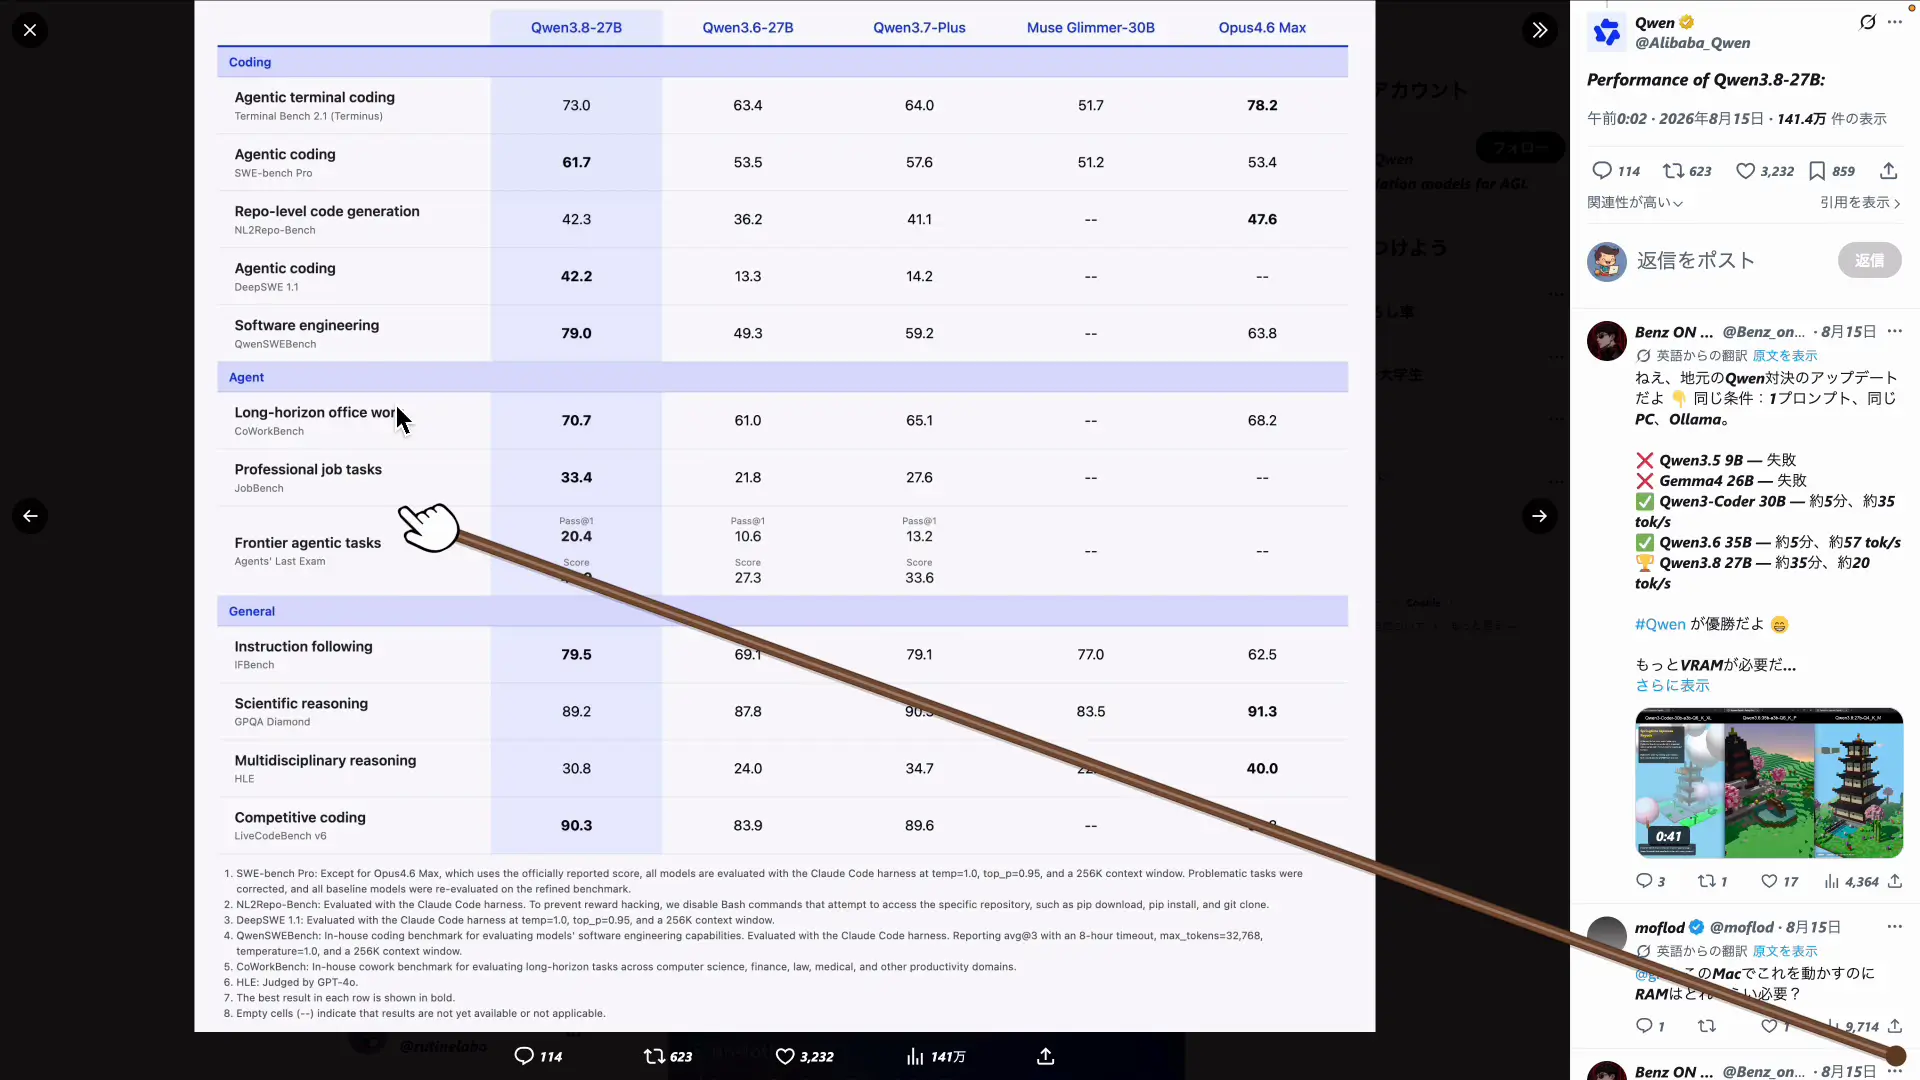
| ベンチマーク | Qwen3.8-27B | Opus 4.6 Max |
|---|---|---|
| SWE-bench Pro | 61.7 | 53.4 |
| LiveCodeBench v6 | 90.3 | 88.8 |
| OSWorld-Verified(PC操作) | 84.3 | 72.7 |
| MathVision(画像つき数学) | 94.6 | 65.5 |
| IFBench(指示追従) | 79.5 | 62.5 |
| Terminal Bench 2.1 | 73.0 | 78.2 |
| GPQA Diamond(難問) | 89.2 | 91.3 |
| HLE(難問) | 30.8 | 40.0 |
(2026年8月時点・Qwen公式モデルカードの発表値。太字が高いほう)
数値がそろう20項目ではQwenが16項目で上回り、とくに画像を伴う処理とPC操作系は全項目でQwenが上です。負けているのはターミナル操作と難問推論の4項目でした。ただし比較表のベンチにはQwenが自作したものが含まれ、そこが最も差の大きい項目になっています。数字は目安として見るのが安全です。
なお、API経由で試したい場合の料金も出しておきます。ローカルなら電気代だけですが、まず性能だけ確かめたいときはAPIのほうが手軽です。
| 提供形態 | 入力(100万トークン) | 出力(100万トークン) |
|---|---|---|
| OpenRouter(qwen3.8-27b) | $0.45 | $3.20 |
| ローカル実行 | 無料(電気代のみ) | |
(2026年8月時点・OpenRouterのAPIから取得した実測値。提供元によって入力$0.40〜$0.48、出力$3.00〜$3.40の幅があります)
ローカルで動かす本当の価値
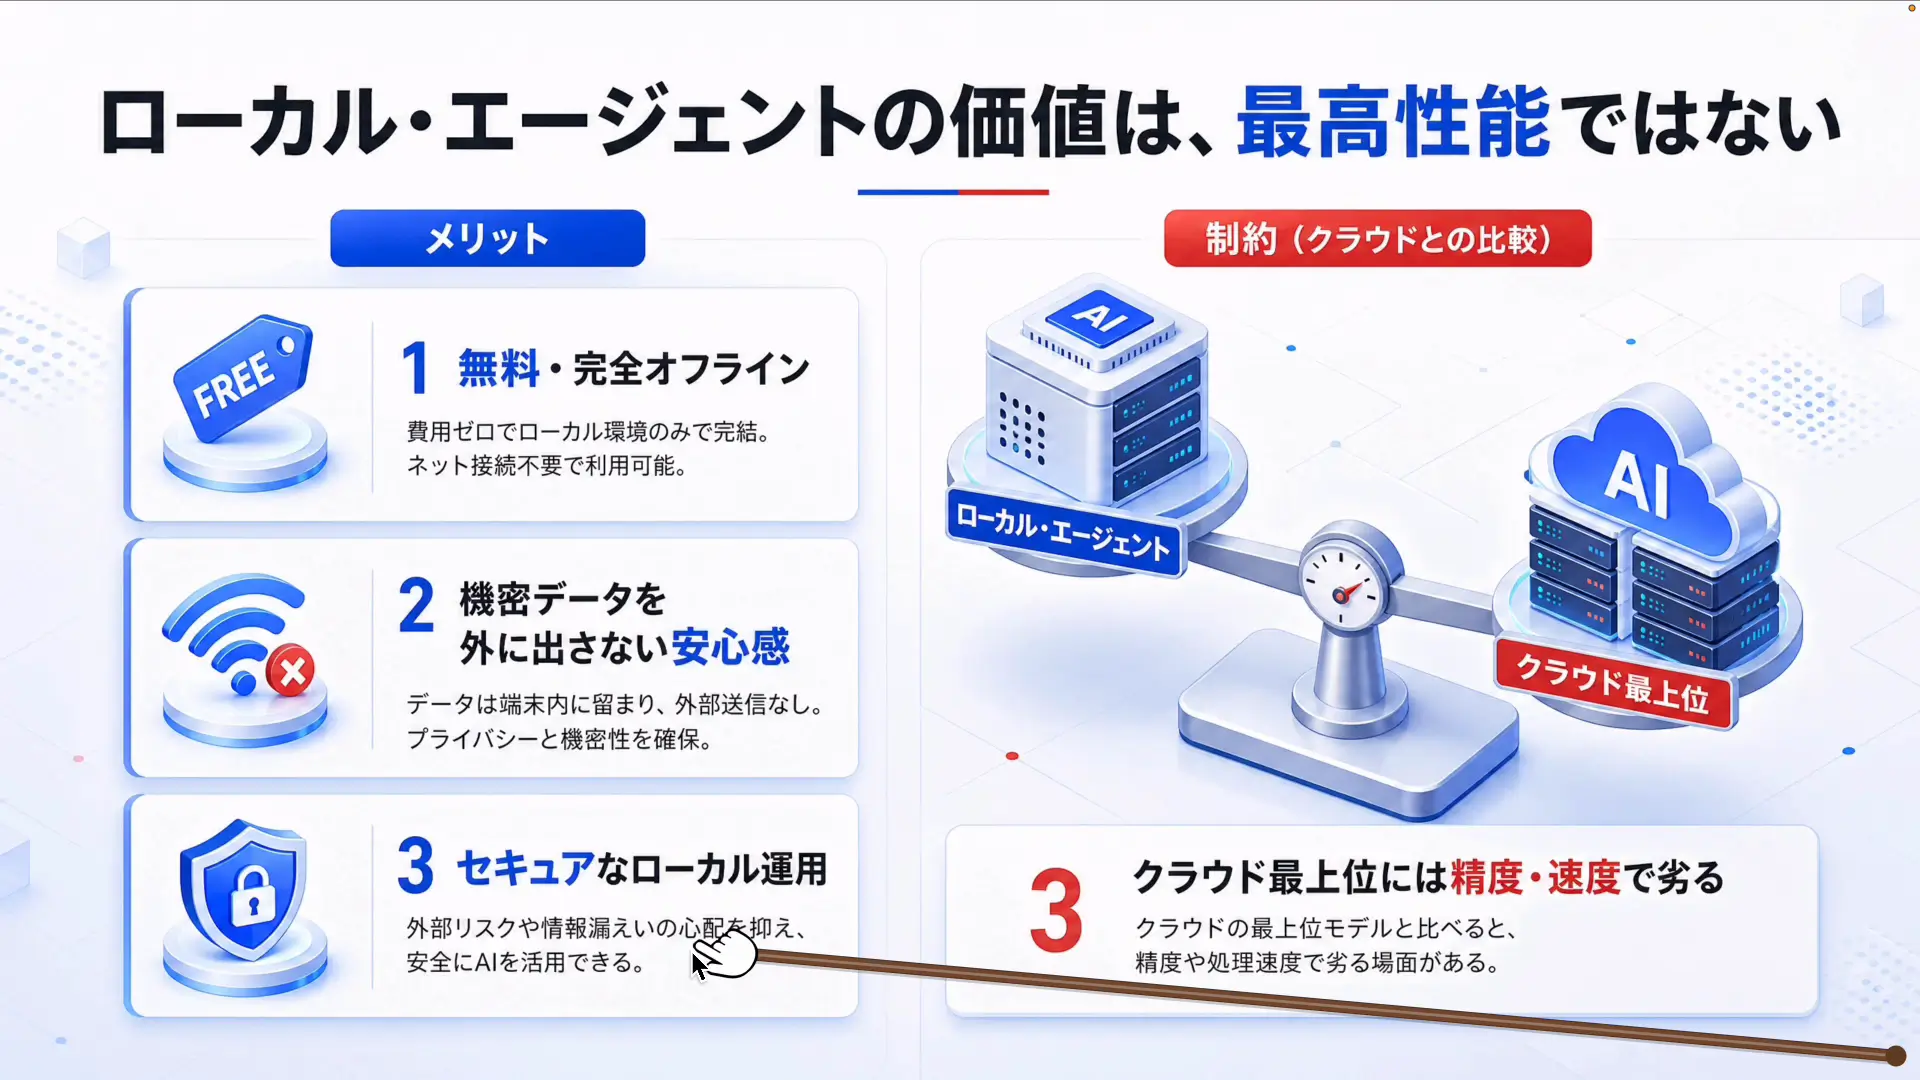
ここまで読んで「クラウドのほうが賢いなら、それでいいのでは」と思った方もいるはずです。それでもローカルを選ぶ理由は、賢さとは別のところにあります。
ひとつは情報の扱いです。社内の資料や顧客の情報など、外部のサービスに渡したくないデータをAIに読ませたいとき、ローカルなら通信そのものが発生しません。もうひとつはコストの天井で、APIは使うほど費用が積み上がりますが、ローカルは何回まわしても料金が変わりません。
- 外に出せないコードや資料を扱うとき
- 大量に回してAPI課金が重くなるとき
- ネットが使えない環境で作業するとき
- 壊してもいい前提で、何度も試したいとき
この先を考えると、メモリを多く積んだMac Studioのようなマシンにデータを貯めておいて、そこでローカルのモデルを動かすという形も現実的になってきました。組織としてAIをどう使うかという話に、選択肢がひとつ増えたことになります。
ちなみに、LM Studioはローカルサーバーを立てられるので、Claude Codeのようなターミナル型のツールから接続先をこちらに向けて使うこともできます。Qwen公式のCLIも用意されているので、興味のある方は試してみてください。
まとめ

- Qwen3.8の27Bと2.4Tは別物。個人で動かせるのは27Bのほうで、ライセンスもapache-2.0と扱いやすい
- Macは MLX、WindowsとLinuxは GGUF。数字が大きいほど高品質で重い、の2つだけ覚えれば選べる
- 16GB機は9Bを選ぶのが正解。27Bは32GBから、余裕があれば48GB以上で8bitを
- 3Dゲームのコードは一発で動く一方、細かい当たり判定などは崩れることがある
- 価値は賢さではなく、無料・オフライン・情報が外に出ないこと
去年までは、ローカルで動くAIといえば性能を諦めて使うものでした。それが今では、手元のMacで3Dゲームのコードが書けるところまで来ています。1年遅れではあっても、この性能が無料で使い放題になったのは大きな変化です。
ご自身のマシンのメモリを確認して、合う版から試してみてください。合わなければ消せばいいだけで、失うものは何もありません。
プロンプト配布中
LINE公式アカウントを友達追加していただければ、本記事やYouTubeで使用した使用したプロンプトを配布いたします。メンバーシップ登録で優先サポートも実施中です。

