この記事でわかること
- 文章を書かないAI「Jev AI」の正体
- 項目を増やしても遅くならない理由
- 登録停止中でもOpenRouterから試す方法
- 任せてよい仕事と任せてはいけない仕事
「僕が実際に30食ぶんのカロリー判定を4つのモデルに同時に投げたら、Jev AIだけ10秒で終わりました」
ほかのモデルが1食ずつ考えている間に、Jev AIはもう30食を数え終えていました。ただ、このモデルは文章を1行も書きません。返ってくるのは、はい/いいえや選択肢のどれを選ぶかといった判定と、その自信の度合いだけです。何が得意で、何を任せてはいけないのか。実際に使った結果と一緒にお伝えします。
こんにちは、ルーティンラボ(@rutinelabo)です。本記事では、TypeSafe AIが公開したJev AIについて、公式ドキュメントで確認できる事実と、僕がOpenRouter経由で実際に計測した実測値をまとめます。
プロンプト配布中
LINE公式アカウントを友達追加していただければ、本記事やYouTubeで使用した使用したプロンプトを配布いたします。メンバーシップ登録で優先サポートも実施中です。
結論|Jev AIは「文章を書かない判定専用のAI」だった
先に結論をお伝えします。Jev AIは、ChatGPTやClaudeの代わりになるモデルではありません。文章を作る代わりに、決まった形の答えと確率だけを返す、判定専用のモデルです。
イメージとしては「賢いswitch文」に近いです。プログラムの分岐のように、入力を見て「AならこっちBならあっち」と振り分けます。その振り分けを、ルールを全部書かなくても文脈から判断してくれるのがJev AIです。
メールの仕分け、コメントへの対応判断、コードのチェックなど、これまでわざわざLLMに文章を書かせていた仕事を、速く安く置き換える。ここがこのモデルの居場所です。
Jev AIとは|TypeSafe AIが出した「System One」モデル
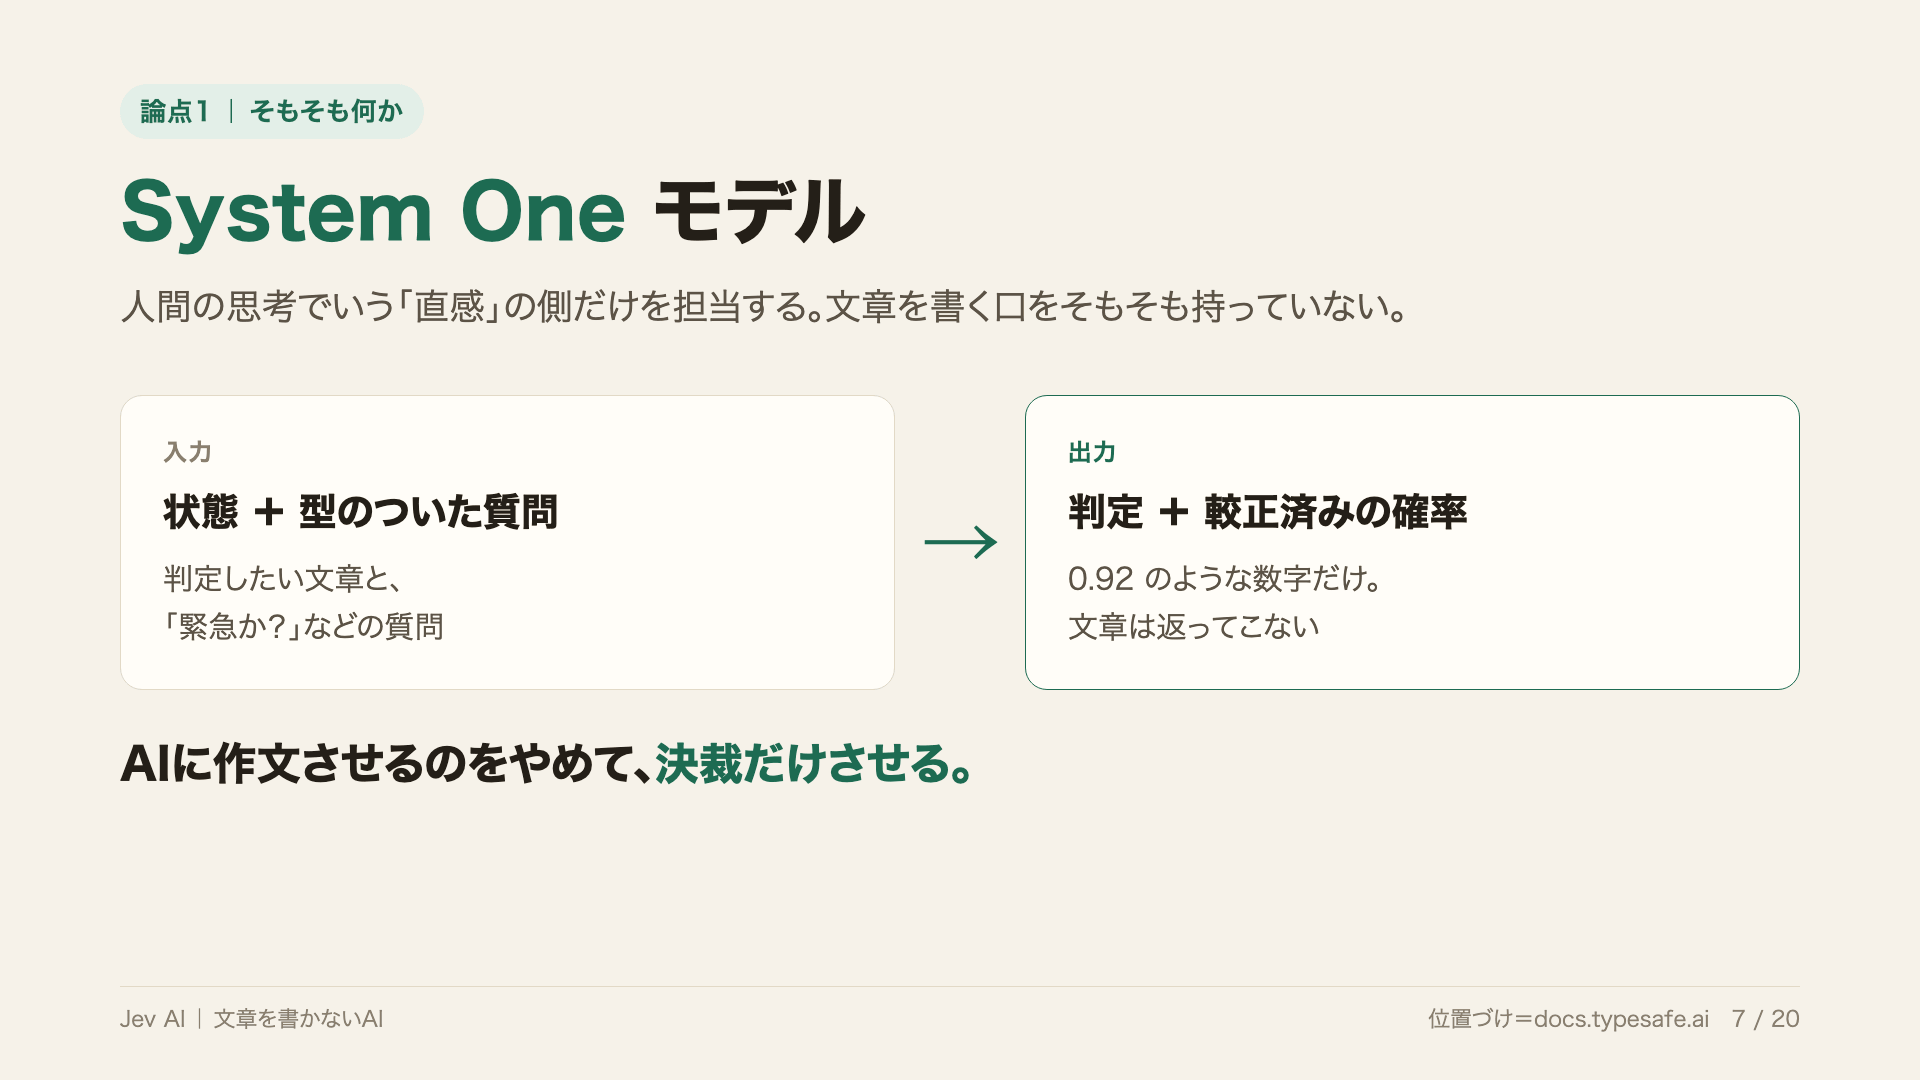
Jev AIは、TypeSafe AIが「System One」と呼ぶモデル群の1号機です。公式の説明では、System Oneは状態を評価して、型のついた答えと確率を返すモデルとされています。
| 項目 | 内容 |
|---|---|
| 開発元 | TypeSafe AI |
| モデルの種類 | System One(型のついた答え+確率を返す) |
| 公称レイテンシ | 70〜500ms |
| コンテキスト長 | 32,000トークン |
(2026年9月時点・公式参照)
普段使っている生成AI(LLM)は、いわば文章の計算機です。次に来る言葉を1つずつ予測して、文章を組み立てていきます。一方のJev AIは、言葉を並べる処理そのものをしません。数値や「はい/いいえ」のような、あらかじめ決まった形の判断だけを返します。
だからこそ速いわけです。何百文字もの文章を1文字ずつ組み立てる必要がなく、最初から答えの形が決まっているので、処理が一瞬で終わります。
質問の型は3つ|Noul・Choice・Score
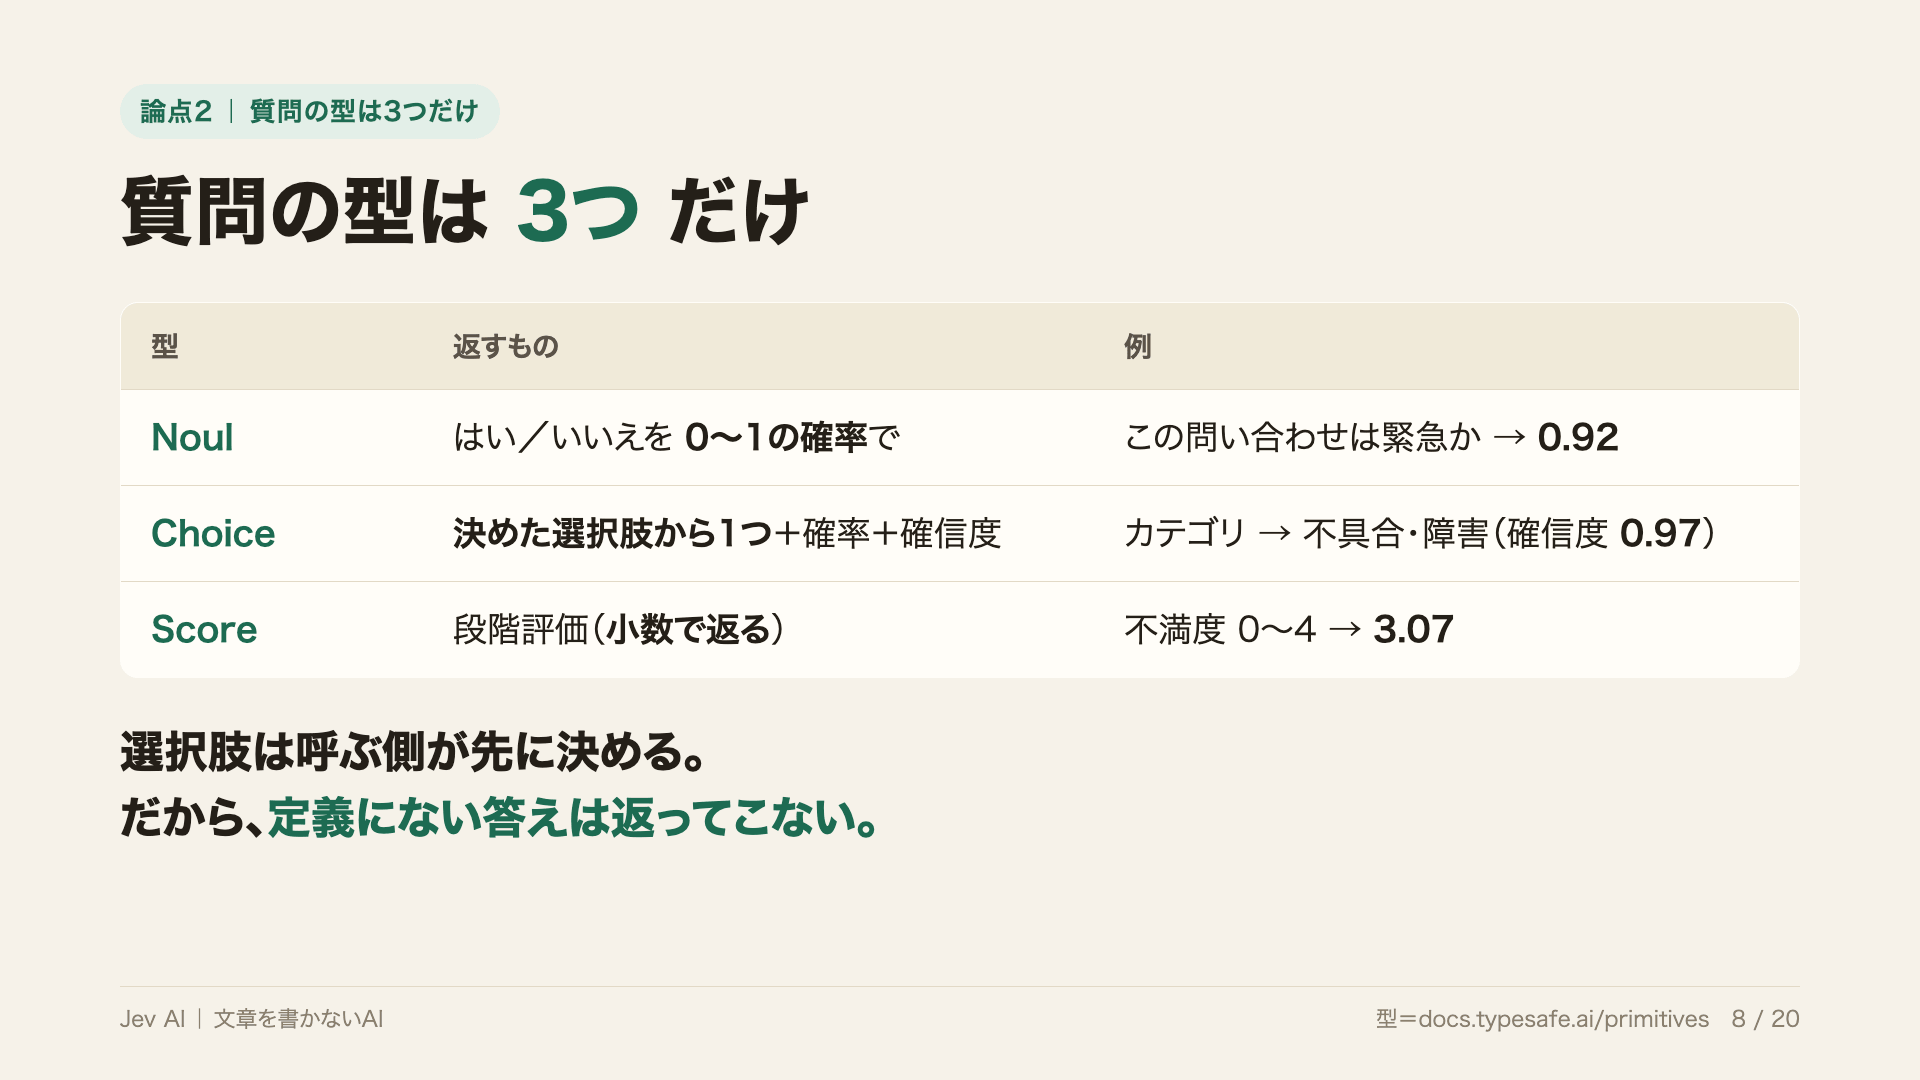
Jev AIに投げられる質問は、次の3つの型に限られます(公式ドキュメント・2026年9月時点・公式参照)。
| 型 | 返ってくるもの | 使い方の例 |
|---|---|---|
| Noul | はい/いいえの確率(0〜1) | このメールは返信が必要か |
| Choice | 選択肢ごとの確率+自信度(最大255択) | コメントに「返す/保留/無視」のどれで対応するか |
| Score | 2〜10段階の点数 | 問い合わせの不満度を段階で付ける |
どれも「答えの形が決まっている質問」です。二択ならNoul、選択肢から選ぶならChoice、点数を付けるならScoreと考えると分かりやすいです。
実際に触って1つ引っかかったのが、Scoreの戻り値です。段階の番号がそのまま返るのではなく、加重平均の小数で返ってきます。段階に戻したいときは、自分で丸める処理を入れておく必要があります。
なぜ速いのか|速いのではなく「増えない」
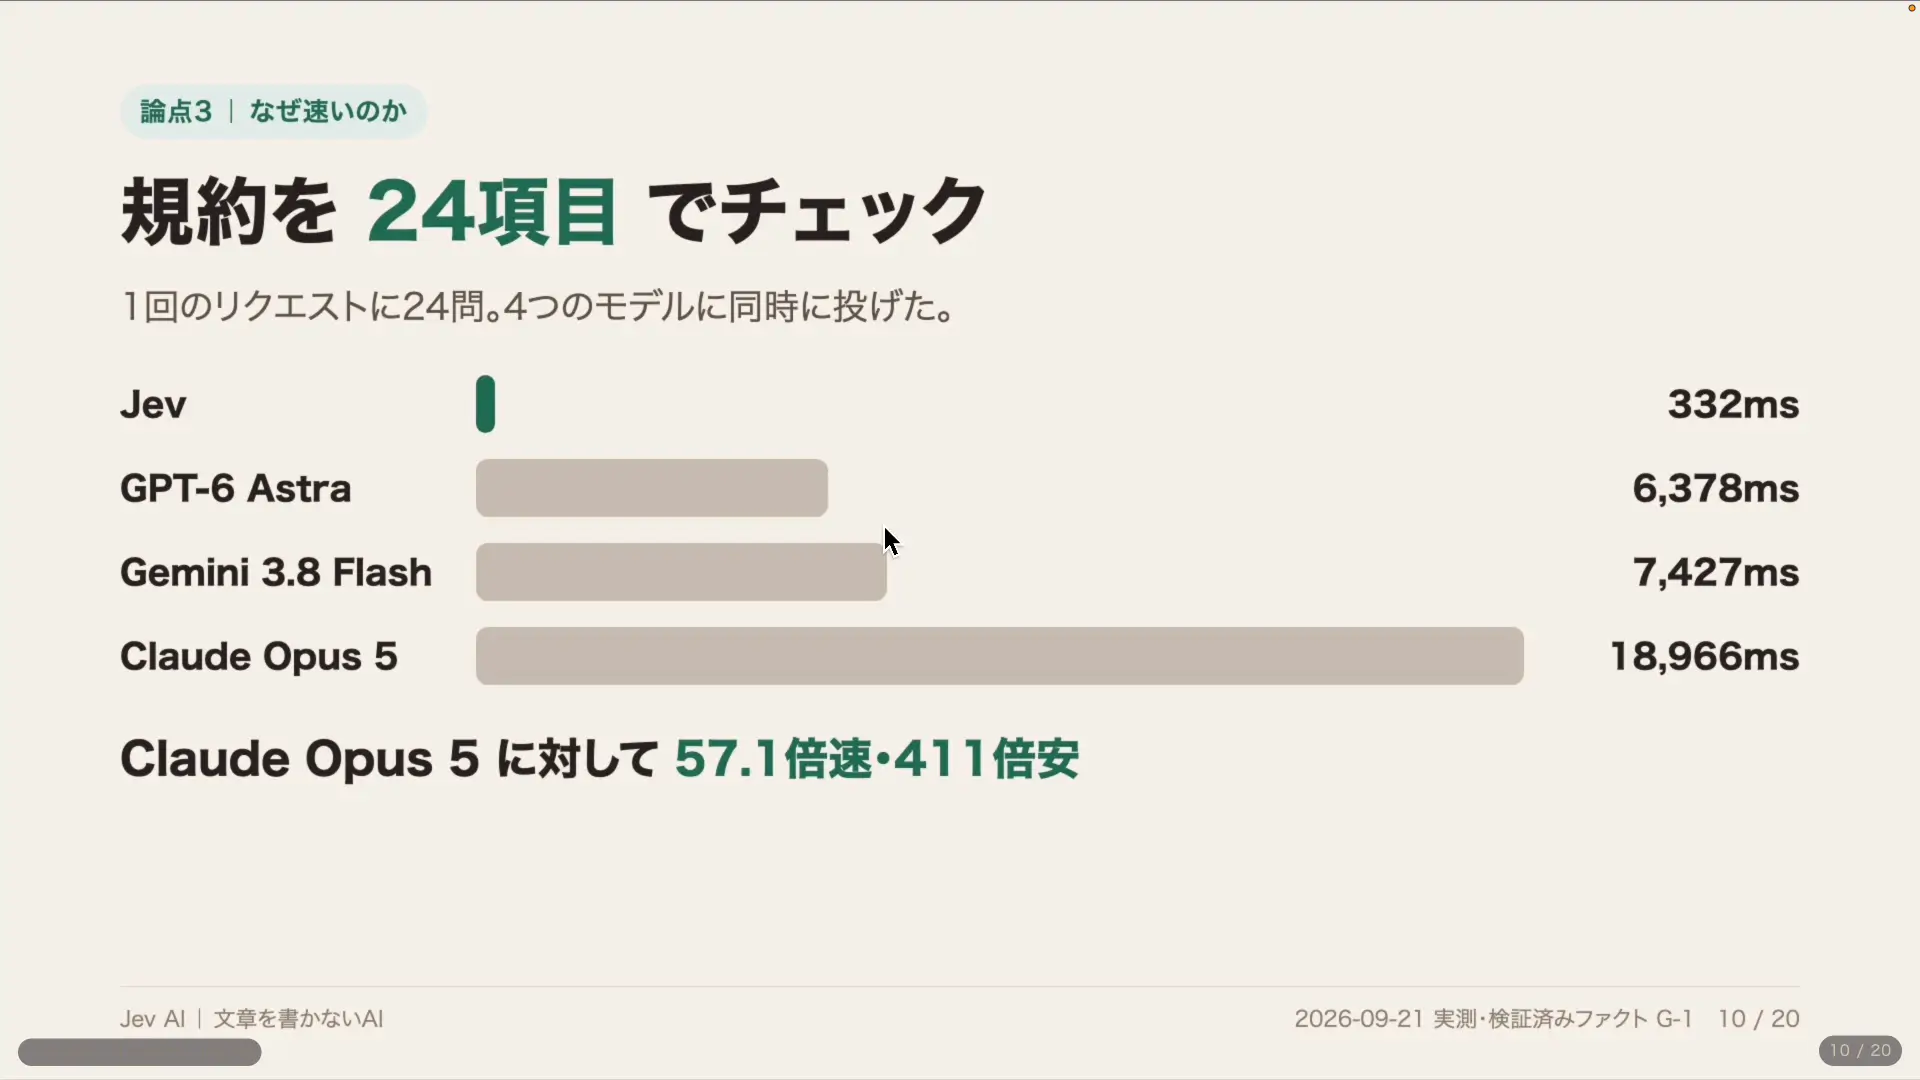
公式側の発表では、Jev AIはLLM比で193倍速く、445倍安いと主張されています(2026年9月時点・公式参照)。本当なのかを、自分の環境で測りました。
お題は「規約を24項目でチェックする」です。1回のリクエストに24問をまとめて投げ、4つのモデルを同時に走らせました。以下はルーティンラボの実測です(自宅回線・OpenRouter経由・同時発走・1回測定)。
| モデル | 24項目の所要時間 | 費用 |
|---|---|---|
| Jev AI | 332ms | $0.000070 |
| GPT-6 Astra | 6,378ms | — |
| Gemini 3.8 Flash | 7,427ms | — |
| Claude Opus 5 | 18,966ms | $0.028800 |
Claude Opus 5は、Jev AIに対して57.1倍遅く、411倍高いという結果でした。公称の193倍までは届きませんが、桁が違うことは確かです。
ただ、僕が一番驚いたのは速さそのものではありません。質問を1項目から24項目に増やしたとき、所要時間がどれだけ伸びたかです。
| モデル | 1項目→24項目の伸び率 |
|---|---|
| Jev AI | 1.18倍 |
| Gemini 3.8 Flash | 2.90倍 |
| GPT-6 Astra | 4.27倍 |
| Claude Opus 5 | 4.88倍 |
LLMは、確認する項目が増えるほど書く文章も増えるので、時間が3倍、4倍と膨らみます。Jev AIは24倍の質問を投げても1.18倍にしかなりませんでした。つまり速いというより、増えないのです。チェック項目が多い仕事ほど、差が開いていきます。
Jev AIの料金|入力は100万トークン0.042ドル、出力は0ドル
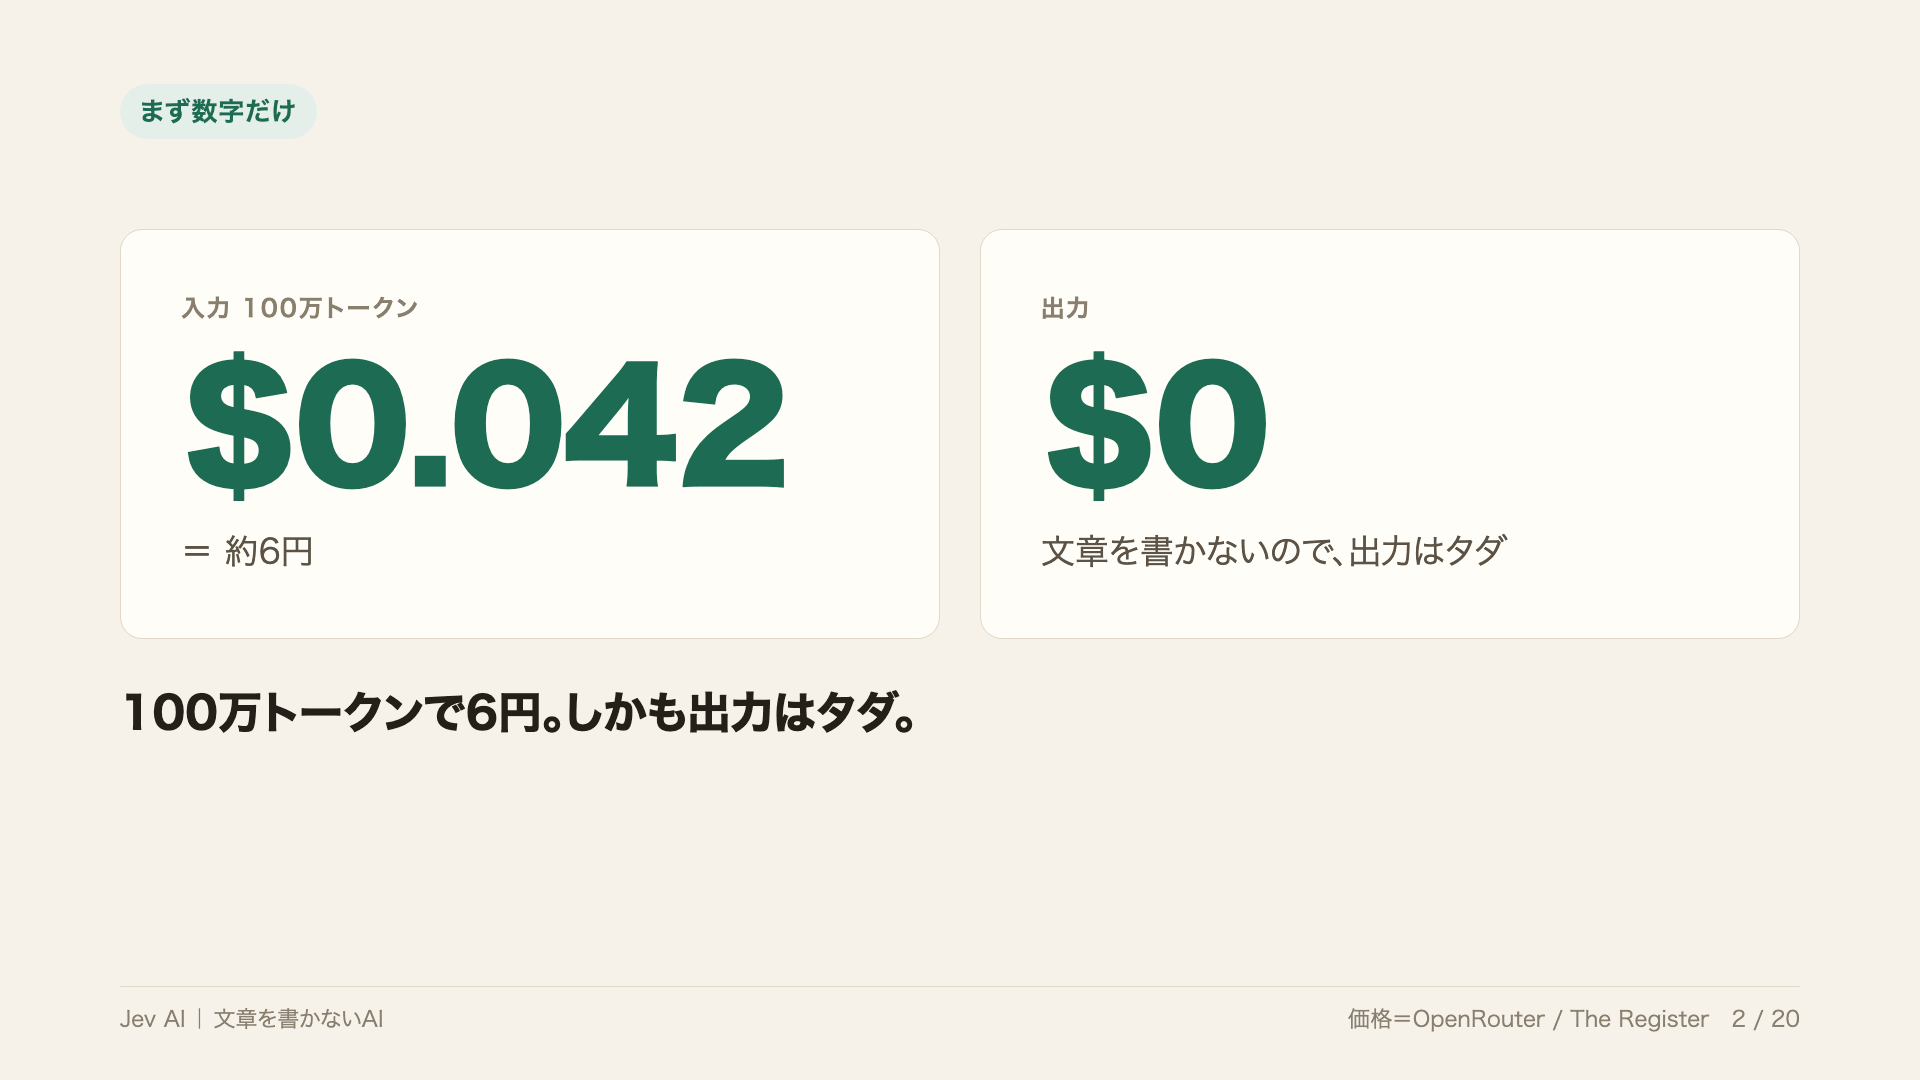
料金もかなり変わっています。OpenRouterの掲載価格は次のとおりです。
| 項目 | 料金 |
|---|---|
| 入力 | $0.042/100万トークン |
| 出力 | $0 |
(2026年9月時点・公式参照)
出力が無料なのは、文章を書かないモデルだからこそです。返すのは確率や選択肢だけなので、出力の量がほとんど発生しません。
実際にかかった費用で見ても、先ほどの24項目チェックはJev AIが$0.000070、Claude Opus 5が$0.028800でした。1回あたりでは小さな差に見えますが、毎日何千件も仕分ける仕組みに組み込むと、この差がそのまま月の請求に出てきます。
Jev AIの使い方|公式は登録停止中、OpenRouter経由で試す
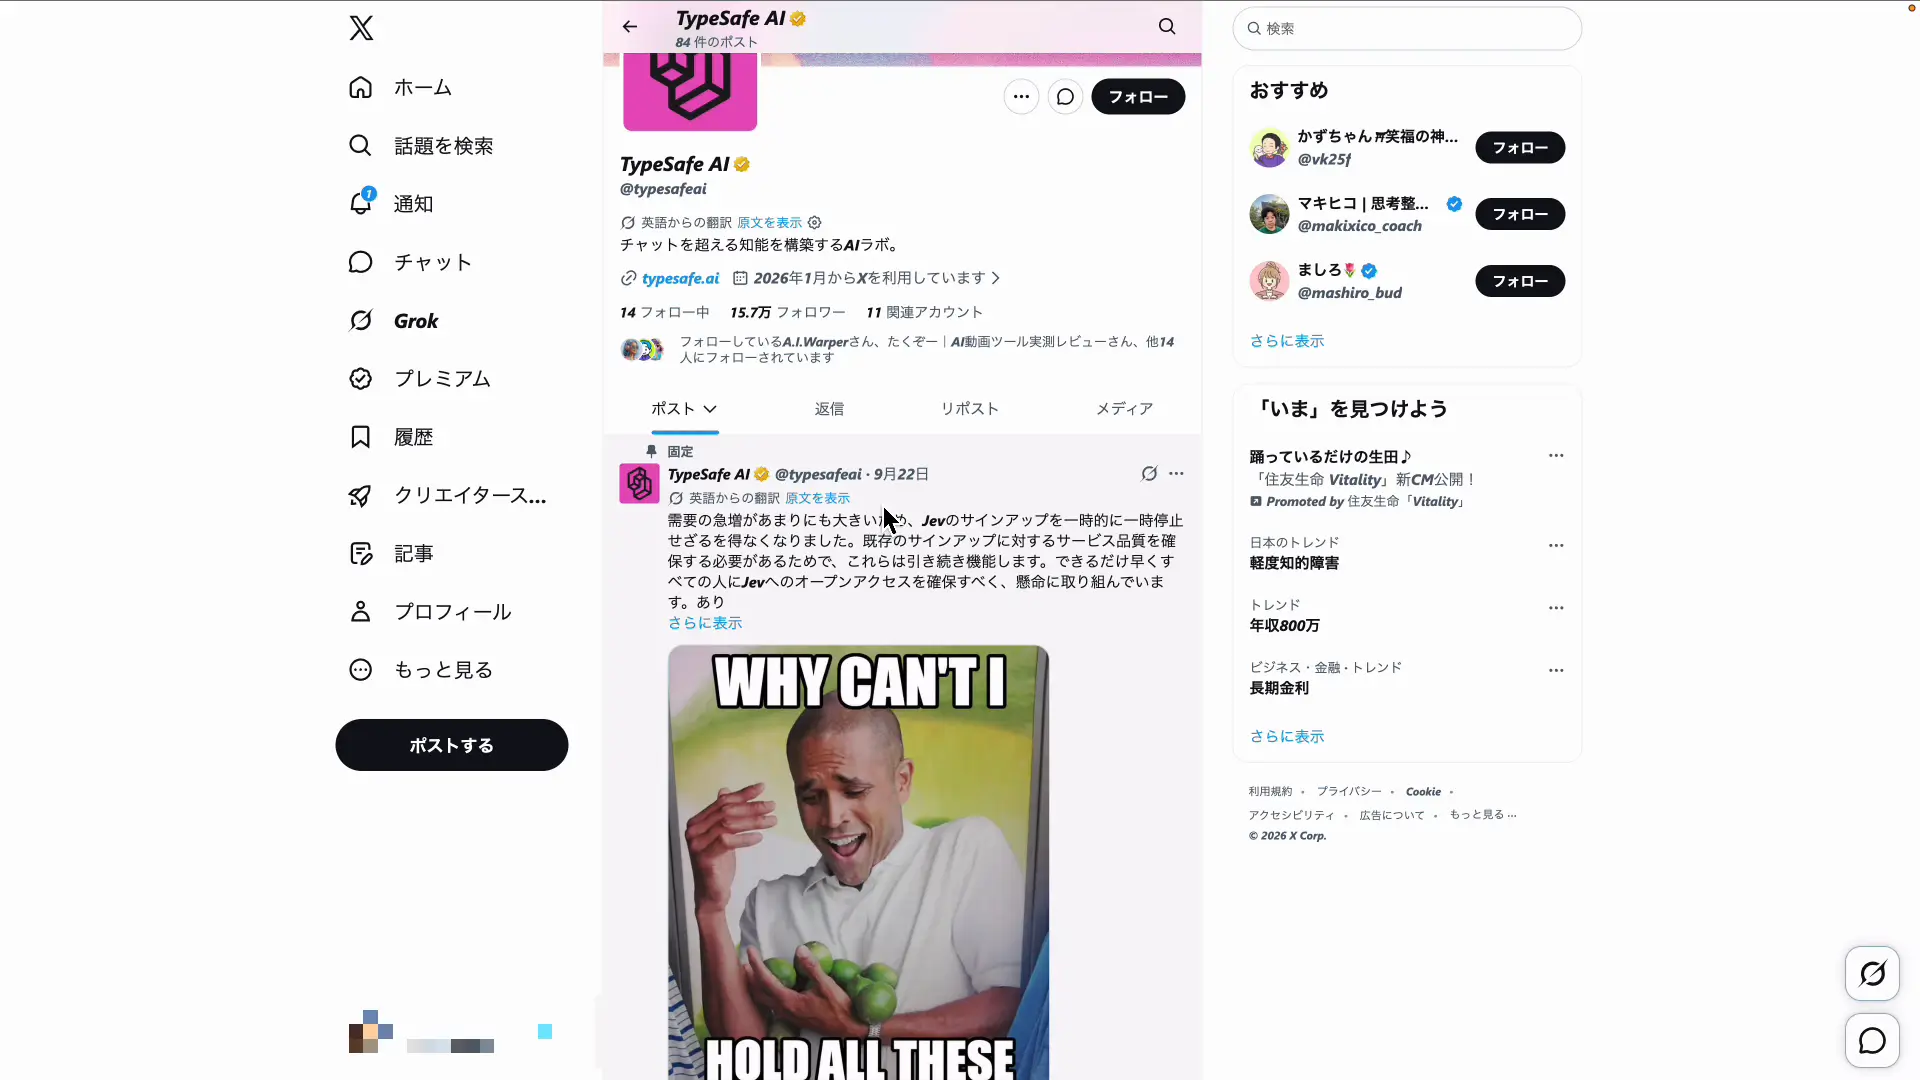
公式の窓口はconsole.typesafe.aiです。ただ、公開から数日で状況が大きく動きました。
| 日付 | 出来事 |
|---|---|
| 9月15日 | 早期アクセス(waitlist制)で公開 |
| 9月20日(米国時間) | waitlist撤廃・$5のクレジット付き |
| 9月22日 | 需要急増で新規登録を一時停止(停止前のアカウントは利用可) |
(2026年9月時点・公式参照)
僕も公式から使おうとしたところ、ちょうど新規登録が止まっていました。そこで使ったのがOpenRouterです。すでにOpenRouterのAPIキーを持っていれば、そのままJev AIを呼び出せます。
step
1OpenRouterでAPIキーを用意する
OpenRouterにログインし、APIキーを発行します。ほかのモデルで使っているキーがあれば、それをそのまま使えます。
step
2モデル名に typesafe/jev-1.13 を指定する
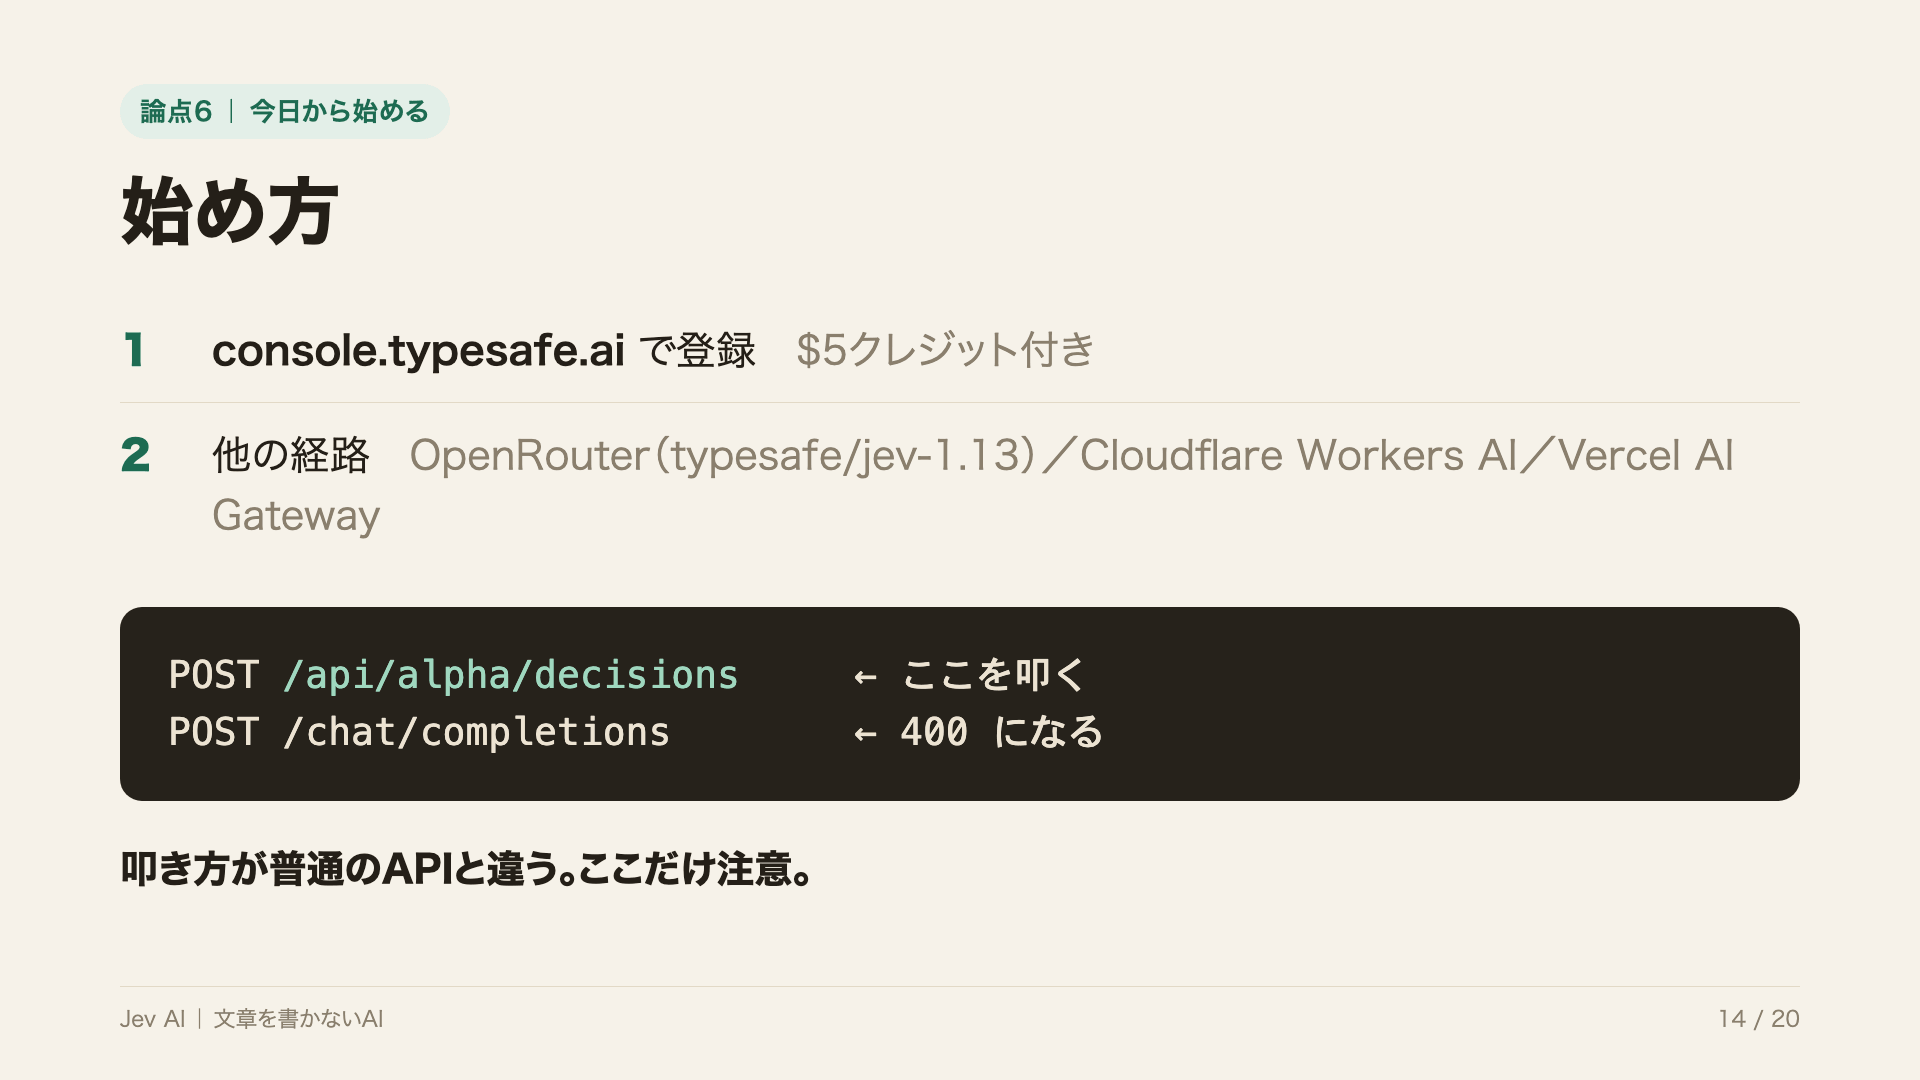
モデル名に typesafe/jev-1.13 を指定し、判定用のエンドポイントへ送ります。
POST https://openrouter.ai/api/alpha/decisions
model: typesafe/jev-1.13
ここで一番つまずきやすいのが送り先です。普段のLLMと同じ chat/completions に投げると、400エラーで弾かれます。Jev AIは文章を返すモデルではないので、判定(decisions)用の窓口を使う必要があります。
もう1つの落とし穴が条件の書き方です。Choiceの選択肢は辞書、Scoreの段階は低い順の配列で渡します。逆にするとやはり400エラーになるので、エラーが出たらまずここを確認してみてください。
OpenRouterの基本的な使い方は、DeepSeek V4.1 Flashを実機検証した記事でも紹介しています。
-
-
DeepSeek V4.1 Flashを実機検証|単価1/3でも請求が同じだった理由
続きを見る
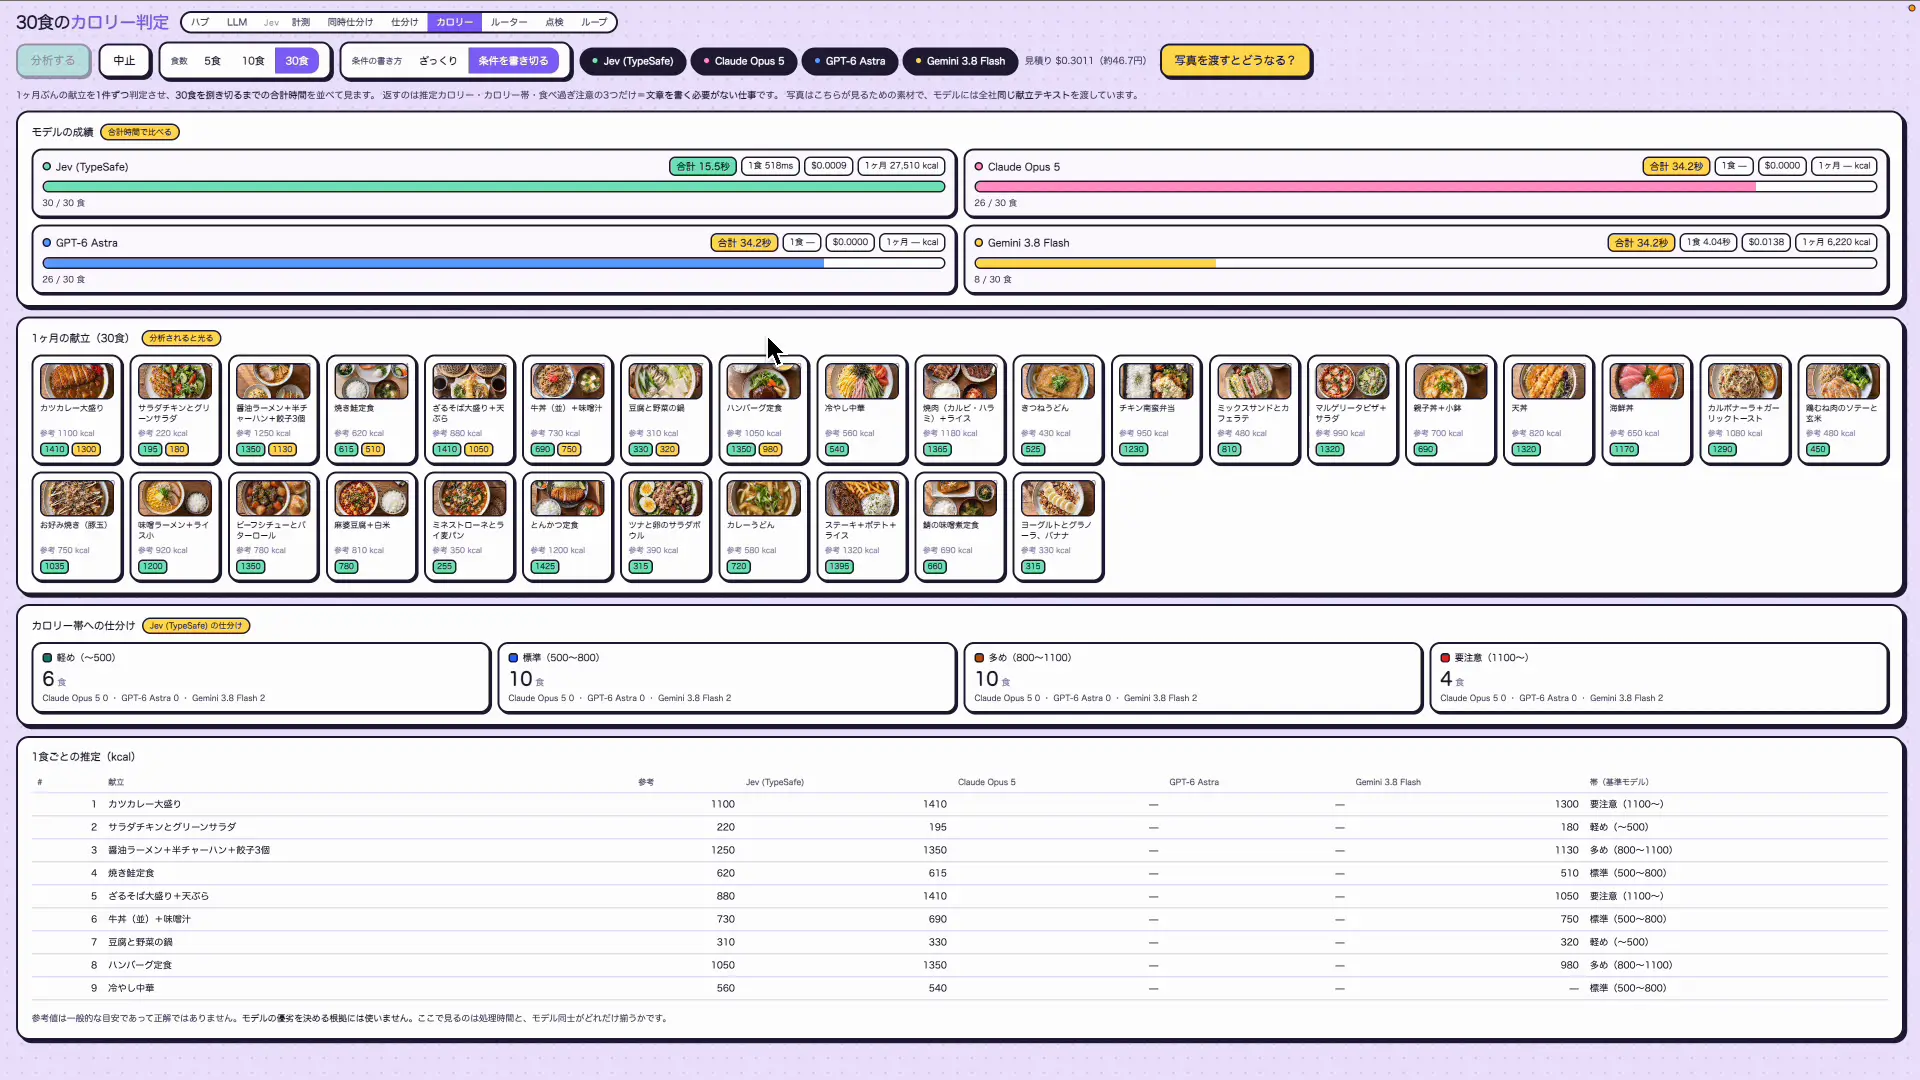
デモ①|30食のカロリー判定を4モデルで競走させた
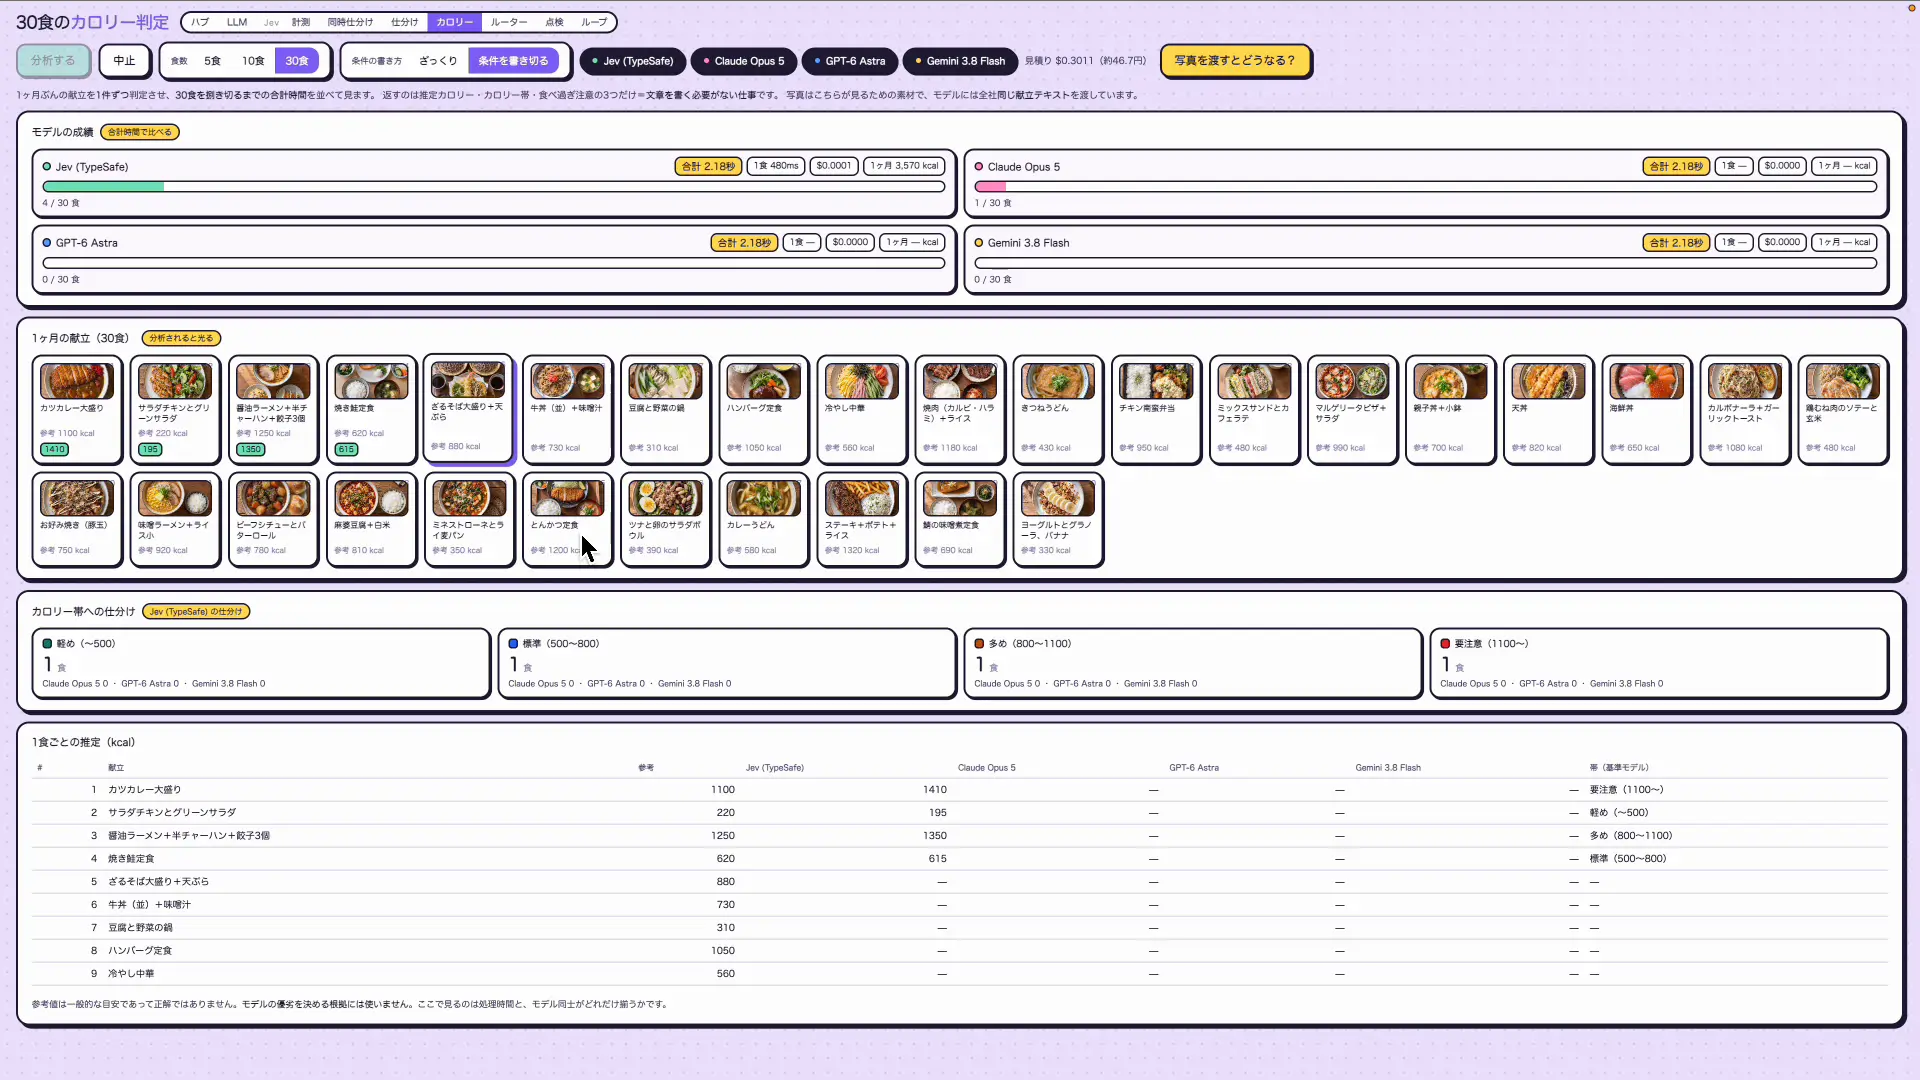
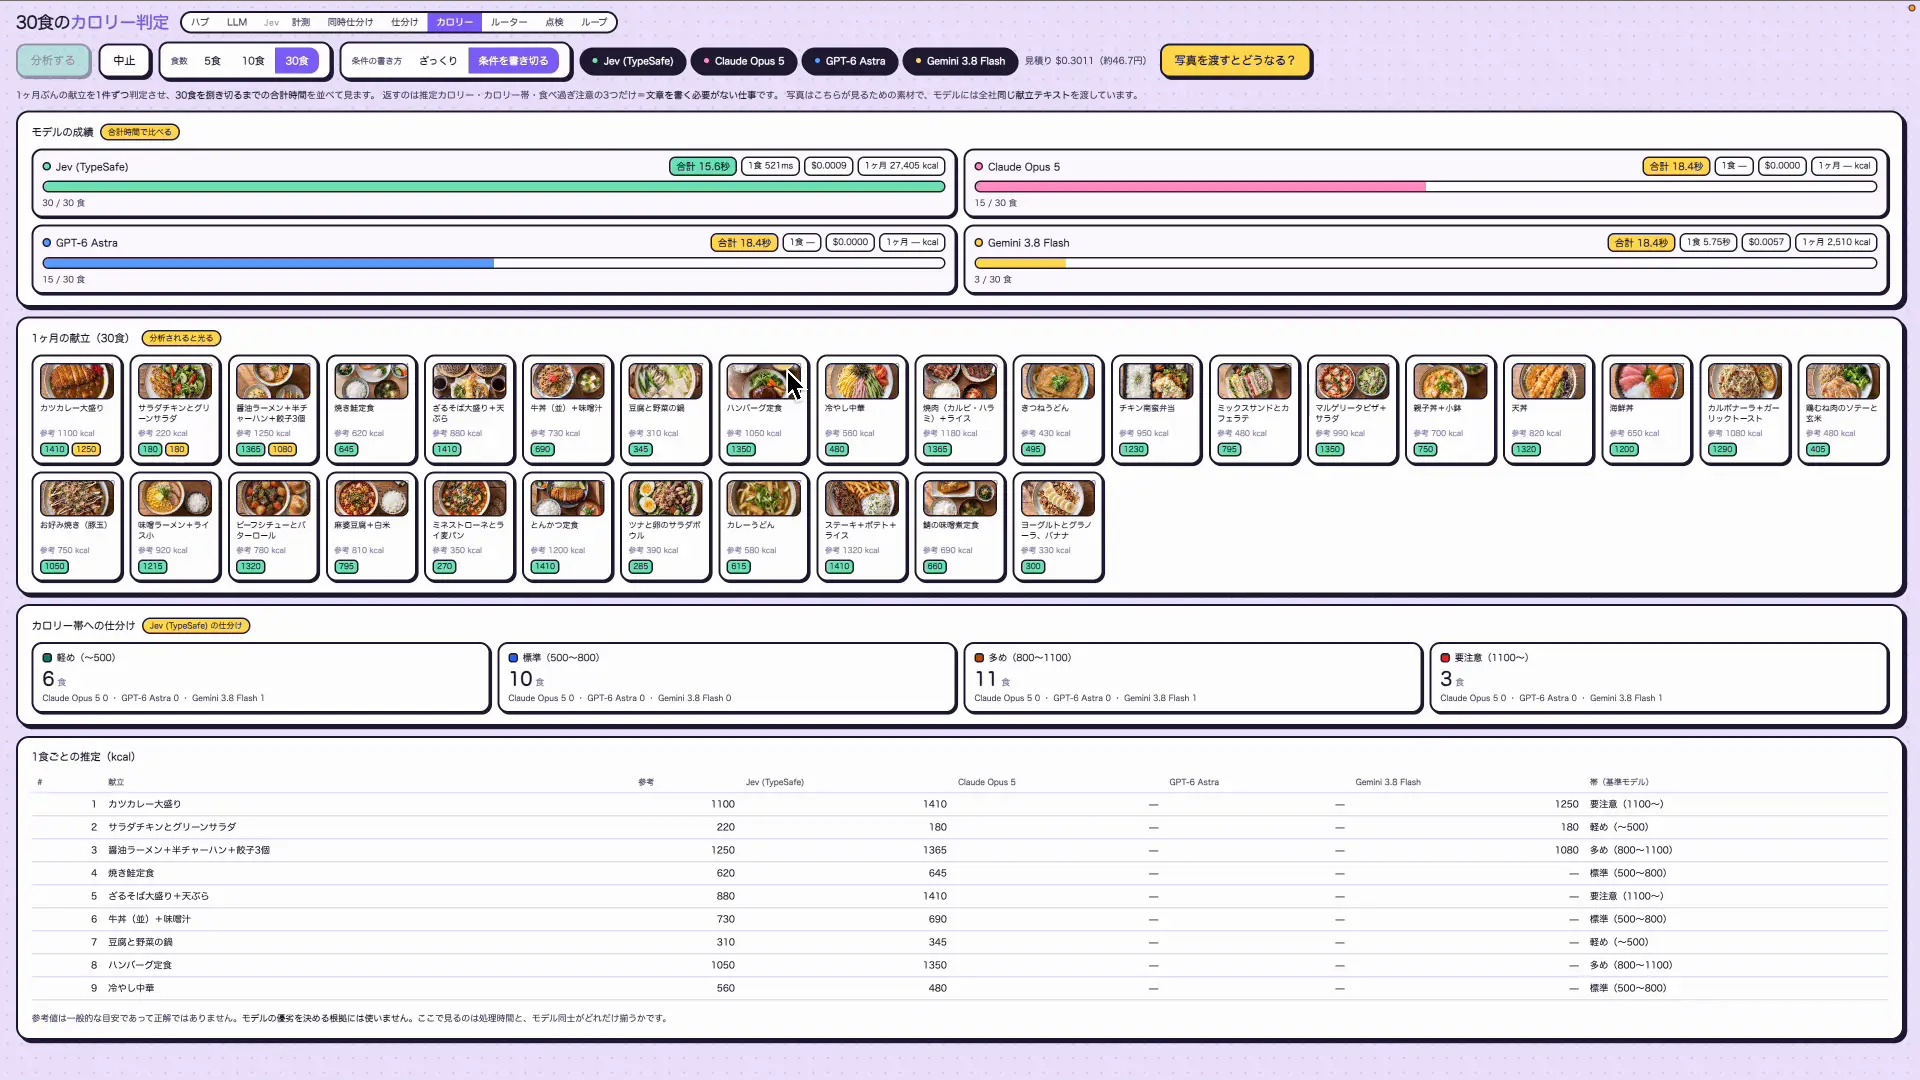
ここからは、Jev AIを組み込んだデモアプリで実際の速さを見ていきます。1つ目は、1ヶ月ぶん30食の献立からカロリーを判定させるお題です。僕の検証プラットフォームの見た目を作り直して、4つのモデルを同時に走らせるレース形式にしました。
1食ごとに推定カロリー・カロリー帯・食べ過ぎ注意かどうかの3つを判定させています。数値として記録できた3モデルの結果は次のとおりです(ルーティンラボの実測・自宅回線・OpenRouter経由・同時発走・1回測定)。
| モデル | 30食の合計時間 | 費用 | 推定した1ヶ月の合計 |
|---|---|---|---|
| Jev AI | 10.3秒 | $0.00094 | 27,495kcal |
| Gemini 3.8 Flash | 127.6秒 | $0.0497 | 22,440kcal |
| Claude Opus 5 | 199.8秒 | $0.161 | 21,860kcal |
(参考値は22,600kcal。一般的な目安であり、正解ではありません)
Jev AIは真っ先に終わりました。1食ずつなら差は体感しにくいのですが、30食を積み上げると合計時間の差がそのまま待ち時間になります。意外だったのはGemini 3.8 Flashで、軽量モデルなのにかなり時間がかかりました。
一方で、合計カロリーはJev AIだけ高めに出ています。LLMの2つが参考値に近いのに対して、Jev AIだけ2万7千kcal台まで上振れしました。速いけれど、数値の細かさはLLMに分がある。これが正直な感想です。アプリに組み込むなら「ざっくり仕分ける係」として使うのが合っています。
デモ②|メール仕分けはGPT-6 Astraより速く、迷わない
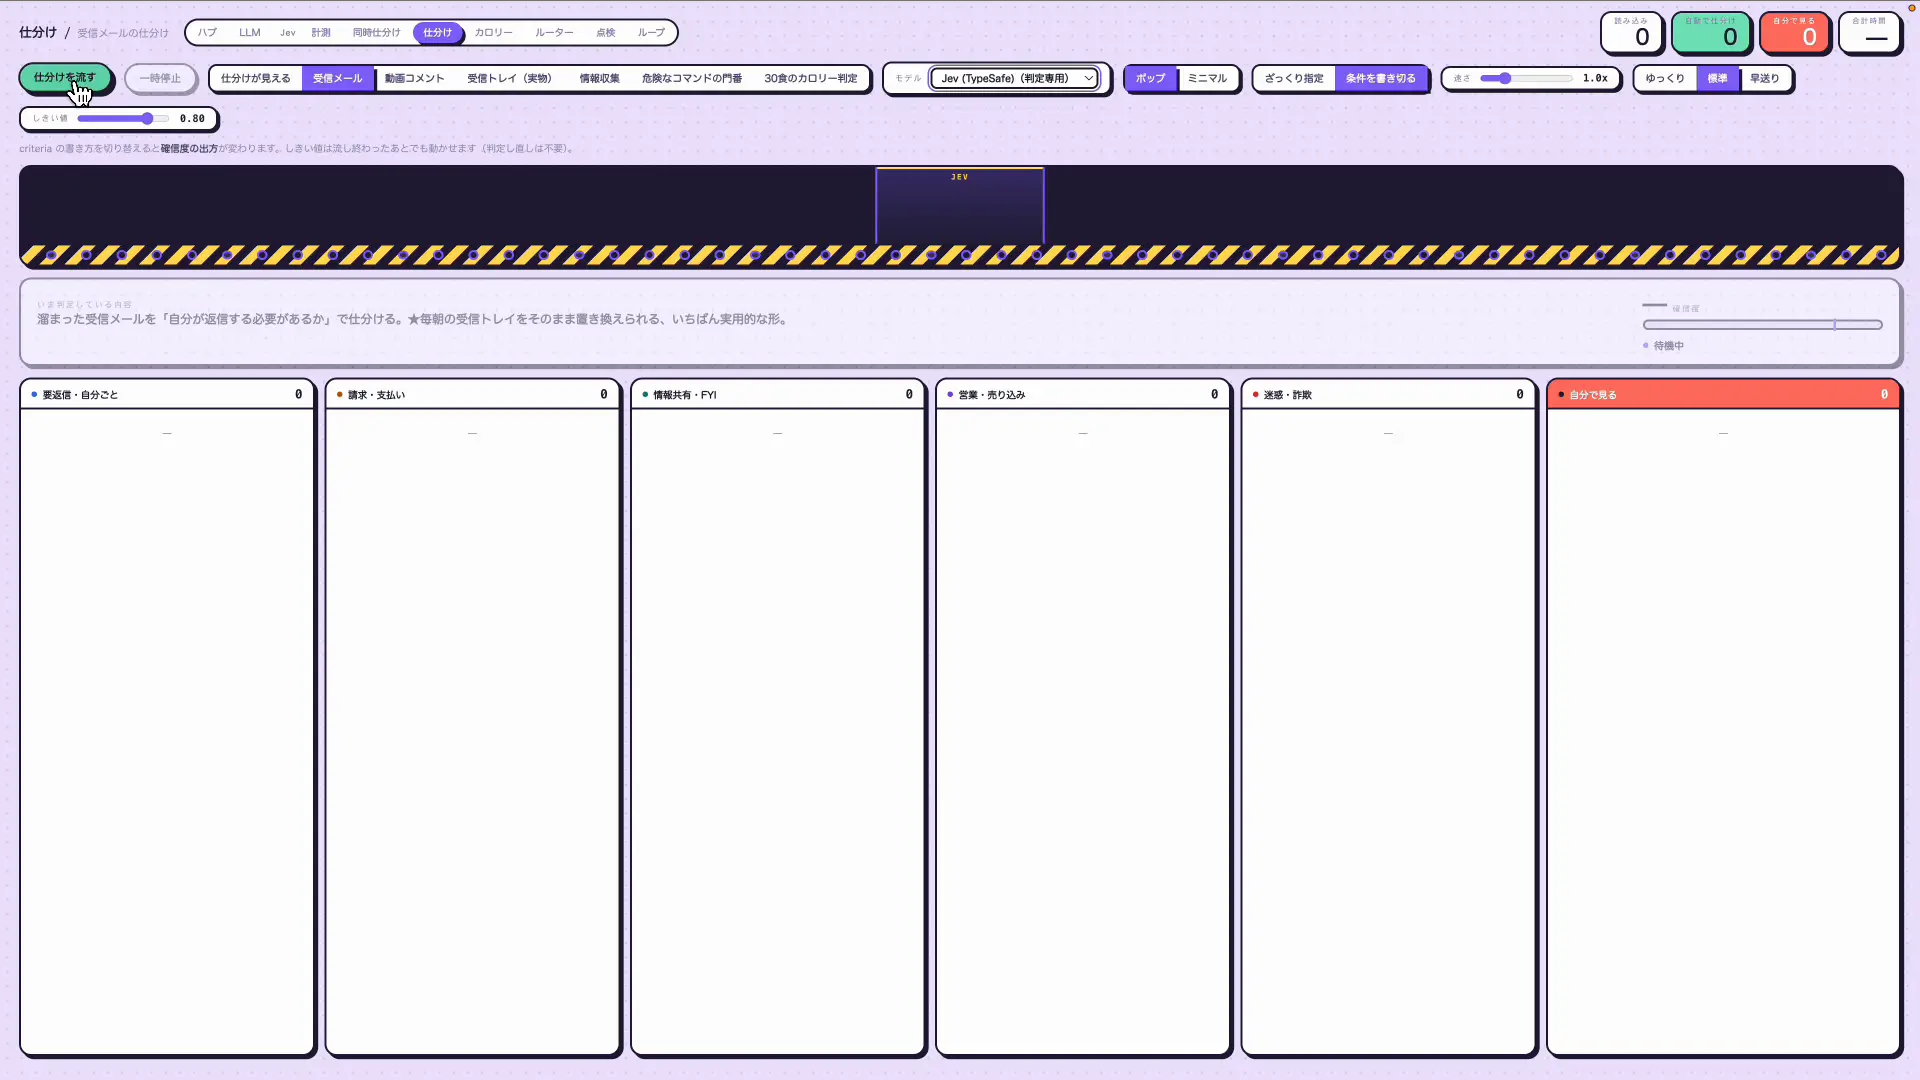
2つ目は受信メールの仕分けです。届いたメールを、返事が必要・請求書の支払い・自分で見る、といった箱に一括で振り分けさせました。Jev AIで回すと、画面上のメールが次々と箱に吸い込まれていきます。
同じお題をGPT-6 Astraでも試しました。結果は、まず明らかに遅い。そして気になったのが、「自分で見る」に落ちるメールがかなり多かったことです。判断基準が少しブレていて、迷ったものを人間に戻している印象でした。
仕分けの仕事で困るのは、AIが迷って結局自分で全部見直すことです。Jev AIは確率で答えを返すので、「0.8以上なら自動で振り分け、それ未満だけ人が見る」のように、しきい値で線を引けます。この迷い方を数字で管理できる点が、仕分け用途では大きな強みになります。
GPT-6 Astra自体の実力は、11課題で検証した記事で詳しくまとめています。文章やコードを書かせる仕事では、もちろんAstraが上です。
デモ③|コマンド仕分けを4モデル同時に比べた
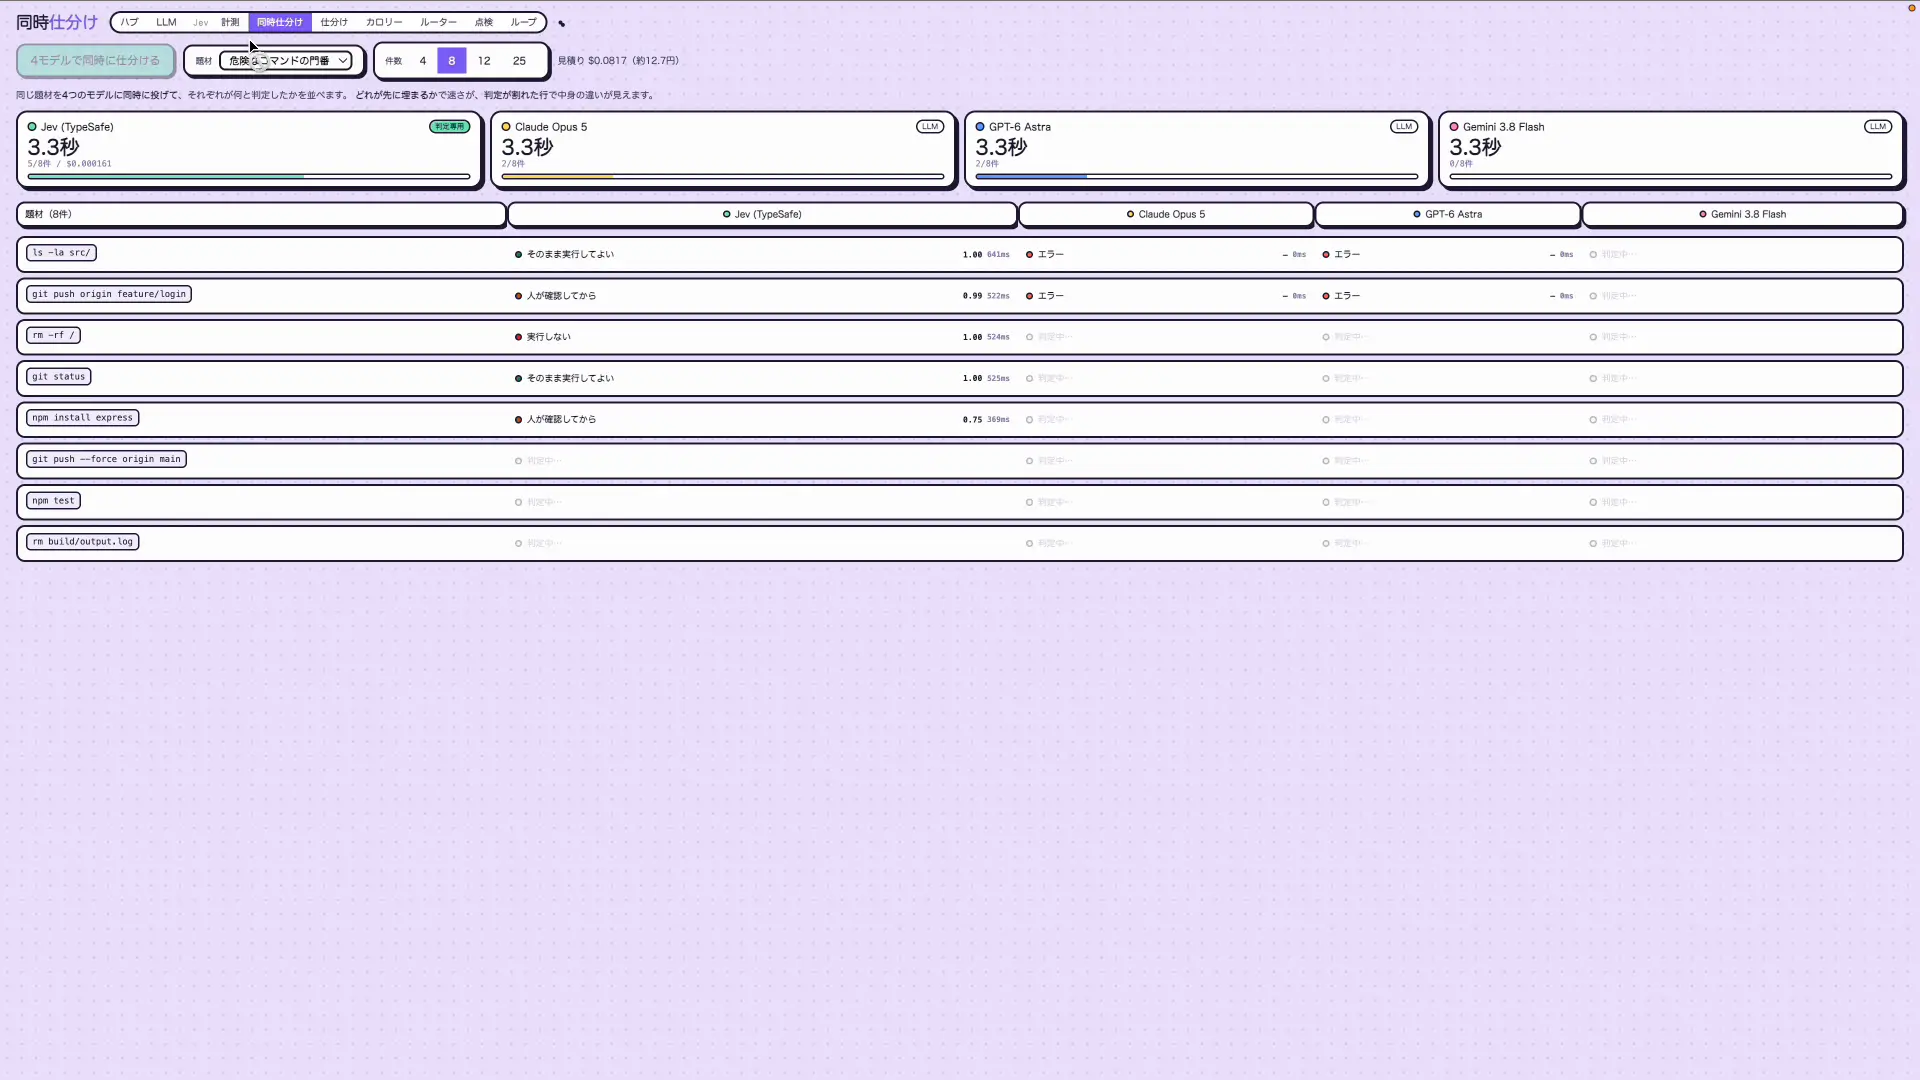
3つ目は、ターミナルのコマンドや経費の項目を仕分けるお題です。Jev AI・Claude Opus 5・GPT-6 Astra・Gemini 3.8 Flashの4モデルを同時に走らせました。
画面で見ても、Jev AIが終わった時点でほかのモデルはまだ半分も進んでいません。ここでもGemini 3.8 Flashは意外と遅く、最後まで時間がかかっていました。
別途、危険なコマンド25本を「実行してよいか」判定させる門番のテストも計測しました(ルーティンラボの実測・自宅回線・OpenRouter経由・同時発走・1回測定)。
| モデル | 25本の所要時間 | 費用 |
|---|---|---|
| Jev AI | 9.1秒 | $0.000808 |
| Gemini 3.8 Flash | 197.8秒 | $0.032480 |
AIエージェントにコマンドを実行させる前に、Jev AIを門番として挟む。こうした「本番の処理の手前で振り分ける」使い方が、Jev AIの一番おいしい使い道だと感じました。なお、Gemini 3.8 Flashの実力そのものはこちらの記事で検証しています。
-
-
Gemini 3.8 Flashを実機検証|動画理解はClaude超え、大規模開発は厳しい理由
続きを見る
Jev AIを使うべき場面、使うべきでない場面
ここまでの結果を、向いている仕事と向いていない仕事に分けて整理します。
| 向いている | 向いていない |
|---|---|
| 大量のメール・コメントの仕分け | 文章を書く(そもそも書けない) |
| 規約やコードのチェック項目の判定 | 画像を読む判定 |
| AIエージェントの手前の門番 | 細かい数値を正確に出す計算 |
| アプリに組み込む即時の判断 | 単純な分類でLLMより高い精度を求める |
注意したいのは、速くて安いことと、正確なことは別だという点です。単純な分類でJev AIの精度がLLMより高くなるわけではありません。LLMを丸ごと置き換えるのではなく、LLMの手前で大量の判断をさばき、難しいものだけLLMに回す組み合わせが現実的です。
Jev AIは画像を読めない
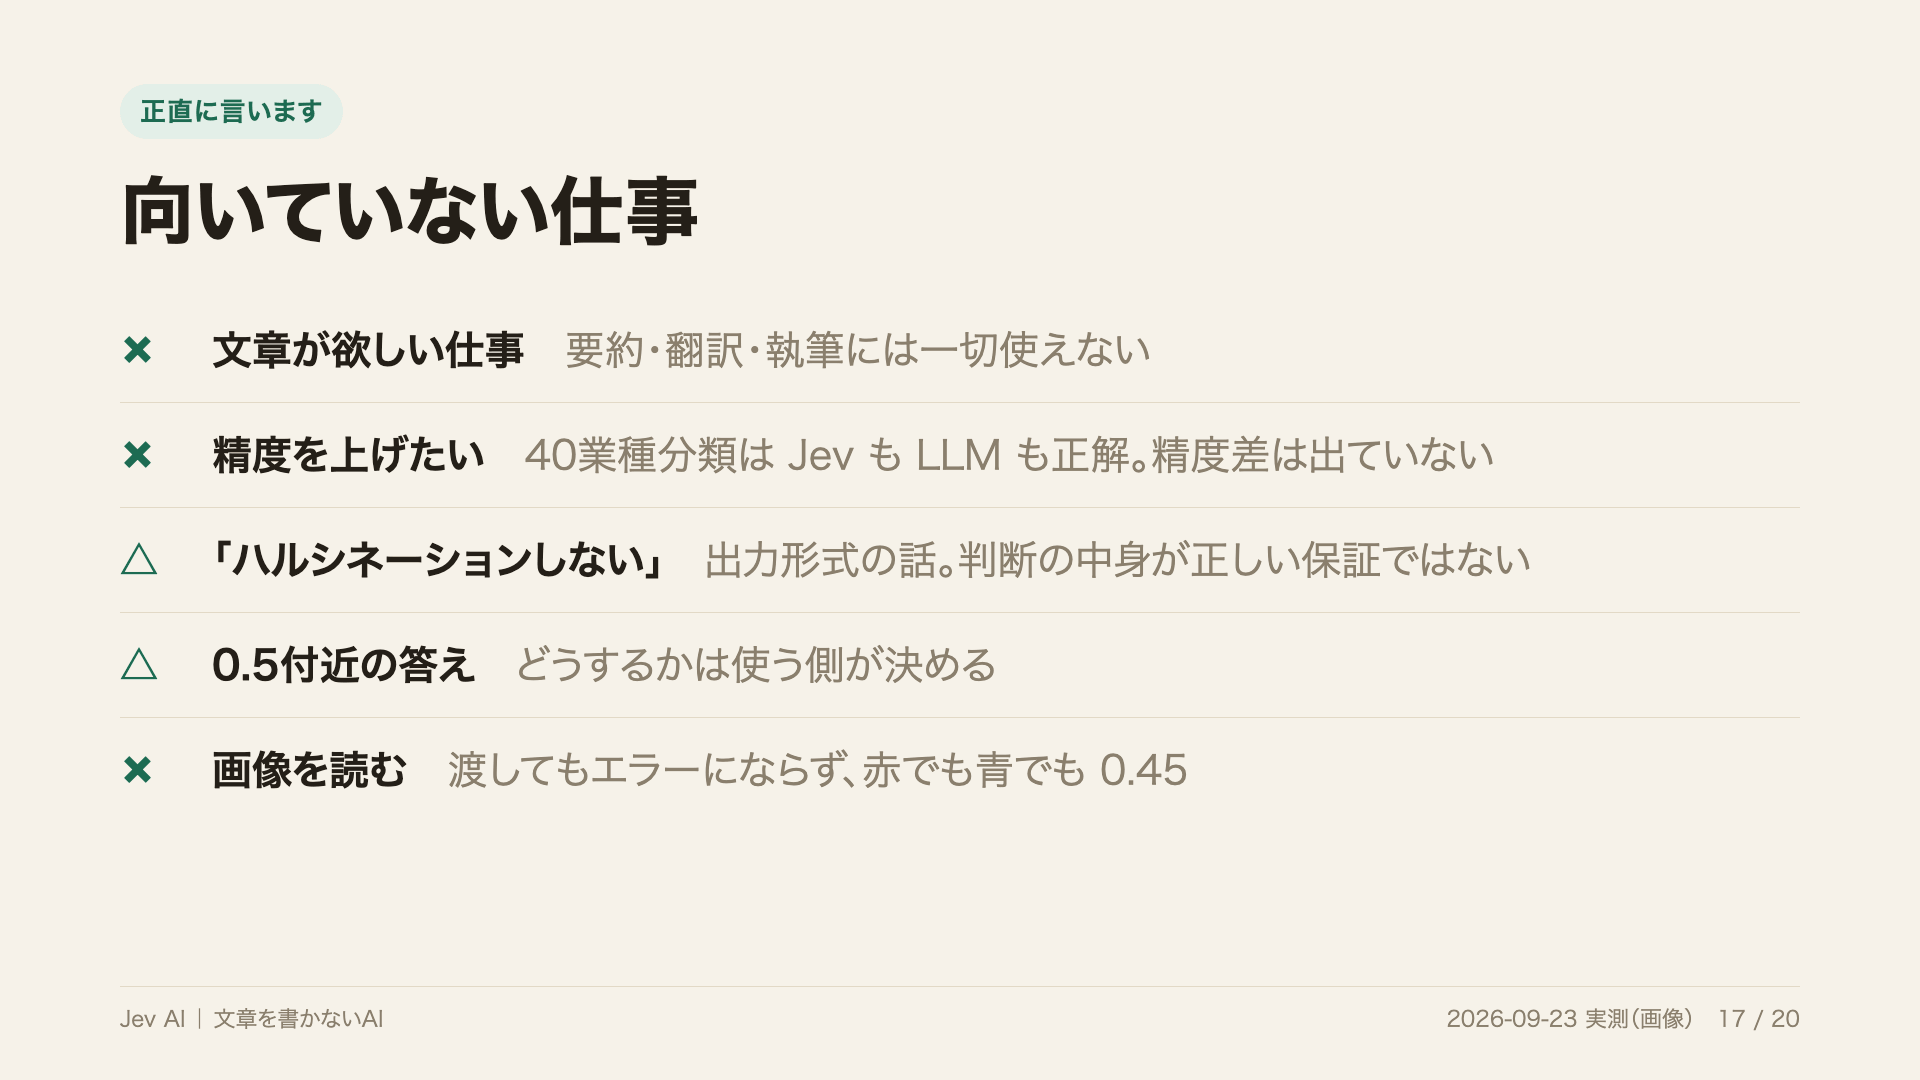
もう1つ、実際に試して分かった大事な注意点があります。Jev AIに赤い画像と青い画像を渡して「赤色ですか?」と聞いたところ、どちらも同じ0.45が返ってきました(ルーティンラボの実測)。
同じ質問を文章で渡すと(真っ赤な画像です/真っ青な画像です)、0.96と0.01にきれいに分かれます。つまりモデルが判断できないのではなく、画像そのものを読めていないのです。しかもエラーにならずに普通に答えが返ってくるので、気づかないまま使ってしまう危険があります。
- 写真から情報を読み取るのは、画像を扱えるLLMの仕事
- 読み取ったテキストを大量に仕分けるのが、Jev AIの仕事
カロリー判定のデモも、写真ではなく献立のテキストを渡しています。役割を分けて組み合わせれば、写真から始まるアプリにもJev AIを組み込めます。
まとめ
最後に、Jev AIについて本記事の内容をまとめます。
- Jev AIは文章を書かず、判定と確率だけを返すSystem Oneモデル
- 質問の型はNoul・Choice・Scoreの3つ
- 24項目チェックでOpus 5より57.1倍速く、項目を増やしても1.18倍しか伸びない
- 料金は入力が100万トークン0.042ドル、出力は0ドル
- 公式は新規登録停止中。OpenRouterの typesafe/jev-1.13 から試せる
- 画像は読めず、細かい数値の正確さはLLMに分がある
Jev AIは、単体で何かを作ってくれるAIではありません。ただ、アプリやエージェントの中に「判断する部品」として組み込むと、速さと安さが一気に効いてきます。メールやコメントの仕分け、コードレビューの一次チェックなど、今LLMに文章を書かせている判断をひとつ置き換えてみると、違いを体感できるはずです。
みなさんなら、Jev AIをどんな仕分けに使ってみたいですか。「この判断を任せたい」というアイデアがあれば、ぜひコメント欄で教えてください。

