この記事でわかること
- Gemini 3.8 Flash TTSの特徴と料金
- Google AI Studioでの使い方と声の作り方
- ほかのAI音声と聞き比べた結果
- Gemini 3.8 Liveとの違いと使い分け
「僕が実際にGemini 3.8 Flash TTSで動画のオープニング3本と8モデルの聞き比べまで作ってみたら、ここまでの利用額は約785円でした」
Googleから、新しい音声モデル「Gemini 3.8 Flash TTS」が正式版として公開されました。台本を読み上げる専用のモデルで、1つのモデルで6人のキャラクターの声を演じ分けられるほど表現の幅が広く、日本語の聞き比べランキングでも1位に入っています。
こんにちは、ルーティンラボ(@rutinelabo)です。本記事では、Gemini 3.8 Flash TTSの料金とGoogle AI Studioでの使い方・声の作り方をまとめ、自作の検証ダッシュボードでほかのAI音声と聞き比べた結果と、会話用のGemini 3.8 Liveを試した感想まで紹介します。
プロンプト配布中
LINE公式アカウントを友達追加していただければ、本記事やYouTubeで使用した使用したプロンプトを配布いたします。メンバーシップ登録で優先サポートも実施中です。
Gemini 3.8 Flash TTSとは|1つのモデルで6人の声を演じ分けた掛け合い
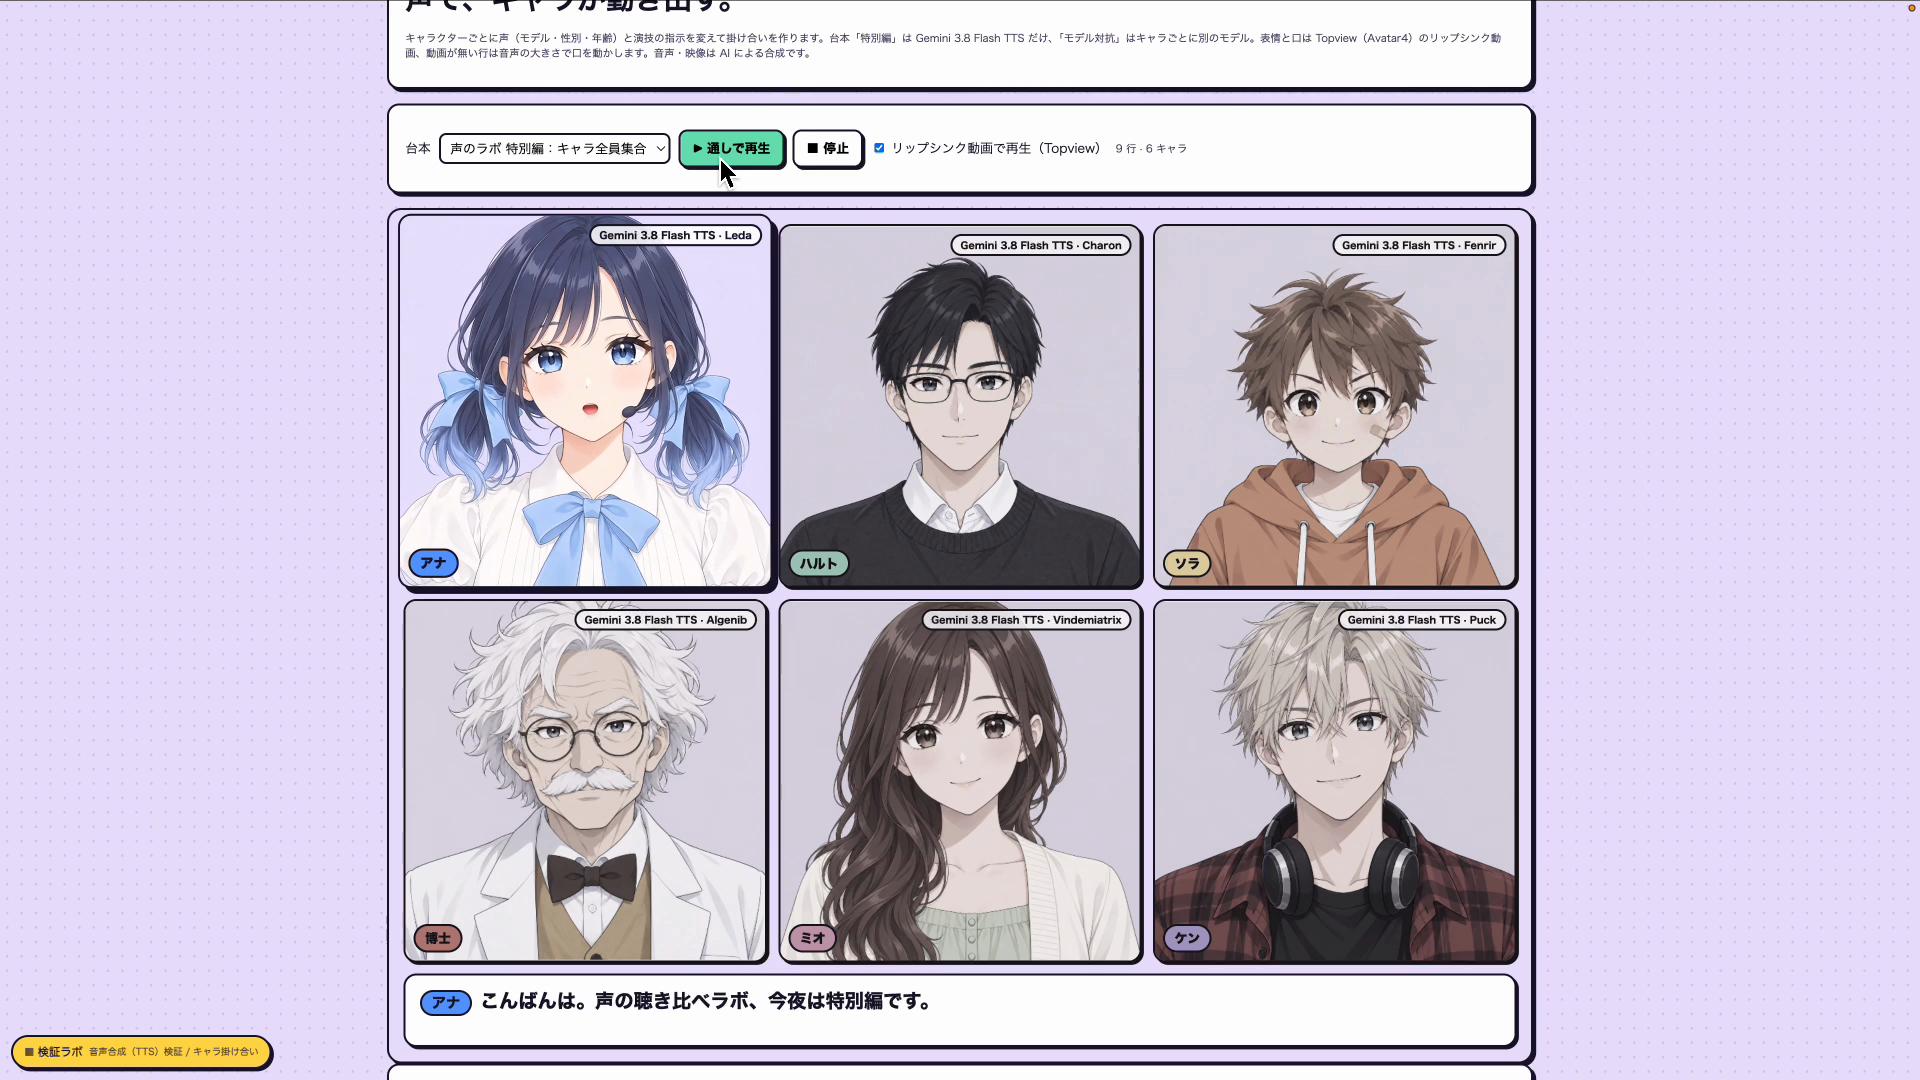
Gemini 3.8 Flash TTSは、Googleが2026年9月22日に正式版として公開した音声モデルです。TTSは「Text to Speech」の略で、用意した文章を声にして読み上げるためのモデルです。より安くて軽い「Gemini 3.8 Flash-Lite TTS」も同時に公開されました。
まずは、僕が作った「声の聞き比べラボ 特別編」を見てください。DJのケン、年配の博士、元気な小学生のソラ、ナレーターのハルト、アナウンサーのアナ、おっとりしたミオの6人が掛け合いをしていますが、声はすべてGemini 3.8 Flash TTSという1つのモデルで作っています。
「同じモデルでも声と話し方を選べばここまで変わるのじゃ」という博士のセリフどおり、話し方の癖や間の取り方まで人ごとに違って聞こえます。キャラごとに別のサービスを使い分ける必要はもうありません。
Gemini 3.8 Flash TTSの基本情報
| 項目 | 内容 |
|---|---|
| 正式名・モデルID | Gemini 3.8 Flash TTS(gemini-3.8-flash-tts) |
| 公開日 | 2026年9月22日に正式版(Googleの発表ブログは9月23日) |
| 使える場所 | Gemini API・Google AI Studio(Geminiアプリの画面からは使えない) |
| 役割 | 台本を一字一句読み上げる(リアルタイム会話は別モデルのGemini 3.8 Live) |
| 声の数 | 2,000以上 |
| 演技の指示 | 本文とは別の欄(style)に自然文で書く。<laugh>などのタグも使える |
出典:Gemini API(モデル)・Changelog・Speech generation・Google公式ブログ(2026年9月時点・公式参照)
同じ3.8世代の文章用モデルは、Gemini 3.8 Flashを実機検証|動画理解はClaude超え、大規模開発は厳しい理由で検証しています。
6人の声を分けたコツ|演技の指示より「声選び」
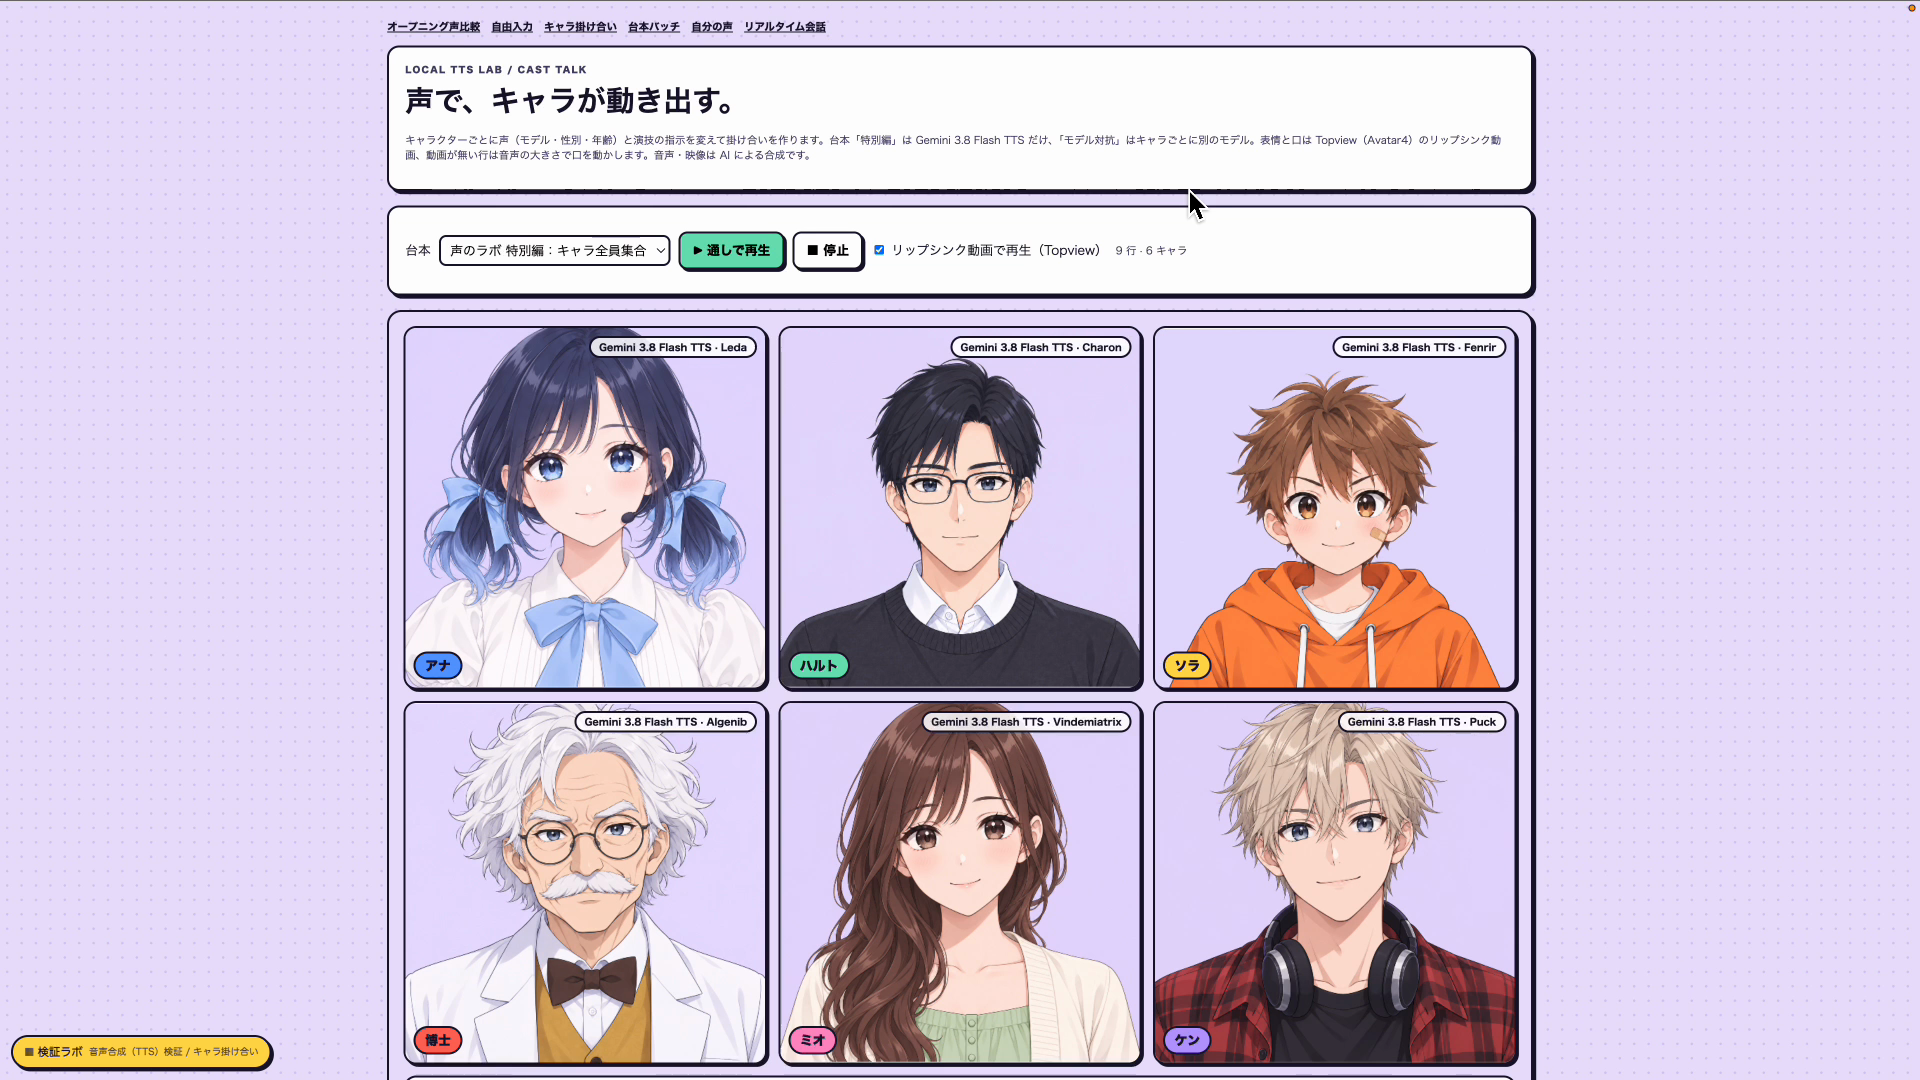
実は、最初からうまくいったわけではありません。既定の声のまま演技の指示だけを変えてみたところ、6人とも明るい女性の声に寄ってしまいました。演技の指示は話し方を変えるのは得意でも、声の高さや太さまでは変えきれないようです。
そこで、2,000以上ある声の中からキャラごとに声そのものを選び直しました。すると声の高さ(中央値)は103Hzから279Hzまで分かれ、低いナレーターのハルトから高い小学生のソラまで、耳で聞いてもはっきり別人になりました。
キャラの声は、演技の指示で寄せるより先に「声を選ぶ」のが近道です。演技の指示は、感情や間をのせる仕上げに使うとうまくいきます。
Claude Opus 5.5と組み合わせた映像|動画のオープニングも声から作れる
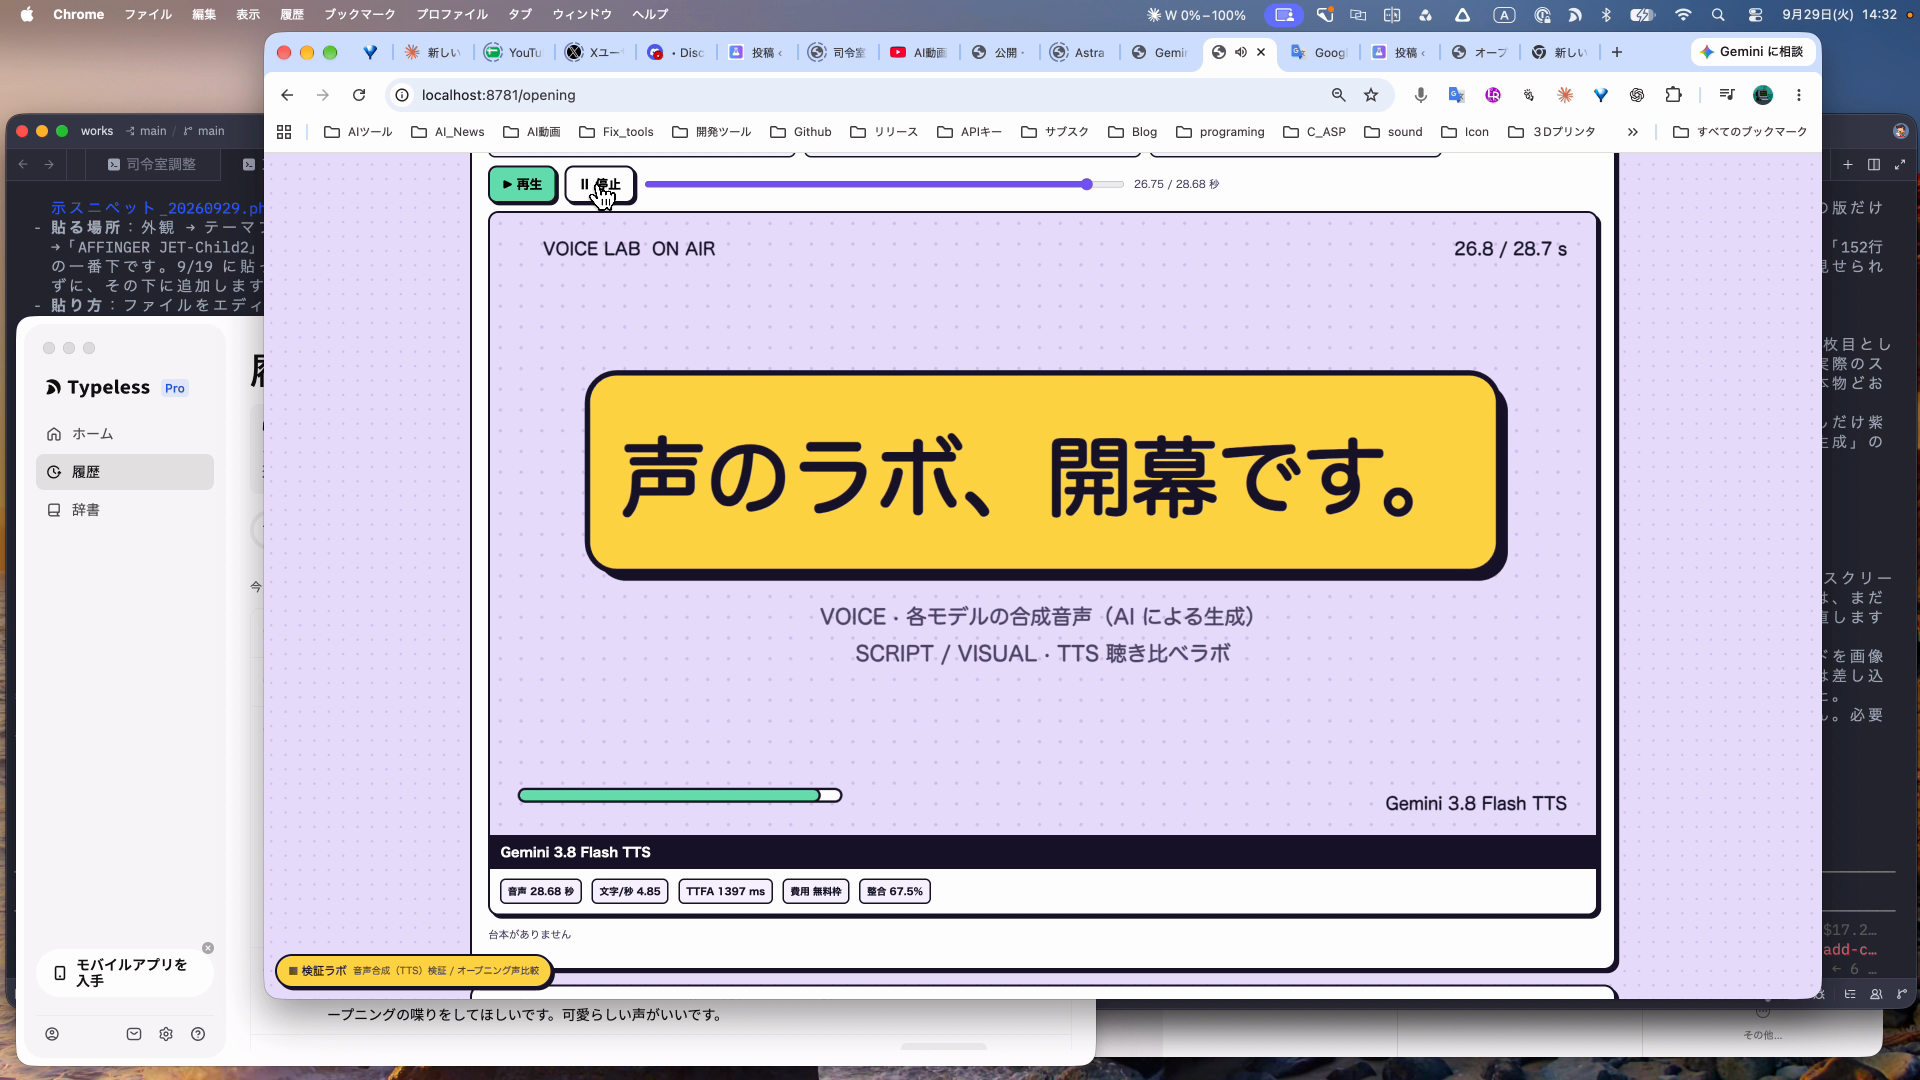
リリース直後から話題なのが、Claude Opus 5.5と組み合わせた動画づくりです。僕もGemini 3.8 Flash TTSの声とOpus 5.5の映像で、「音声モデル聞き比べ」の予告映像を作ってみました。
「用意したのは台本が1つ、映像も1つ。入れ替えるのは声だけです」というナレーションで始まり、「声のラボ開幕です」で締める映像です。声はGemini 3.8 Flash TTS、映像はOpus 5.5の担当で、どちらもかなり高いクオリティに仕上がりました。
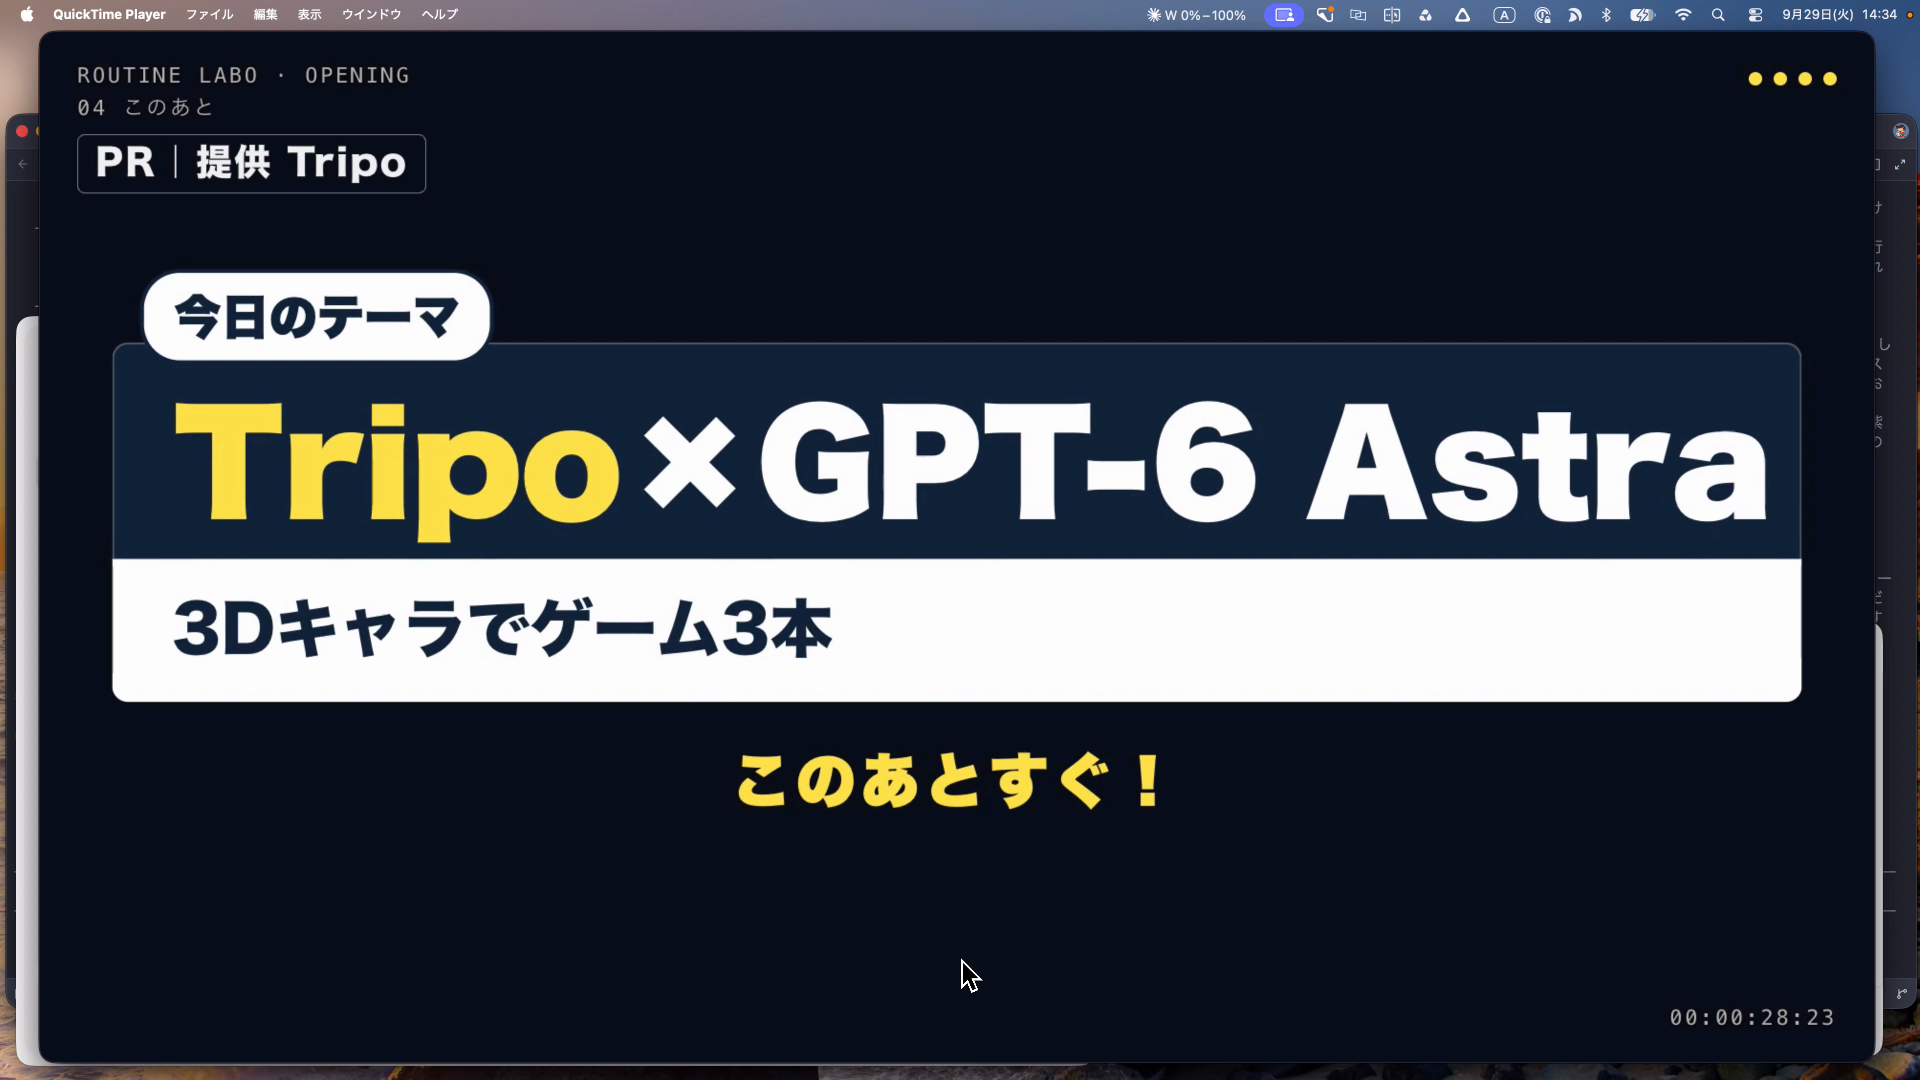
もう1本は、以前公開した3D生成AI「Tripo」の回のオープニングで、これも同じ組み合わせです。手作業で作っていたオープニングをAIに任せられるようになり、制作がかなり楽になりました。
その回の中身はTripo AIの使い方|GPT-6 Astraで3Dゲームを3本作るで紹介しています。映像づくりに使ったClaude Opus 5.5の実力は、Claude Opus 5.5とは|Fable 5.1並みの性能を4割の料金で使えるで詳しく検証しました。
-
-
Claude Opus 5.5とは|Fable 5.1並みの性能を4割の料金で使える
続きを見る
TTSとLiveの違い|台本を読むか、その場で会話するか
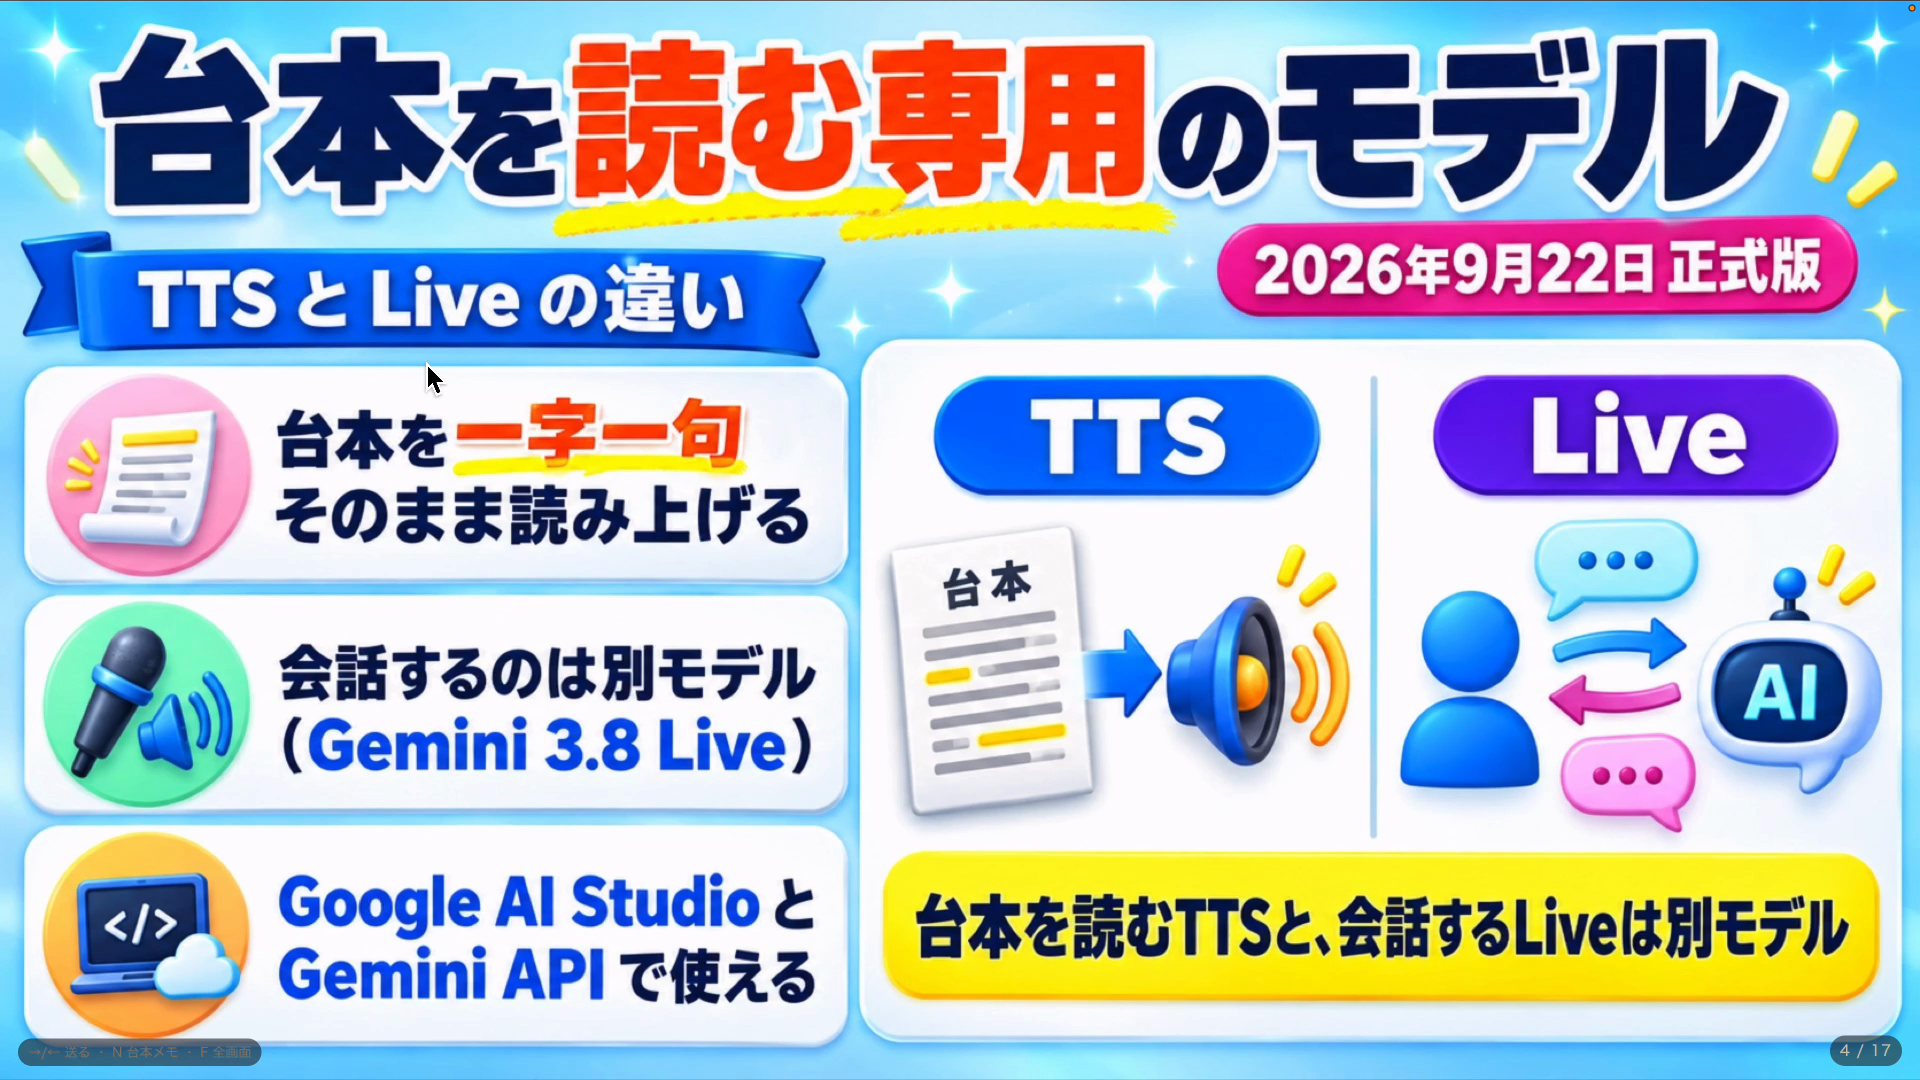
Googleの音声モデルには、今回のTTSとは別に「Live」があります。名前が似ているので混同しやすいのですが、役割ははっきり分かれています。TTSはあらかじめ用意した台本を読み上げるモデルで、Liveはリアルタイムで人と声のやり取りをするモデルです。
| 比べる点 | TTS(Gemini 3.8 Flash TTS) | Live(Gemini 3.8 Live) |
|---|---|---|
| 何をするモデルか | 用意した台本を一字一句読み上げる | 人の声を聞いて、その場で声で返す |
| 入力するもの | 台本の文章+演技の指示 | 人の声(マイク) |
| 向く使い方 | 動画・ショートのナレーション、キャラの掛け合い、ゲームの台本 | 音声アシスタント、アバターとの会話、アプリの音声対話 |
出典:Gemini API(Speech generation)(2026年9月時点・公式参照)
アバターと会話するアプリや音声アシスタントならLive、動画のナレーションやキャラの掛け合いのように「言わせたいセリフが決まっている」ものはTTSの担当です。Liveは後半で実際に会話した様子を紹介します。
Gemini 3.8 Flash TTSの料金|公式の単価と僕の実費
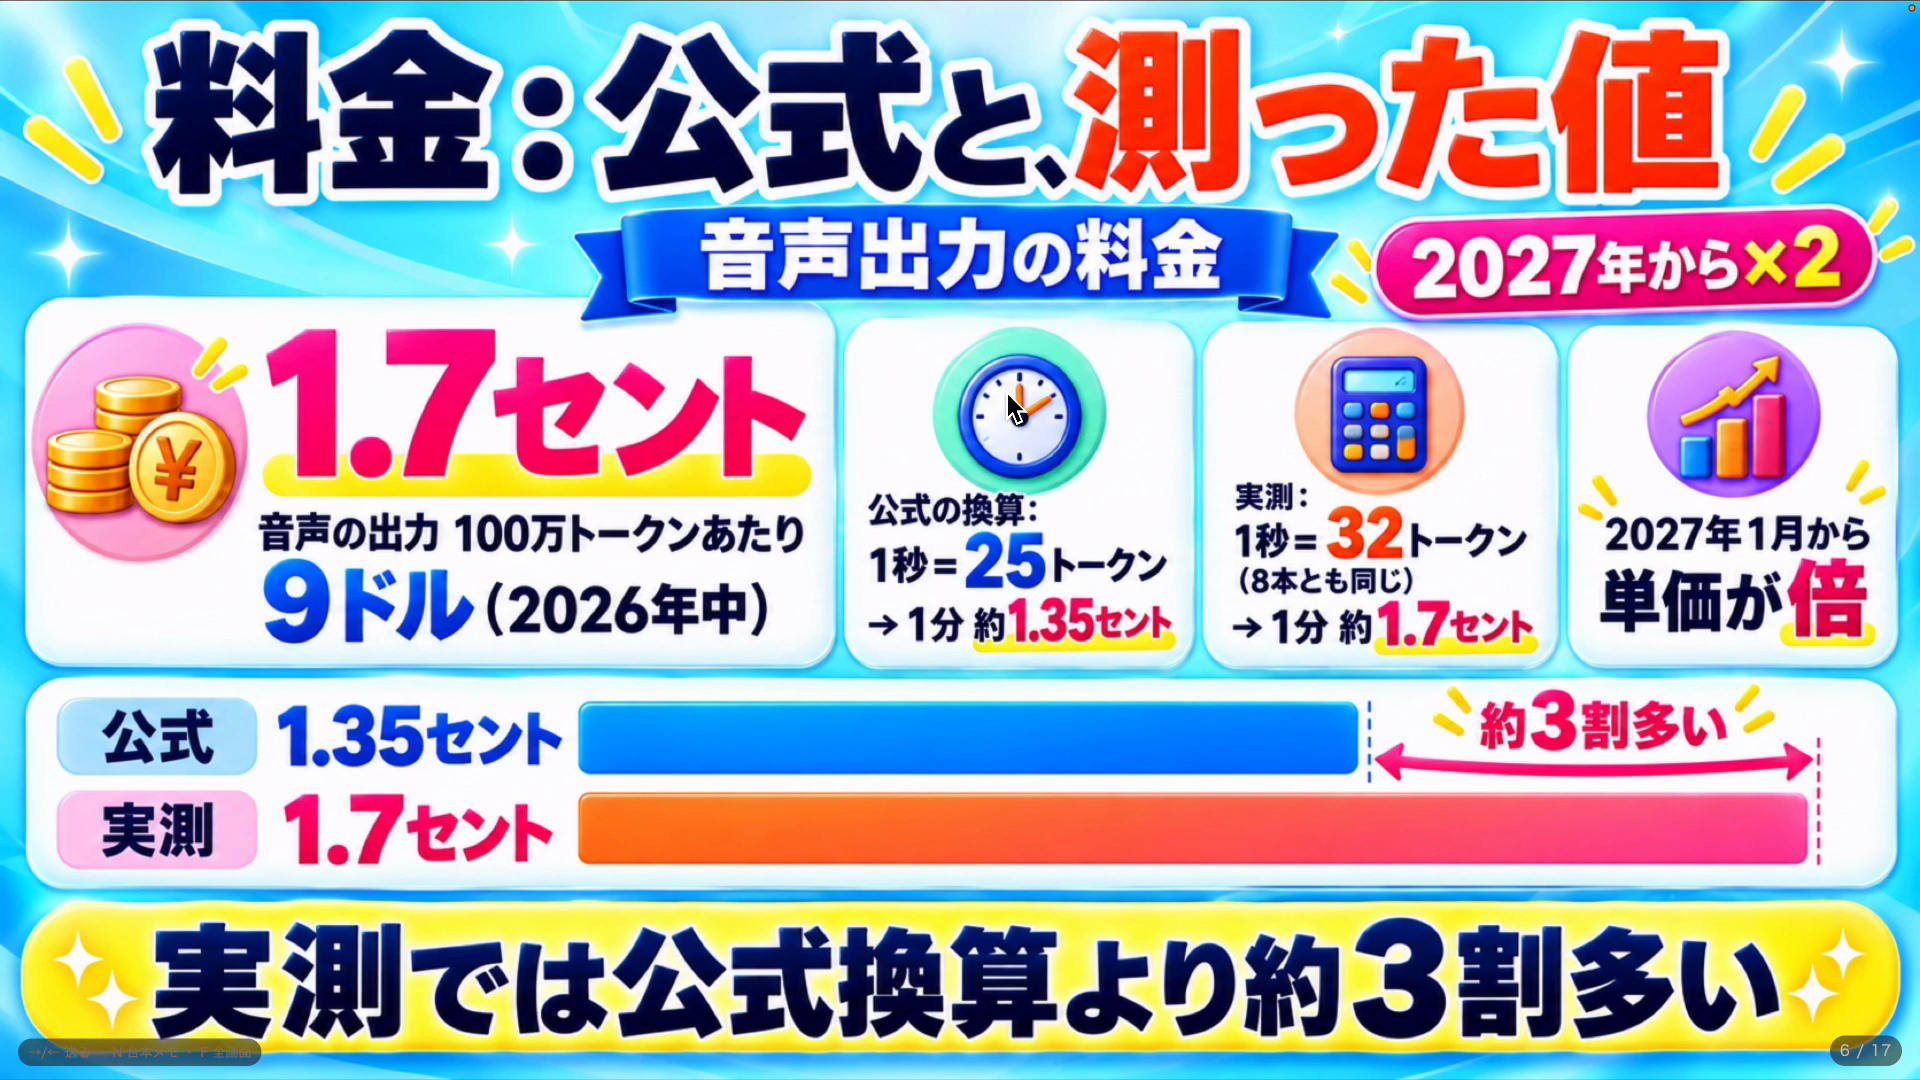
料金は、作った音声の長さに応じたトークン(AIが扱う量の単位)で決まります。公式の単価と、僕が実際に払った金額を順に見ていきます。
公式の料金|2027年1月から単価が倍
| 項目(100万トークンあたり) | 2026年12月31日まで | 2027年1月1日から |
|---|---|---|
| 音声の出力 | 9ドル | 18ドル |
| テキストの入力 | 0.5ドル | 1ドル |
| 無料枠 | あり(無料枠のデータは製品改善に使われる) | |
出典:Gemini API(Pricing)(2026年9月時点・公式参照)
2027年1月1日からは出力も入力も単価が倍になるので、気になっている方は今のうちに試しておくのがおすすめです。
実際にかかった費用|1分約1.7セント・利用額は約785円
ここからは自分で測った値です。8本の音声で課金を確かめると、音声1秒あたり32トークンで8本とも同じでした。公式の換算(音声1秒=25トークン)より約3割多い計算です。
| モデル | 料金の目安 | メモ |
|---|---|---|
| Gemini 3.8 Flash TTS(公式の換算) | 1分あたり約1.35セント | 音声1秒=25トークンで計算 |
| Gemini 3.8 Flash TTS(僕の実測) | 1分あたり約1.7セント | 音声1秒=32トークン(8本とも同じ) |
| ElevenLabs v3 | 1分あたり約0.10ドル | 100万字あたり100ドル |
| Fish Audio S2.1 Pro | 100万バイトあたり15ドル | 文字数ではなくデータ量で課金 |
出典:実測はルーティンラボの計測(2026年9月)。ElevenLabs API料金・Fish Audio料金(2026年9月時点・公式参照)
オープニング映像を3本作り、検証ダッシュボードで前の世代のモデルも含めて何度も生成して、ここまでの利用額は約785円です。かなり使い込んでこの金額なので、個人で試す分には十分許容範囲だと感じています。
使いすぎに注意
1本あたりが安くテンポよく作れるぶん、気づくと大量に作っていることがあります。30分や1時間の長い音声を毎日作るような使い方だと費用は積み上がるので、長尺をまとめて作る前に一度見積もってみてください。
日本語の聞き比べランキングは1位|英語ではEleven v4が首位に
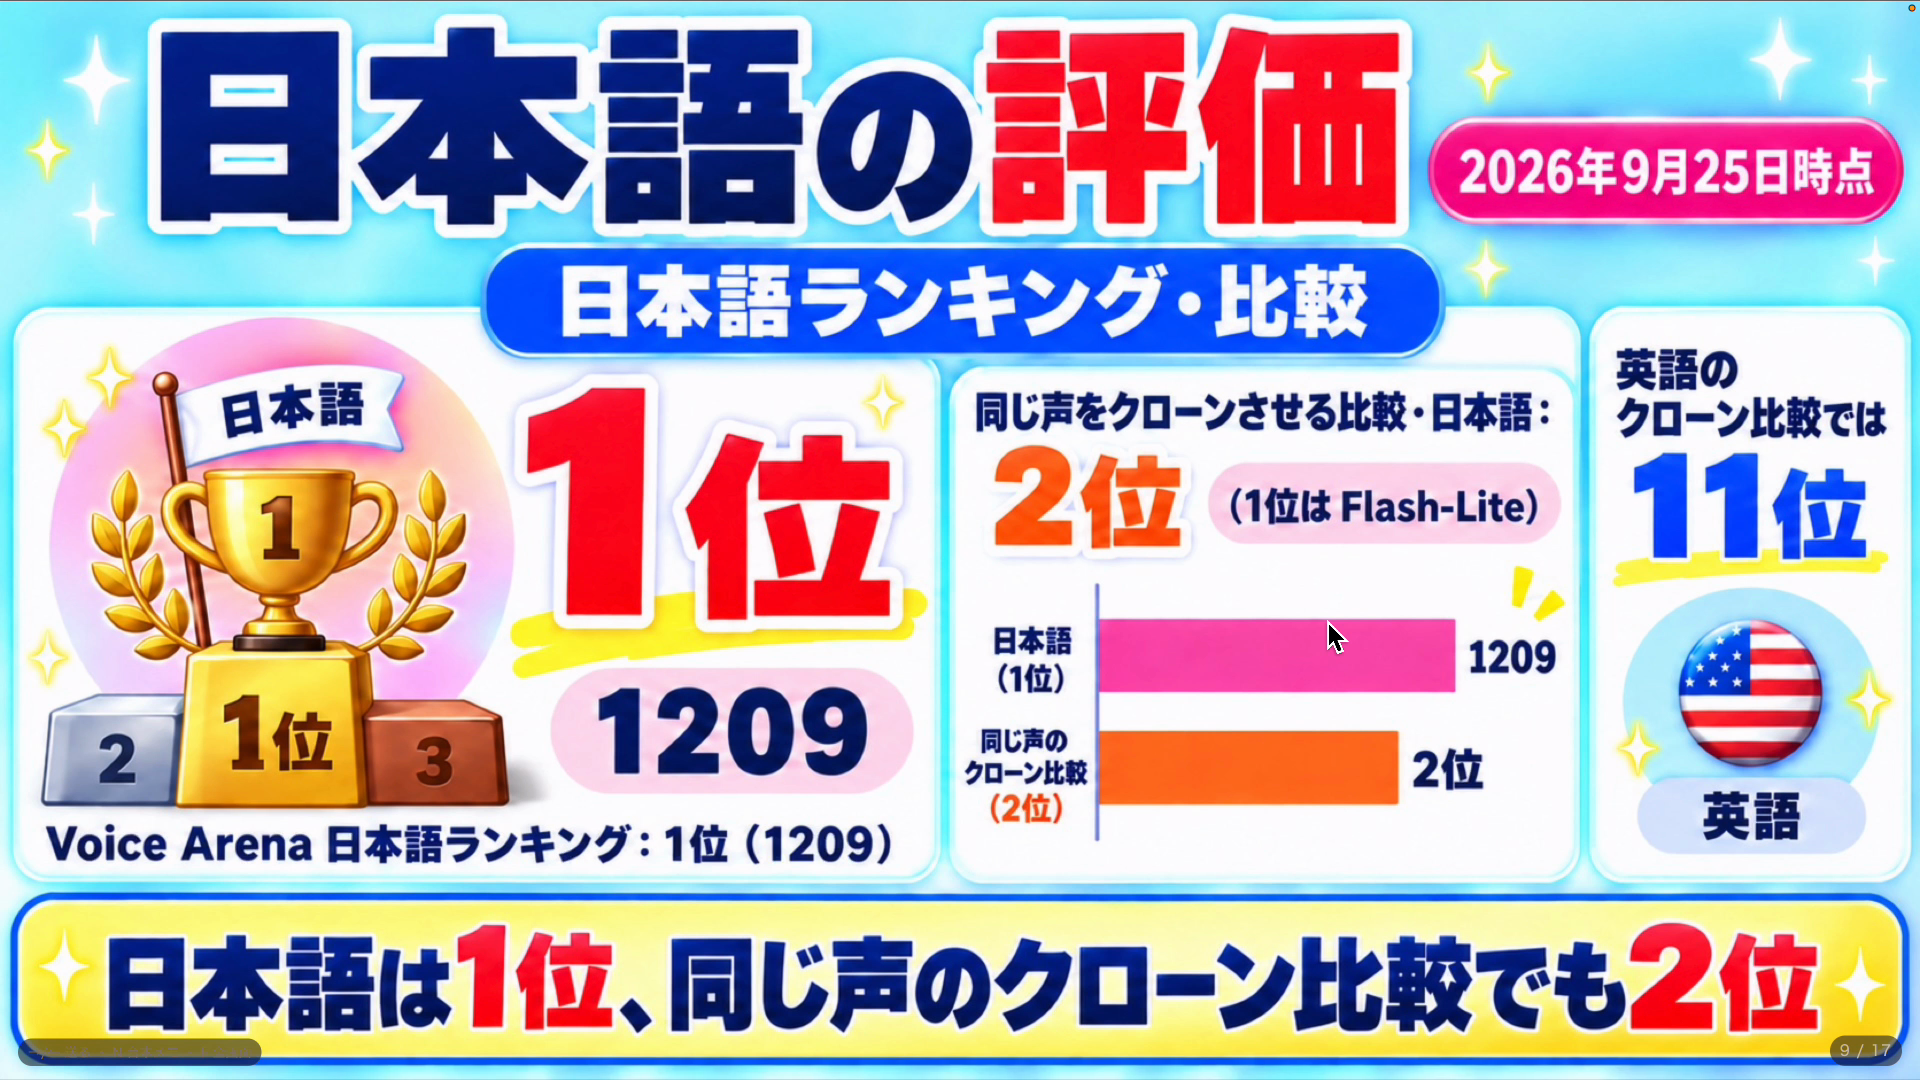
Gemini 3.8 Flash TTSが注目されている理由のひとつが、日本語の評価の高さです。聞き比べた人の好みで順位が決まる「Voice Arena」の日本語部門で、2026年9月29日時点で1位に入っています。僕もこれまでFish AudioやElevenLabsをよく使っていましたが、日本語はGemini 3.8 Flash TTSがいちばん自然に聞こえました。
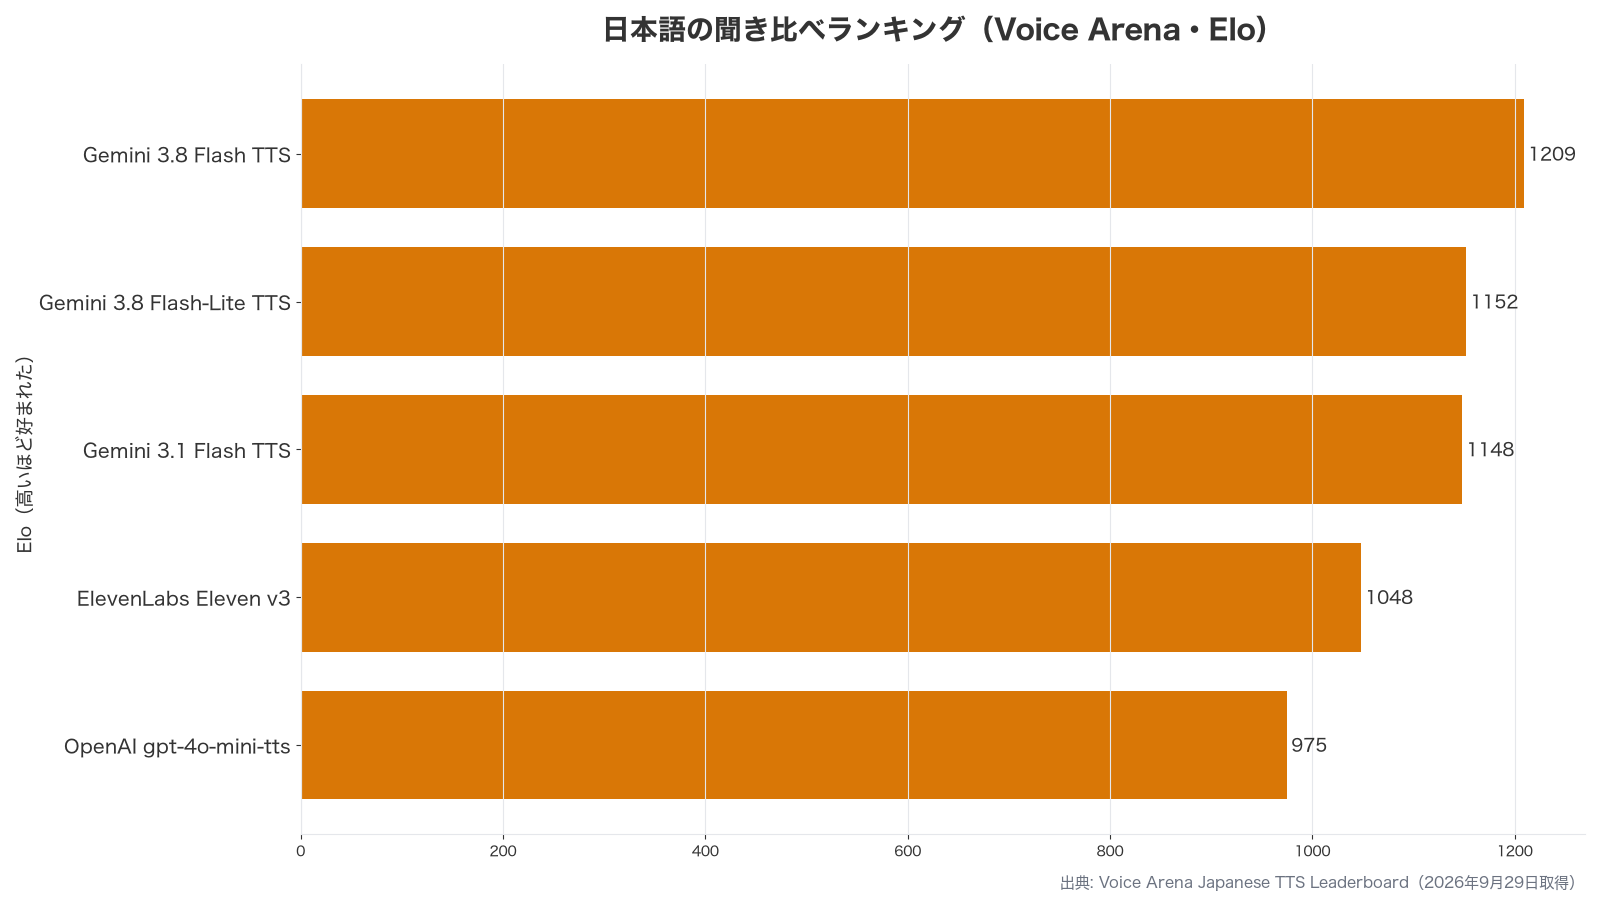
| 順位 | 日本語(Voice Arena・Elo) | 英語の総合(Artificial Analysis・Elo) |
|---|---|---|
| 1位 | Gemini 3.8 Flash TTS(1209) | Eleven v4(1315) |
| 2位 | Gemini 3.8 Flash-Lite TTS(1152) | Sonic 3.6(1275) |
| 3位 | Gemini 3.1 Flash TTS(1148) | Gemini 3.8 Flash TTS(1267) |
| 4位 | Eleven v3(1048) | — |
| 5位 | gpt-4o-mini-tts(975) | — |
出典:Voice Arena(日本語)・Artificial Analysis Speech Arena(2026年9月29日時点)
ただし、音声AIの順位は短い期間で入れ替わります。Gemini 3.8 Flash TTSの公開から数日後の2026年9月28日に、ElevenLabsが新モデルのEleven v4とv4 Turboを発表しました。90以上の言語に対応し、10秒の音声で声をクローンでき、日本語の品質の伸びがいちばん大きいとしています(TechCrunch)。英語の総合ランキングではEleven v4が1位になり、Gemini 3.8 Flash TTSは3位です。
日本語のランキングにはEleven v4がまだ載っておらず、9月29日時点の日本語の1位はGemini 3.8 Flash TTSのままです。今は、英語ならEleven v4、日本語ならGemini 3.8 Flash TTSと言語で使い分けるのが現実的です。ElevenLabsの使い方はElevenlabs完全ガイドで解説しています。
Gemini 3.8 Flash TTSの使い方|Google AI Studioで声を試す・作る
Gemini 3.8 Flash TTSは、GoogleのAIモデルをブラウザで試せる「Google AI Studio」から使えます。Googleアカウントがあれば使えますが、ふだんのGeminiアプリの画面からは使えないので注意してください。
AI StudioでGemini 3.8 Flash TTSを開く
step
1Google AI Studioを開く
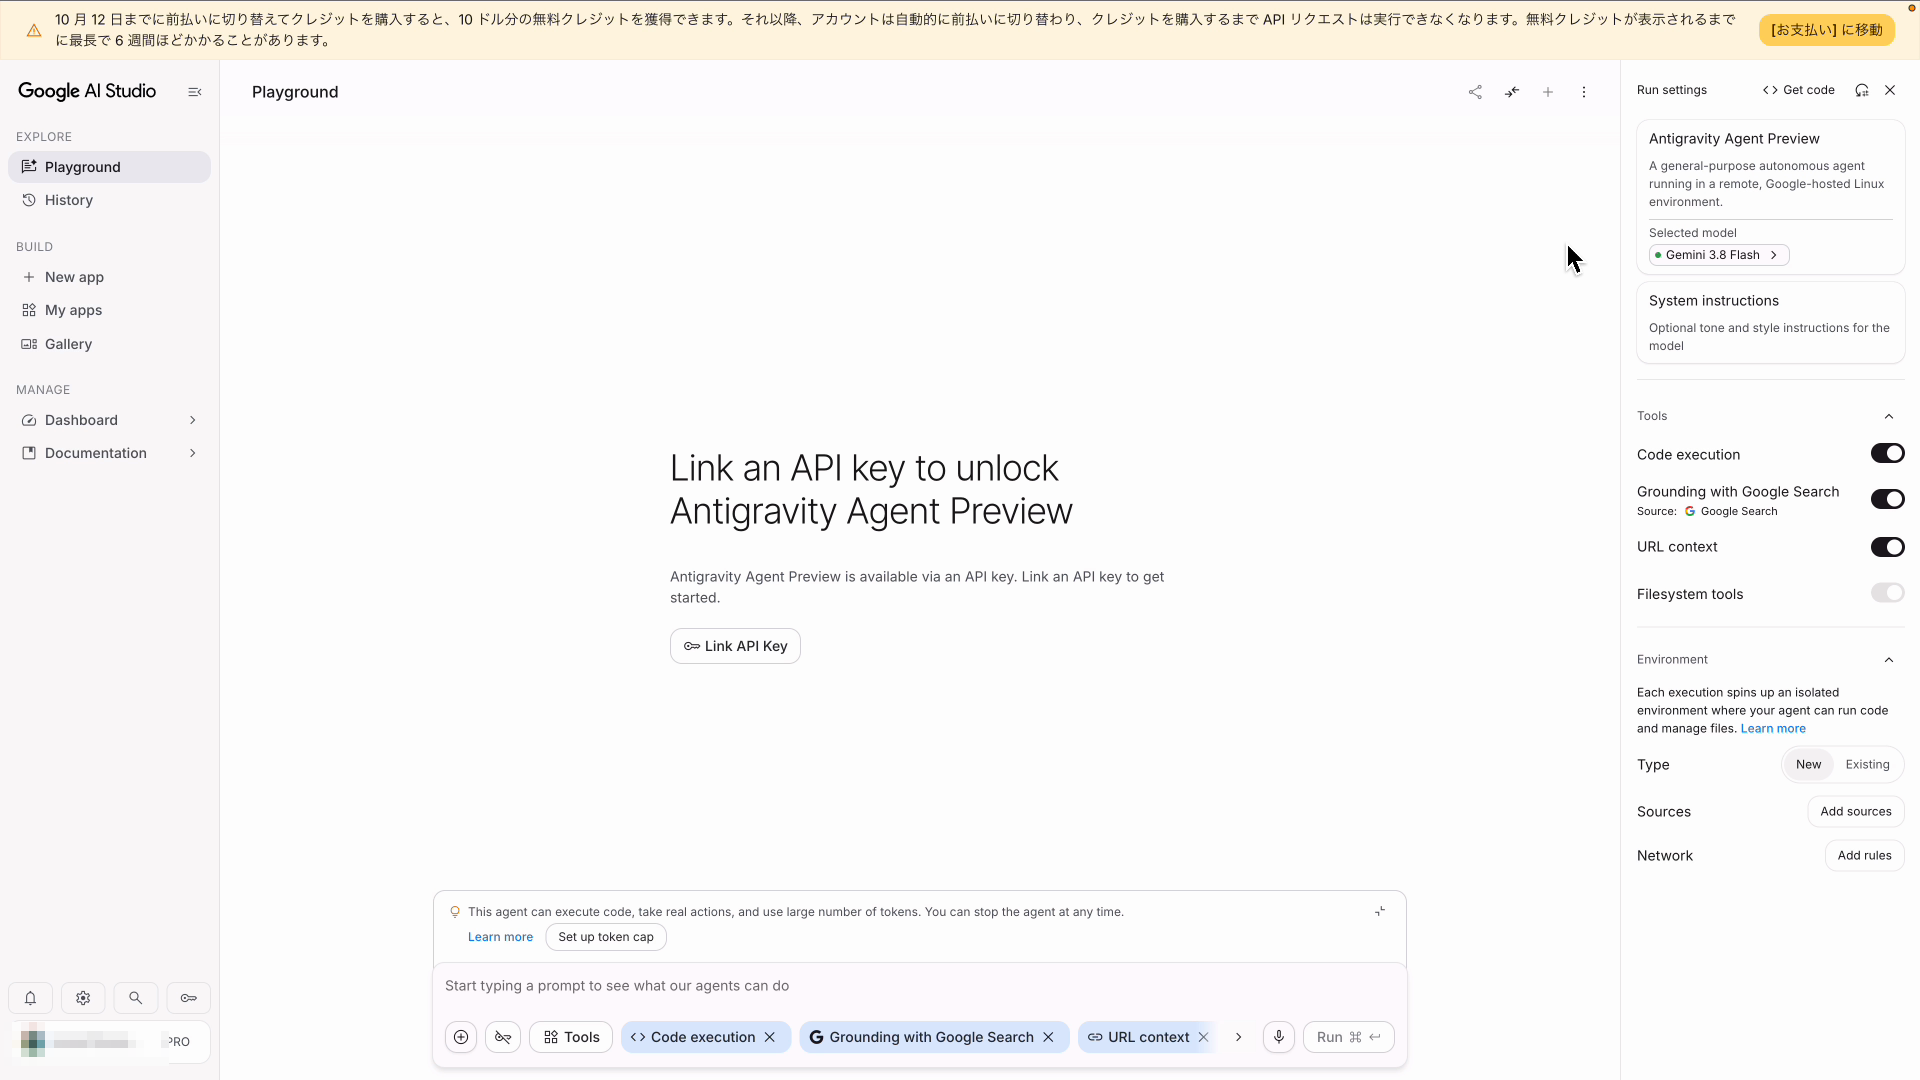
「Google AI Studio」で検索するか、AI Studioの音声生成の画面を開いて、Googleアカウントでログインします。
step
2Gemini 3.8 Flash TTSを選んで声を聞いてみる
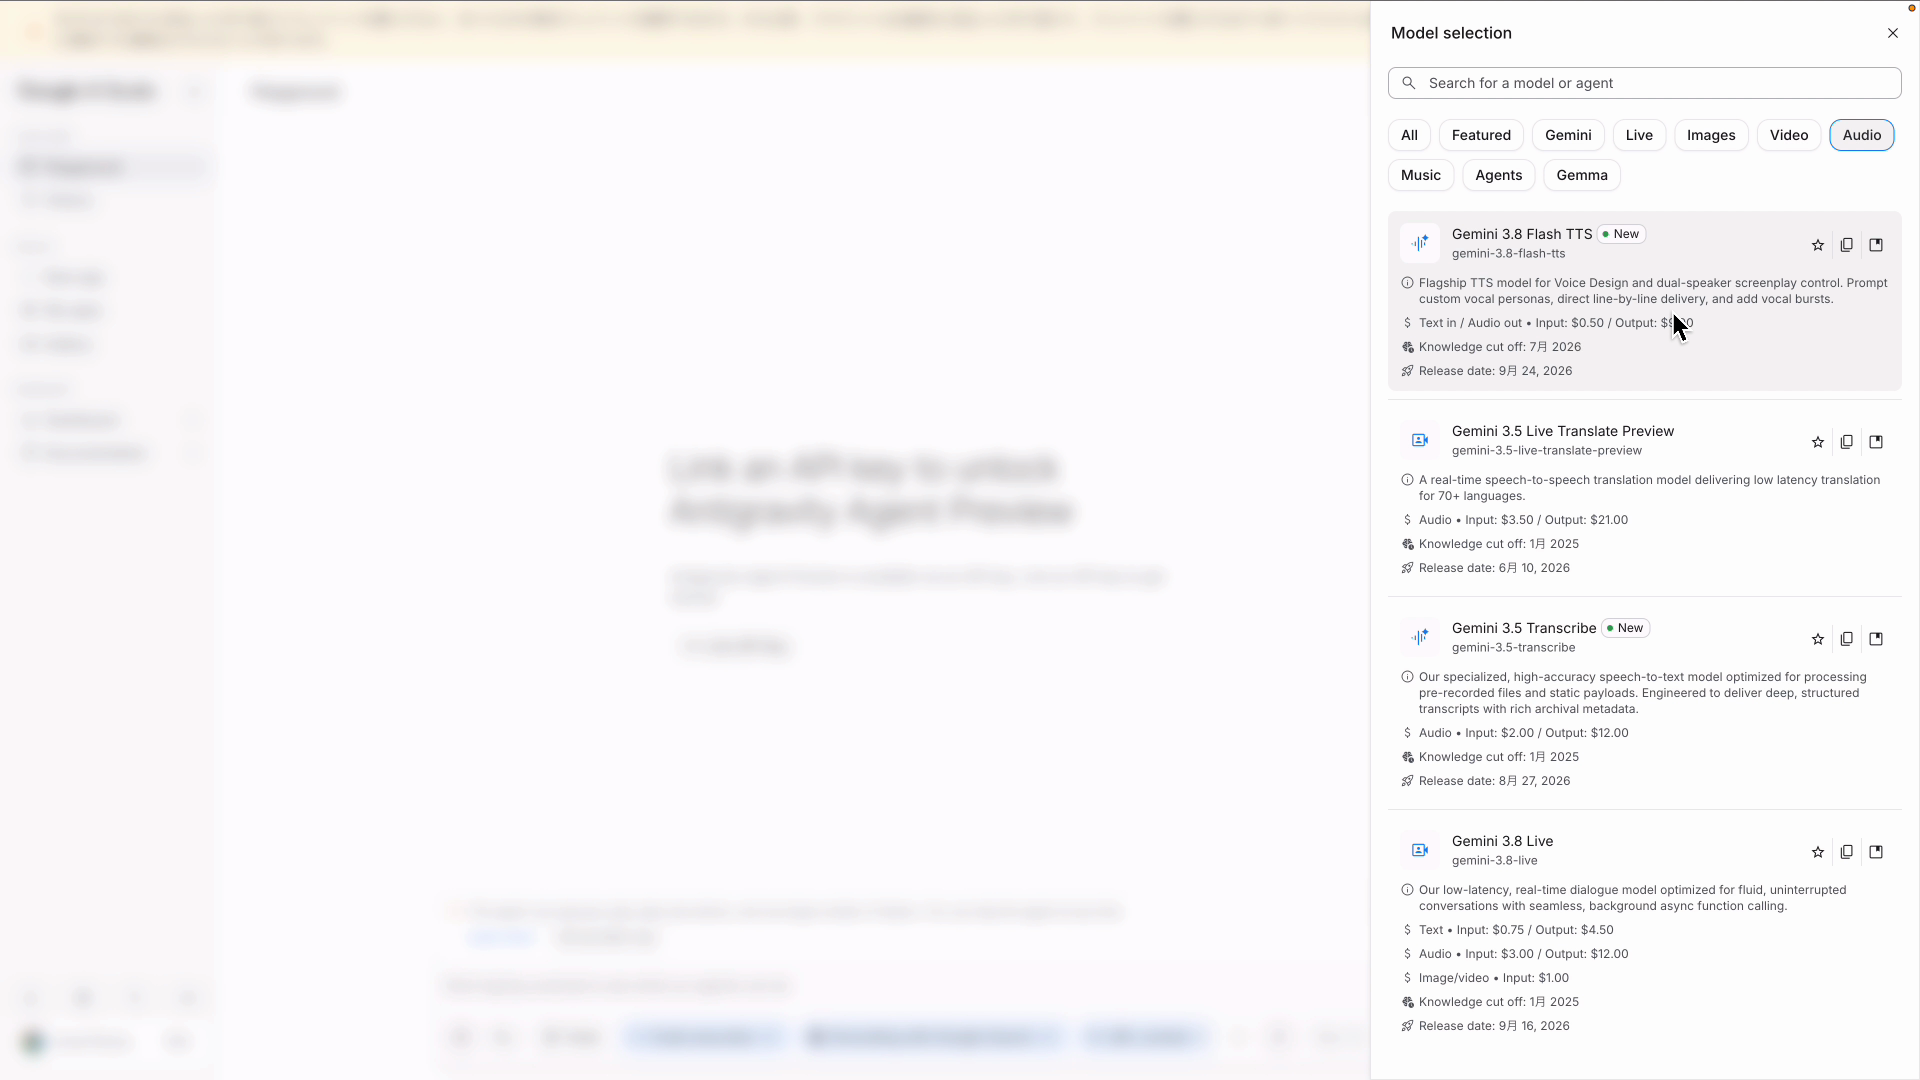
画面右上のモデル一覧でオーディオの項目を開き、Gemini 3.8 Flash TTSを選びます。用意された声のサンプルは英語ですが、かなりナチュラルです。同じ一覧からは会話用のGemini 3.8 Liveも選べます。
声を作る2つのモード|Voice DesignとVoice Replication
「Create new voice」を押すと、文章で声を作るVoice Designと、自分の声を録音して複製するVoice Replicationの2つから選べます。
| 比べる点 | Voice Design(声の設計) | Voice Replication(声の複製) |
|---|---|---|
| どう作るか | 1〜2文の説明文から声を作る | 本人の声の録音から声を作る |
| 必要なもの | 声の説明文 | 10〜30秒の本人の声+同意文を本人が読んだ録音 |
| 作れる声 | 説明に合う声(試し聞きは3つ) | 自分の声だけ(他人の声は作れない) |
| AI Studioで使う条件 | 有料の階層(支払い設定をしたAPIキー)が必要 | |
| 僕が試した結果 | 3つの声ができた(1つ約2円) | 何度試してもエラーで作れなかった |
出典:Voice design・Voice replication(2026年9月時点・公式参照)・AI Studioの画面表示(2026年9月25日確認)
Voice Replication(声の複製)は何度試してもエラーだった
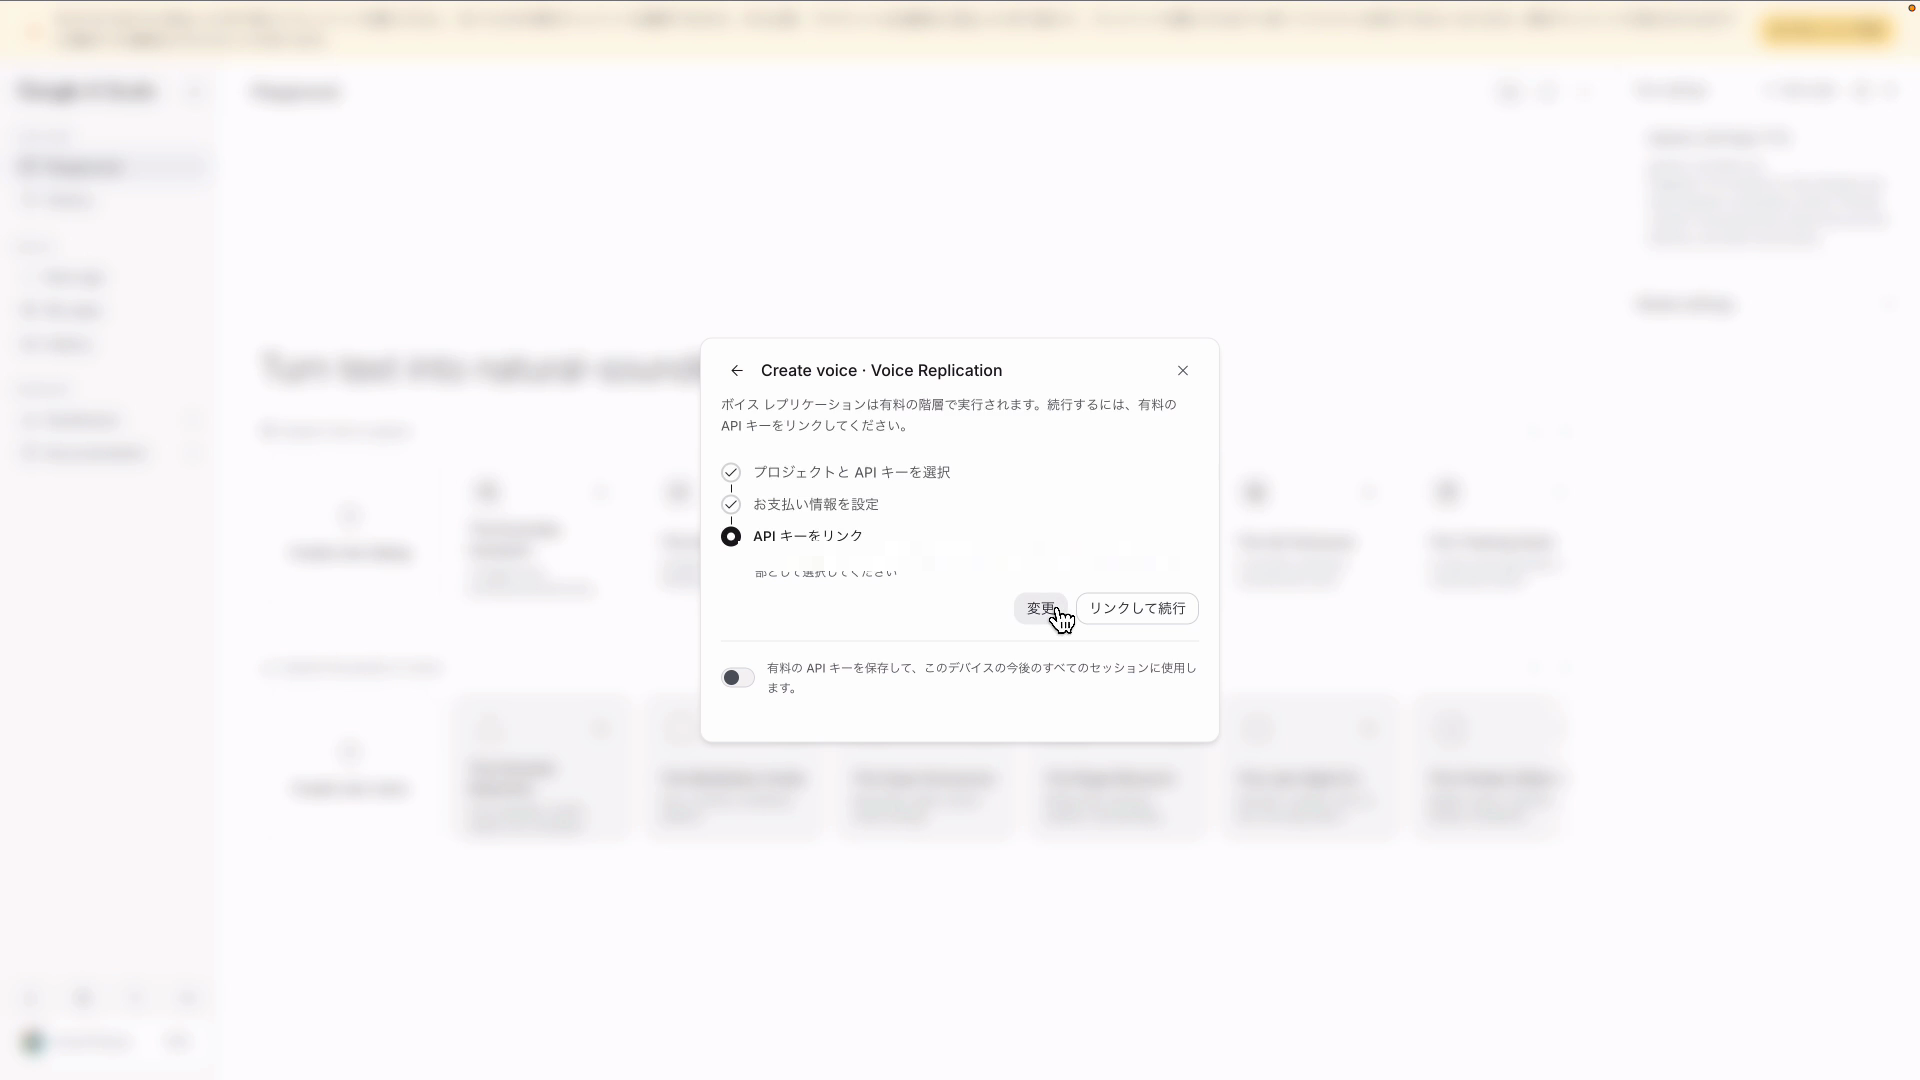
最初に自分の声の複製を試しましたが、何度やってもエラーで先に進めませんでした。表示されたのは「Consent flow failed」、つまり同意の確認に失敗したというメッセージです。複製には画面に出る英語の同意文を本人が読み上げる必要があり、ここを文面どおりに読まないと通らないようです。
今回は複製をあきらめて、文章で声を作るVoice Designのほうを試しました。
Voice Designで声を作る手順|「20歳の元気な日本人女性」
Voice Designは、ほしい声を文章で書くだけで新しい声を作ってくれる機能です。年齢・声の高さ・話し方・なまりを1〜2文で伝えるのがコツです。
step
3Create new voiceからVoice Designを選ぶ
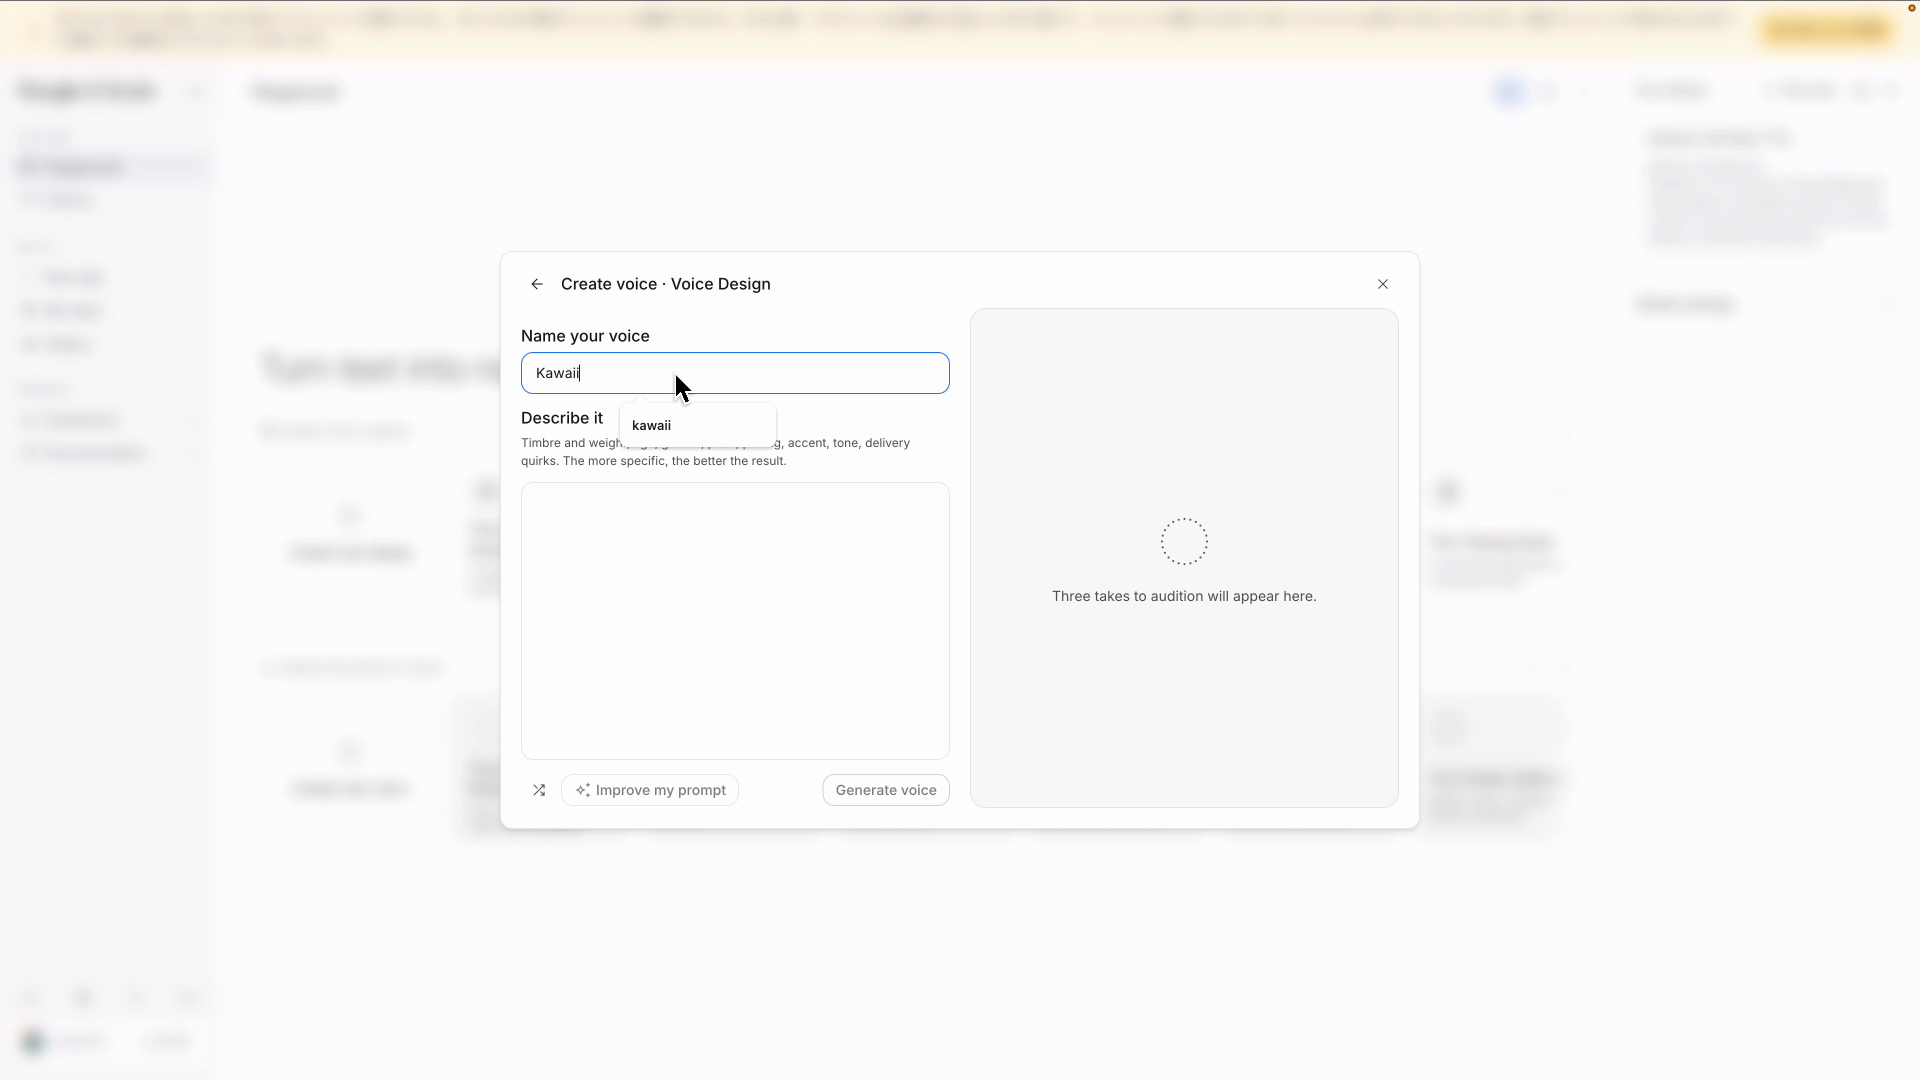
Create new voiceからVoice Designを選び、「かわいい声」のように、あとで見て分かる名前を登録します。
step
4声の説明文を「Describe it」に入れる
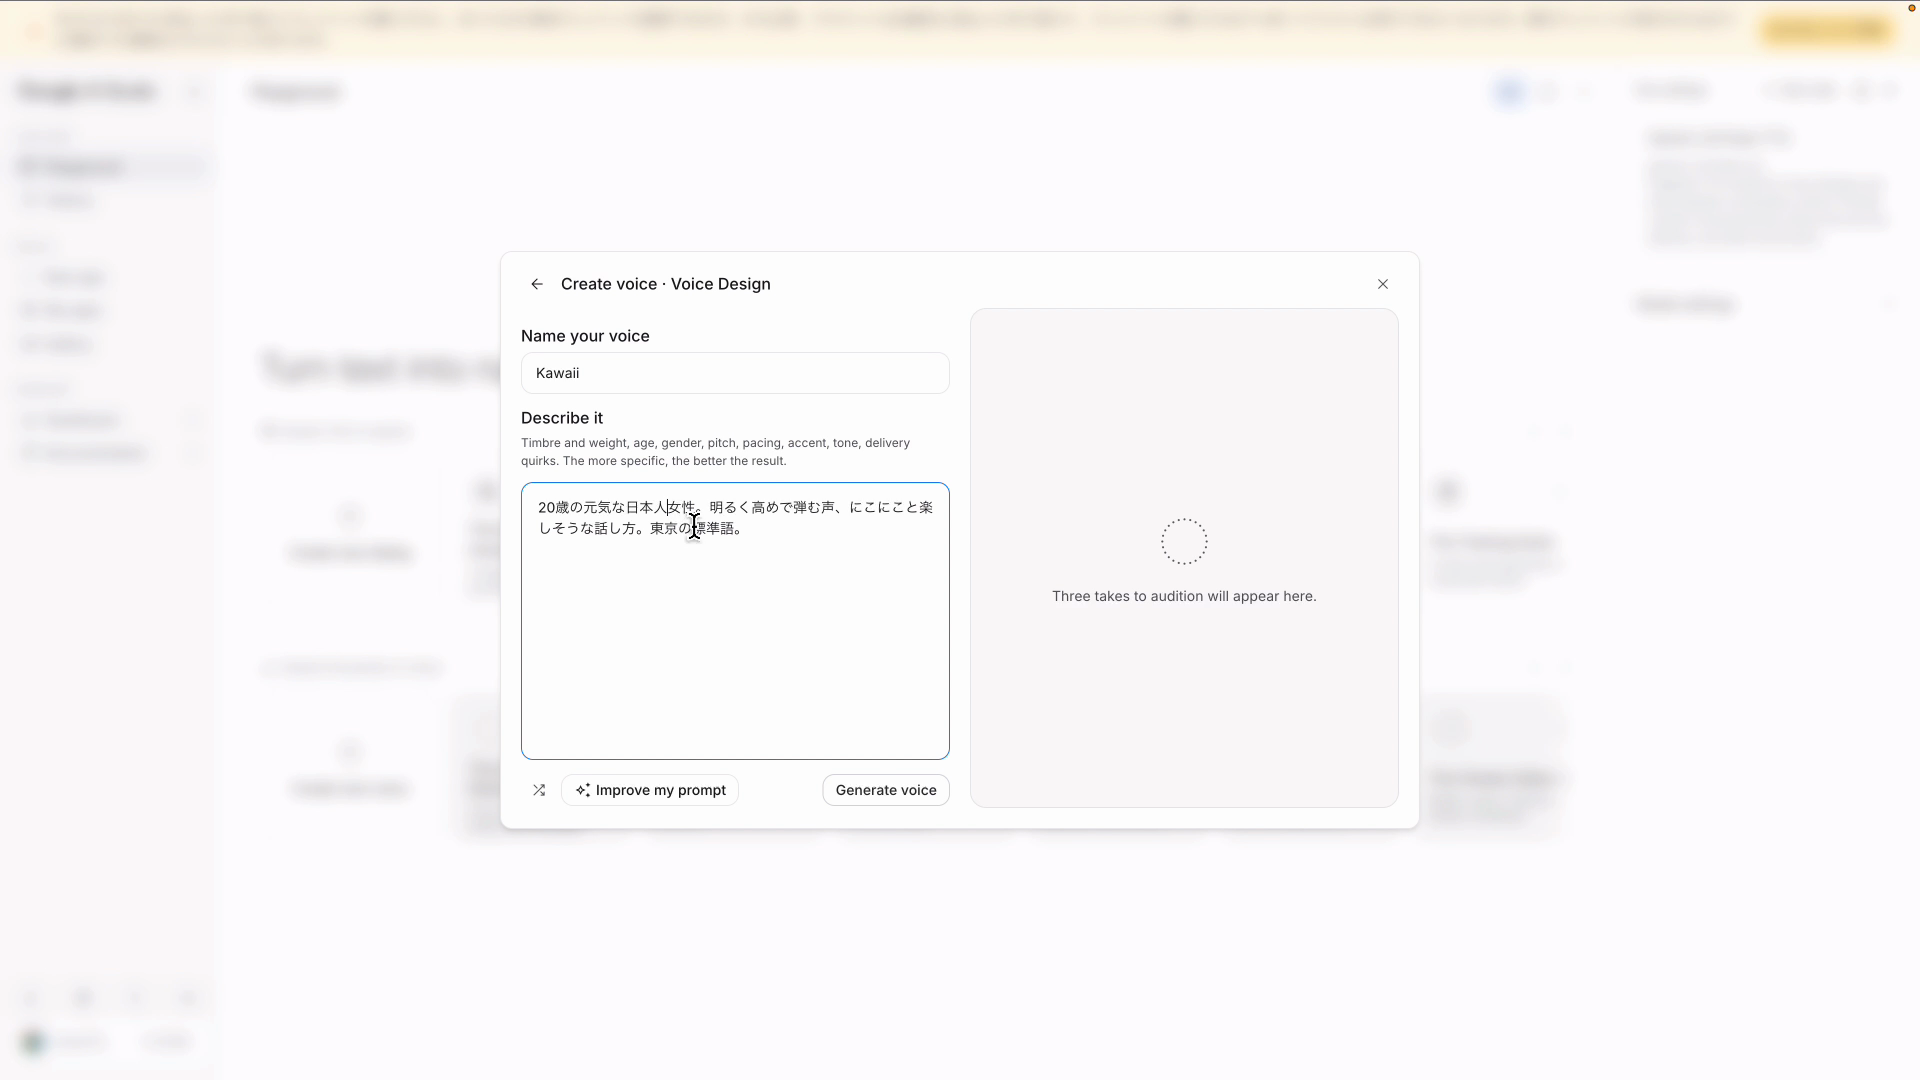
「Describe it」の欄に声の説明文を貼り付けます。「20歳の元気な日本人女性」のように、年齢と日本人であることをはっきり入れておくと日本語向けの声になりやすいです。説明文の例はこちらです。
20歳の元気な日本人女性。明るく高めで弾む声、にこにこと楽しそうな話し方。東京の標準語。
step
5Improve my promptを押して3つの声を聞き比べる
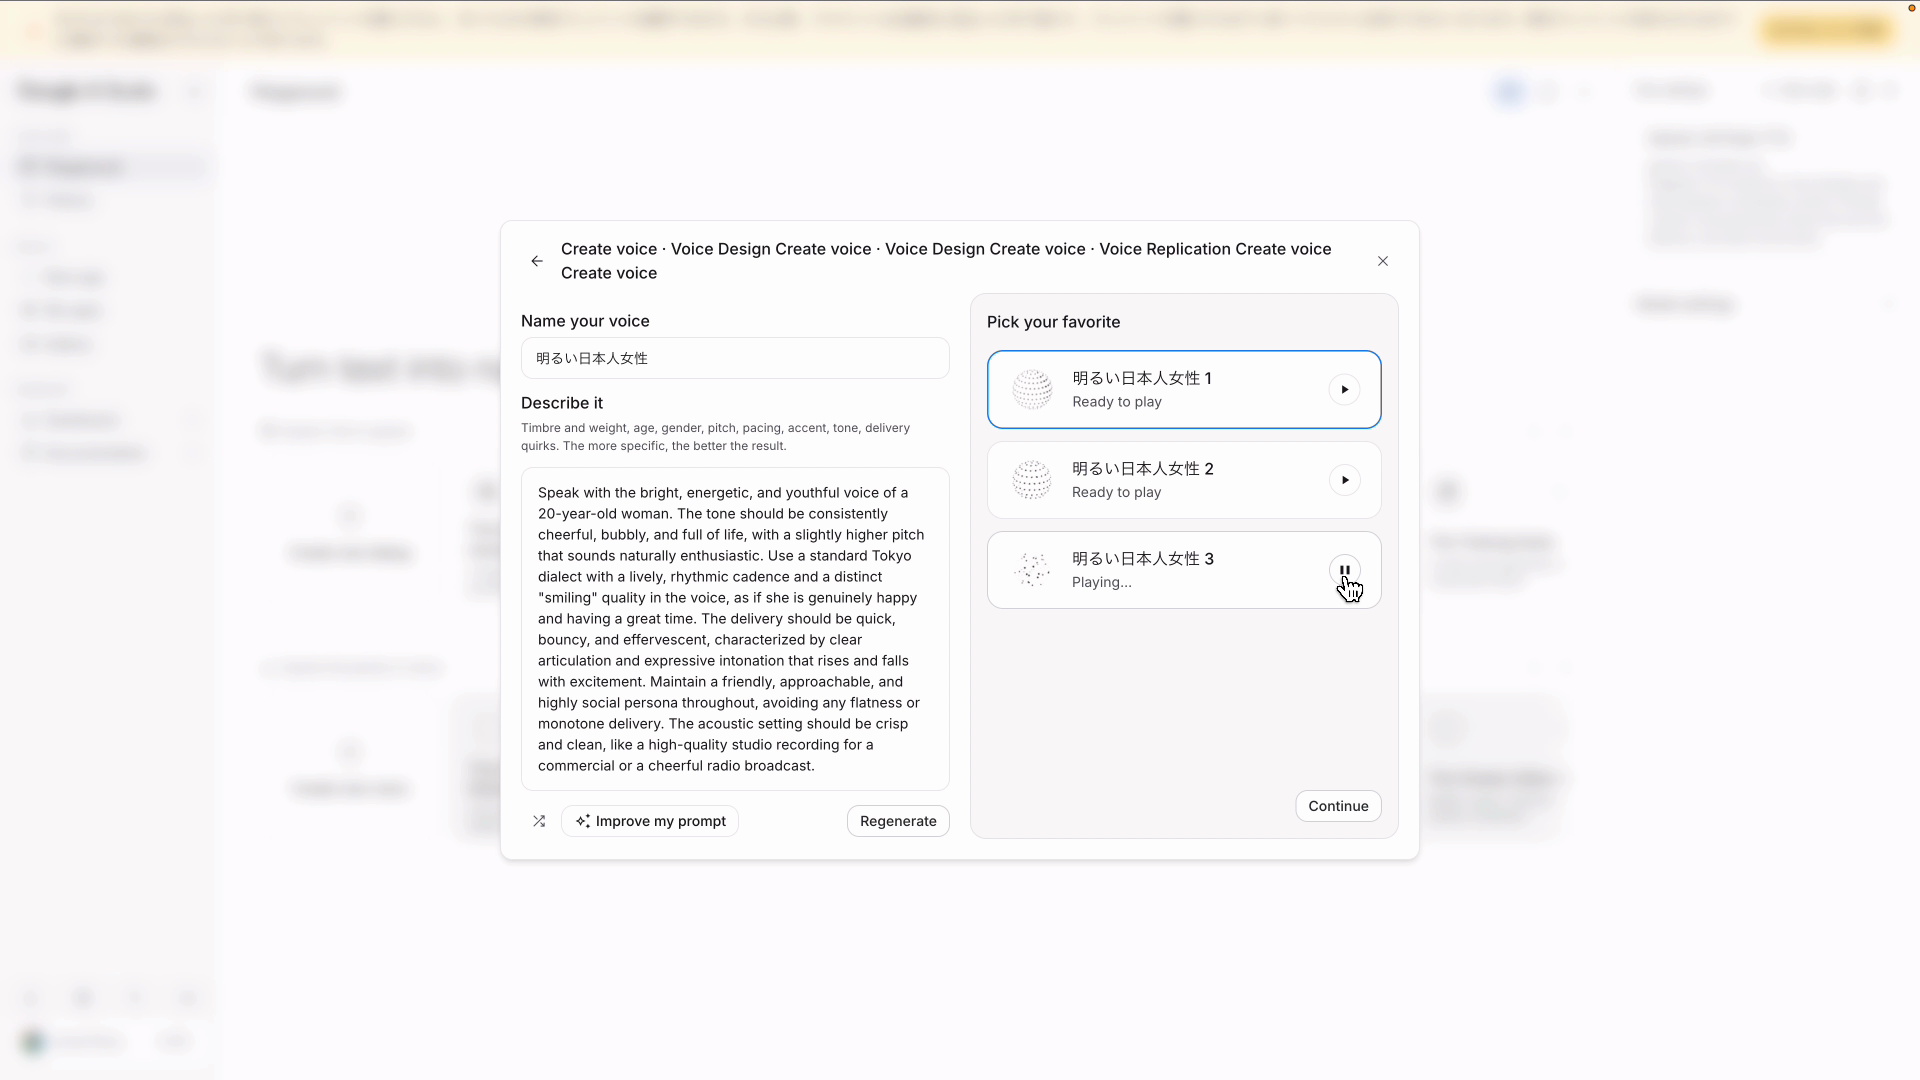
「Improve my prompt」を押すと、AIが説明文をより細かく書き直してくれます。生成すると候補の声が3つできるので、聞き比べて気に入ったものを保存すれば、いつでも読み上げに使えます。
作ってみた声と、つまずいたところ
できた3つは、どれも明るめの女性の声でした。違いはそこまで大きくありませんが、「えー、やばい、ここすごくおしゃれなお店ができたじゃん」のような話し言葉も自然に読んでくれます。ただ、「日本人女性」と指定しても、3つのうち1つが英語混じりの声になることがときどきありました。
声づくりでつまずきやすいところ
- 説明文に「10代」と書くと安全フィルタで止まる(20歳にすると通った)
- 声を1つ作ると、試し聞き音声の分として約2円かかる
- 読み間違い(Gemini→ジェミナイ、東海林→ショーリ)は、本文をカタカナ・ひらがなに書き換えると直る。括弧のふりがなや演技の指示での読み指定は効かなかった
AI音声8モデルを感情と英日混在で聞き比べ|検証ダッシュボードの結果
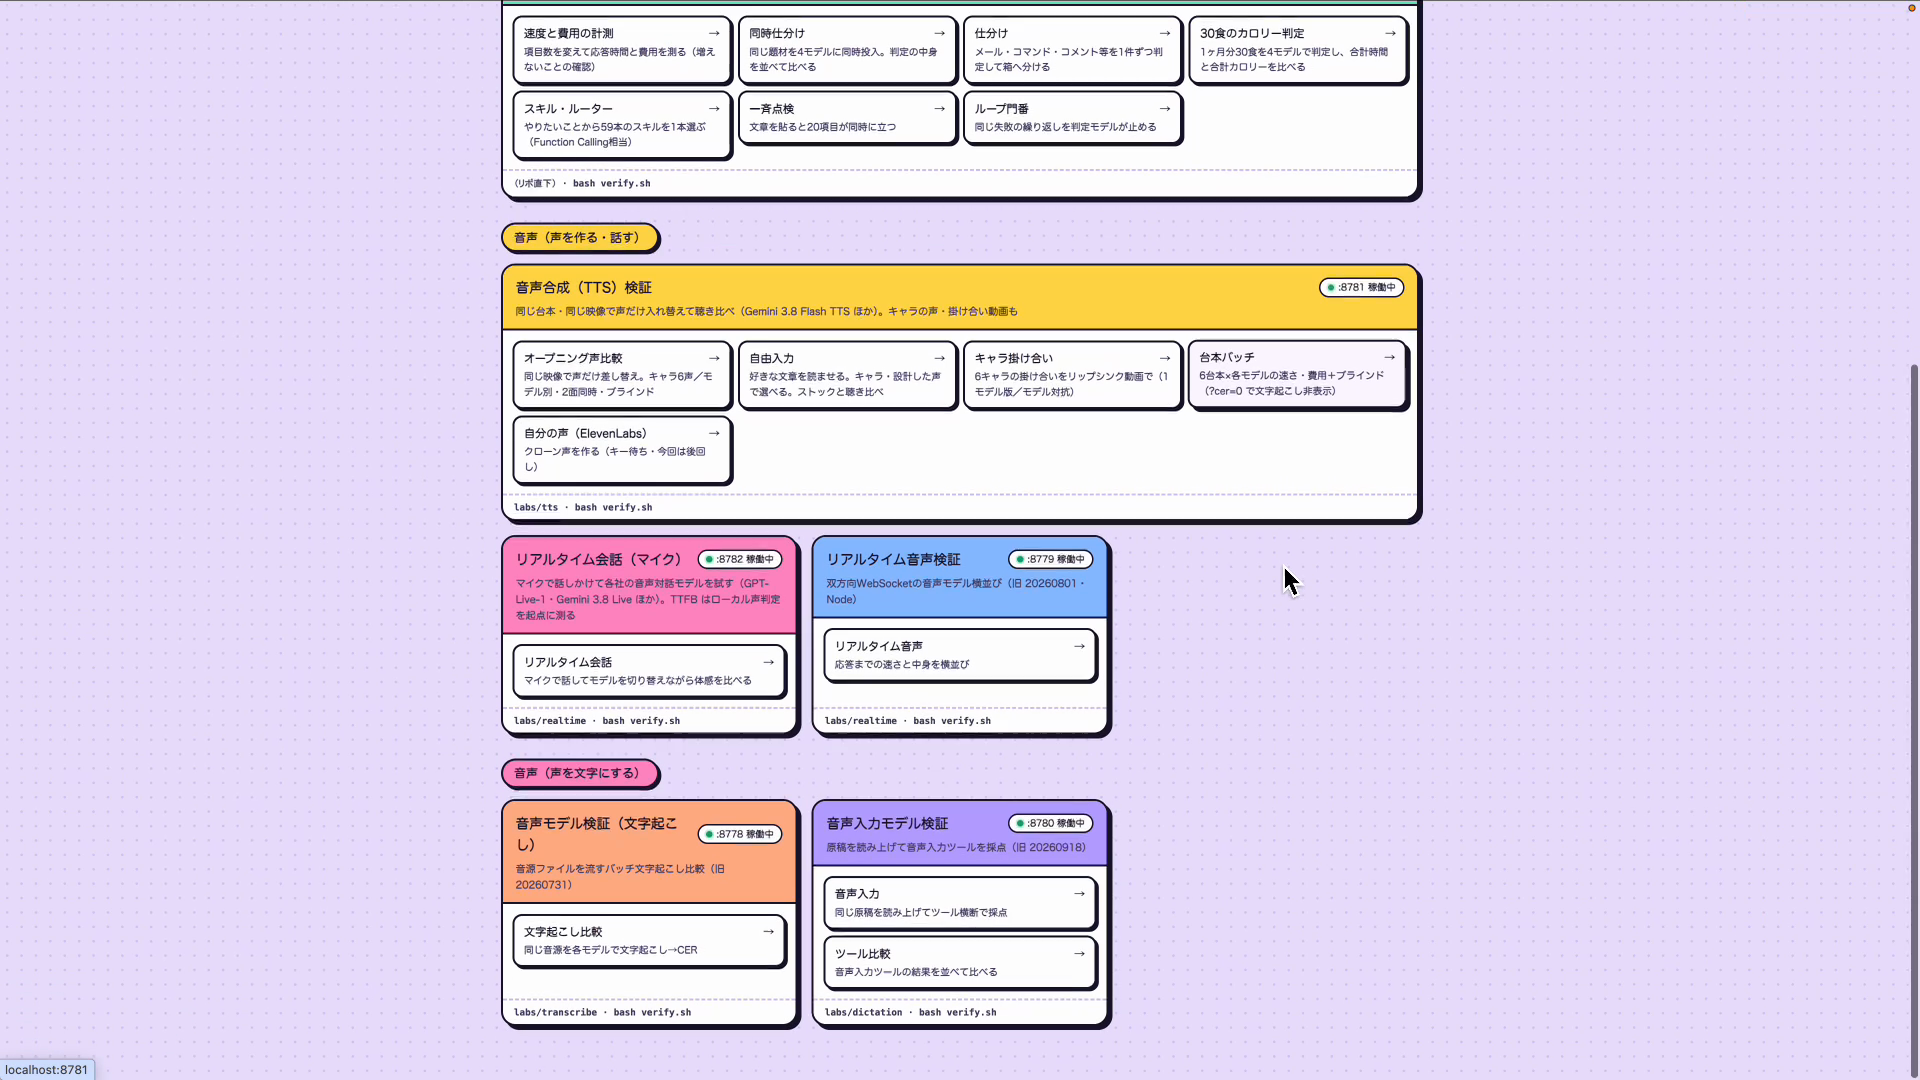
ここからは、僕が普段から使っている自作の検証ダッシュボードで聞き比べた結果です。Gemini 3.8 Flash TTS・Flash-Lite TTS・前の世代の3.1 Flash TTS・2.5系のGemini 2つ、OpenAIのGPT-4o mini TTSとTTS-1 HD、Fish Audio S2.1 Proの8モデルに、同じ台本を読ませました。
台本はニュース・感情・英日混在・長文・掛け合いなどです。数字で測れるところは数字で比べ、最後は耳で判断しました。
ニュースの読み上げ|日付・数字・英字も自然
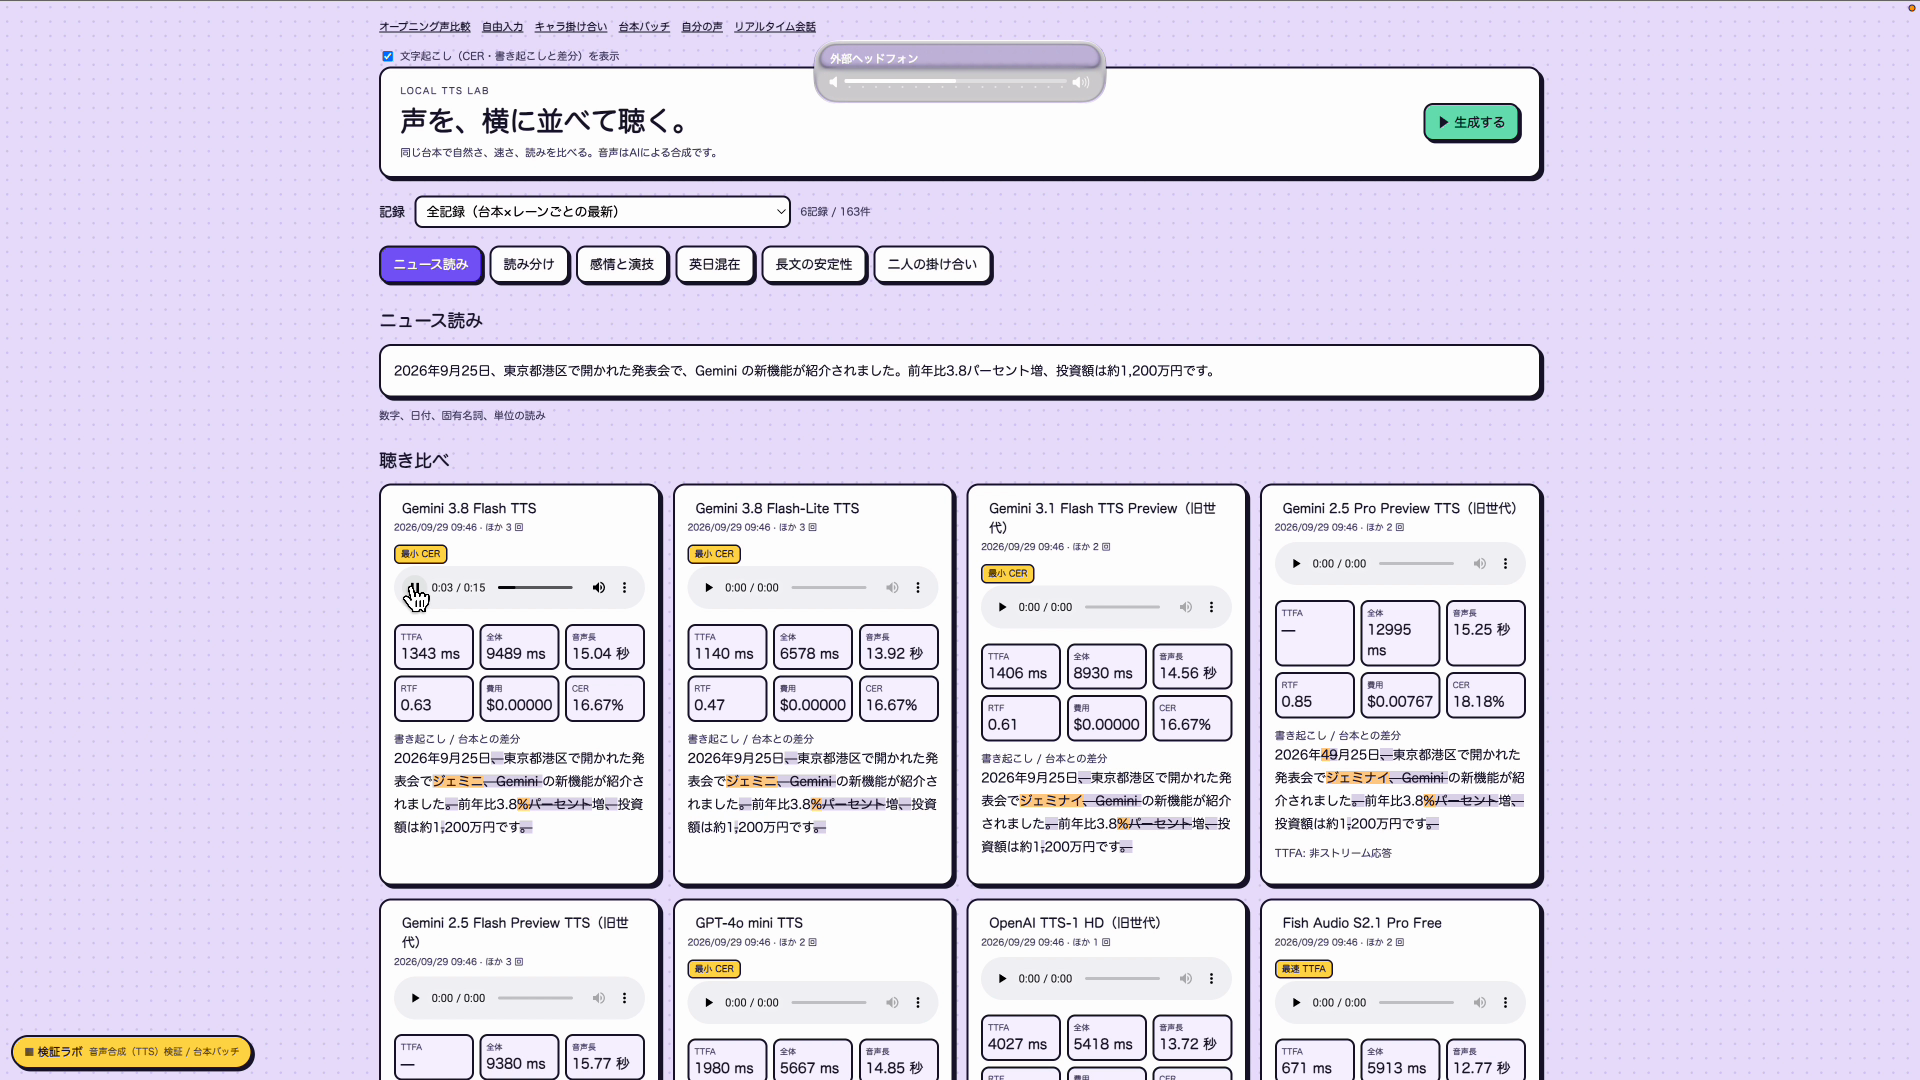
日付や数字、金額が1文に詰まったニュース原稿でも、Gemini 3.8 Flash TTSはつかえずにアナウンサーのように読み上げました。数字や英字の混ざった文は、AI音声が苦手としてきた部分です。前の世代の2.5 Pro Preview TTSは抑揚が少なめで、GPT-4o mini TTSは少しAIっぽさが残りました。
感情の台本|喜びから失敗への切り替え
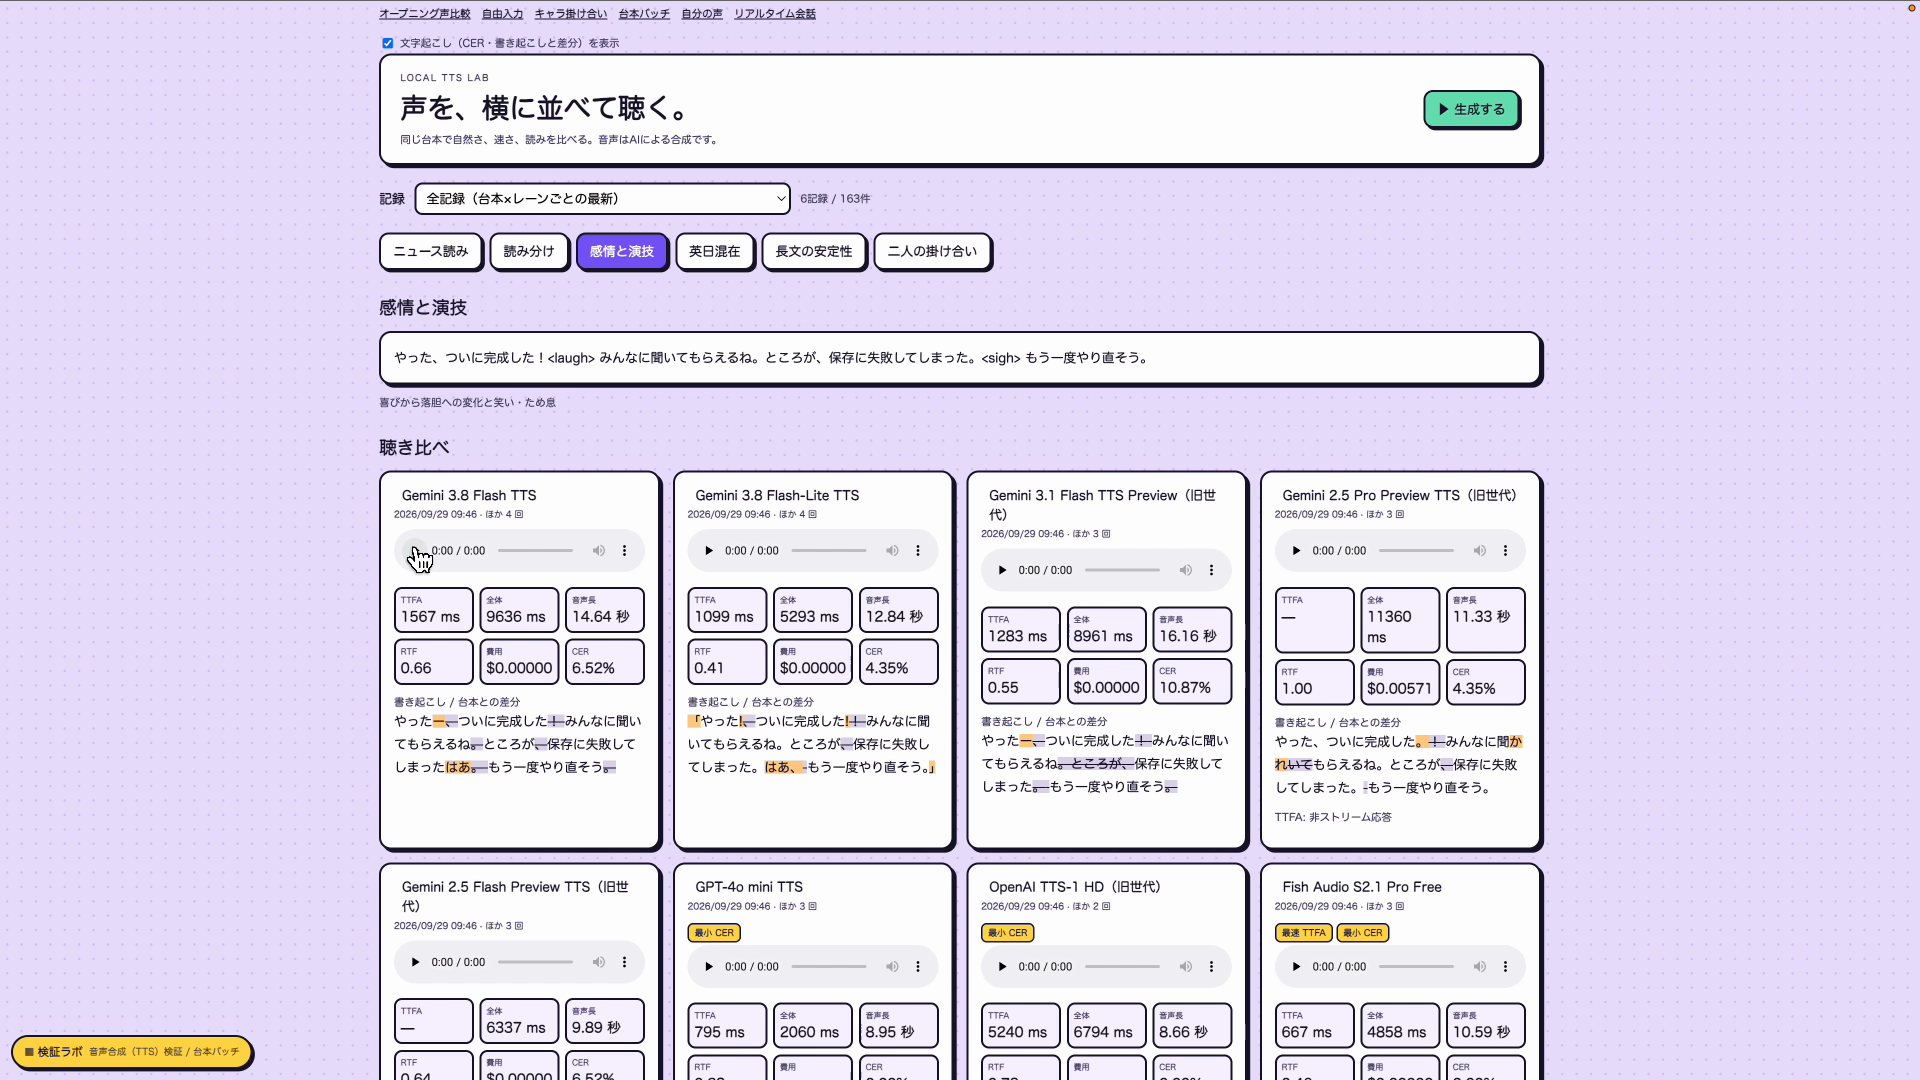
「やったー、ついに完成した!」から「ところが保存に失敗してしまった」へ気持ちが急に変わる台本では、Gemini 3.8 Flash TTSは人が演じているように切り替えました。GPT-4o mini TTSは完全にAIが読んでいる印象で、Fish Audioは文の切れ目をつなげて読みがちです。前の世代の3.1 Flash TTSは、4回中2回で途中のセリフが抜けました。
英語と日本語が混ざった文章|略語が続いても読み切れるか
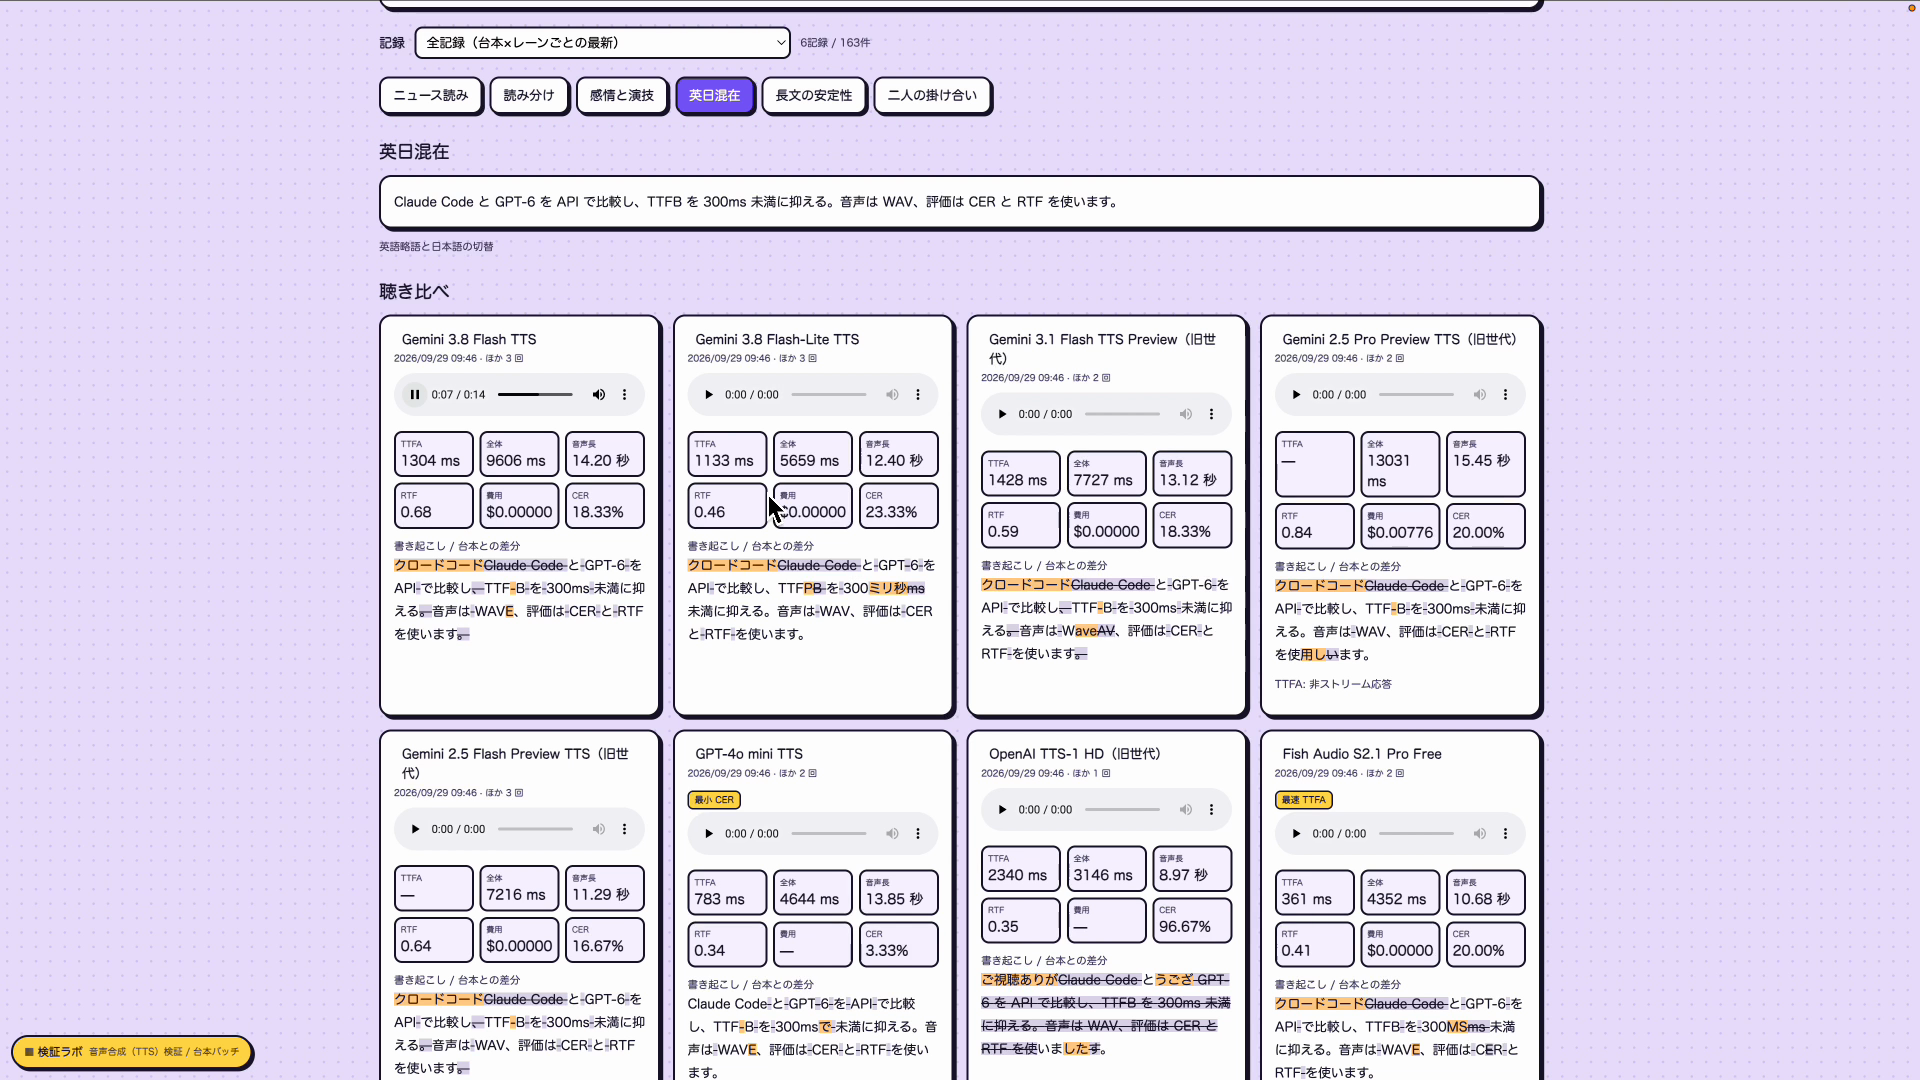
いちばん差が出たのが、Claude Code・GPT-6・API・TTFB・WAVのような英単語や略語が続く文章です。Gemini 3.8 Flash TTSは最後まで自然に読み上げた一方、旧モデルのOpenAIの音声は英語の部分がうまく読めず、Fish Audioも略語の読み方が怪しいところがありました。台本を選ばず安定して読めるのが、Gemini 3.8 Flash TTSの強みです。
長文の読み切りと、最初の音が出るまでの時間
数字で差がはっきり出たのが長文です。約300字の台本を読ませると、前の世代の3.1 Flash TTSは17秒前後で読むのをやめてしまい、3回試して3回とも途中で打ち切られました。Gemini 3.8 Flash TTSは54〜56秒かけて最後まで読み切り、4回中4回とも安定しています。
もうひとつ測ったのが、生成を頼んでから最初の音が出るまでの時間です。各モデル12回ずつの中央値で比べると、最も速かったのはFish Audioの0.47秒で、Gemini 3.8 Flash TTSは1.60秒でした。
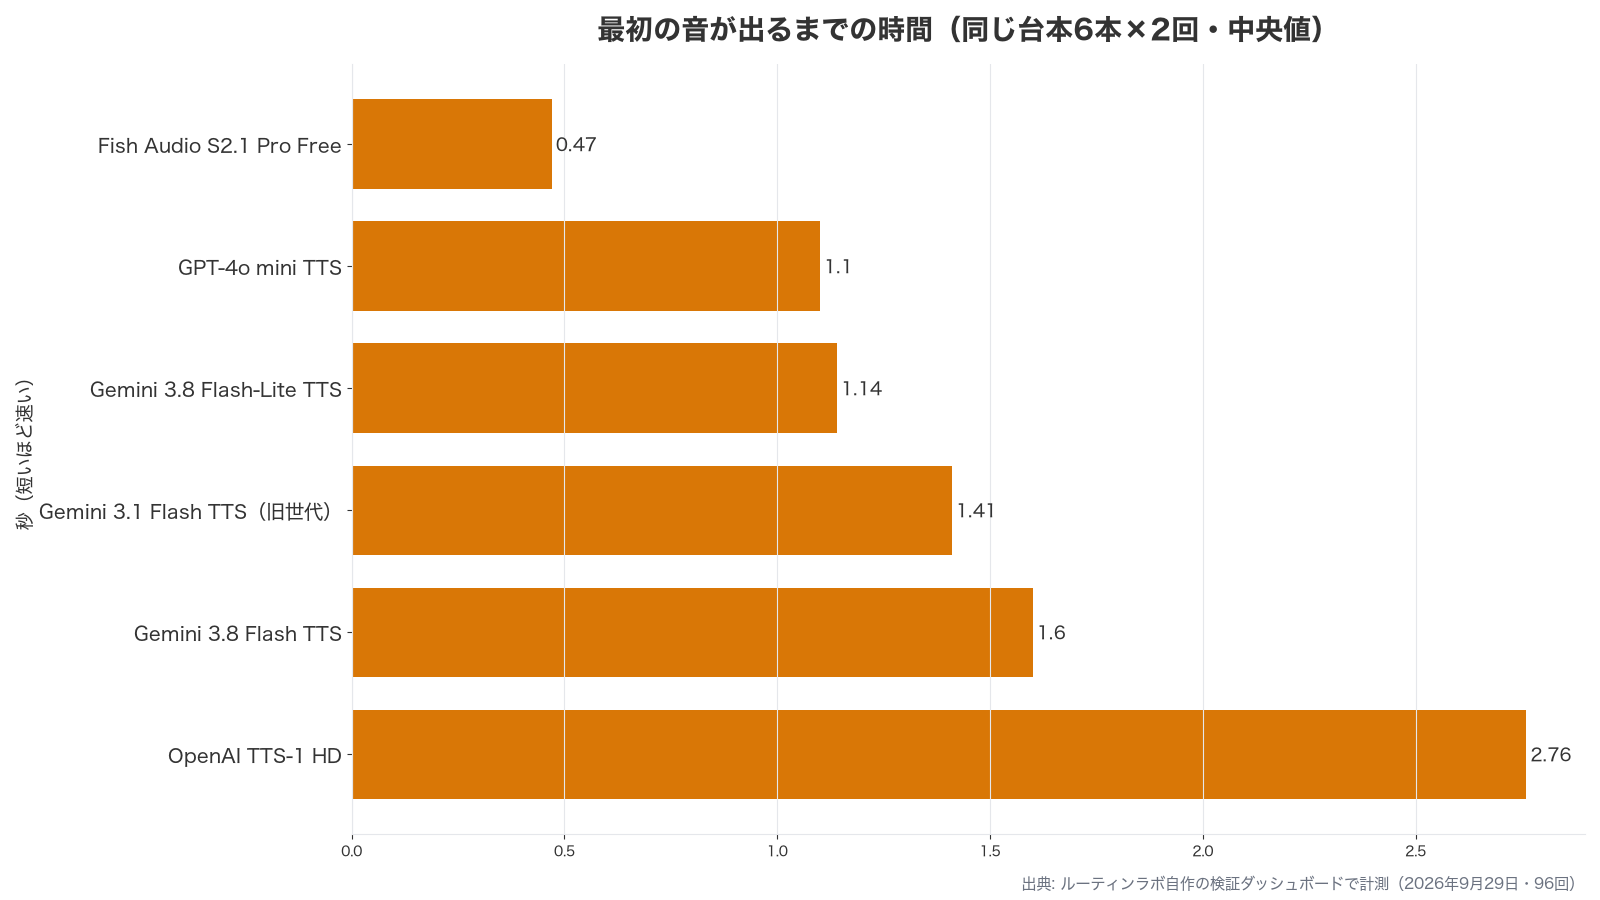
| モデル | 最初の音まで(中央値) | 長文(約300字) | 聞いた印象 |
|---|---|---|---|
| Gemini 3.8 Flash TTS | 1.60秒 | 4回中4回読み切り | 感情の切り替えも英日混在も自然 |
| Gemini 3.8 Flash-Lite TTS | 1.14秒 | — | Geminiの中ではいちばん速い |
| Gemini 3.1 Flash TTS(前の世代) | 1.41秒 | 3回中3回、17秒前後で打ち切り | 感情の台本で4回中2回セリフが抜けた |
| GPT-4o mini TTS | 1.10秒 | — | 読みは正しいがAIっぽさが残る |
| Fish Audio S2.1 Pro | 0.47秒 | — | いちばん速いが、文をつなげて読みがち |
| OpenAI TTS-1 HD | 2.76秒 | — | 最初の音まで最も時間がかかった |
※自分で測った値(2026年9月29日・ルーティンラボの検証ダッシュボード)。長文の欄は打ち切りが起きた3.1と3.8 Flashだけを掲載。2.5系は最初の音までを測れないため除外。
Gemini 3.8 Flash TTSは最初の音の速さでは真ん中より後ろですが、音声ファイルを作る使い方ならこの程度の差は気になりません。速さが大事な会話の用途は、Liveの担当と考えるのがよさそうです。
6モデルの掛け合い「モデル対抗」で聞き比べる
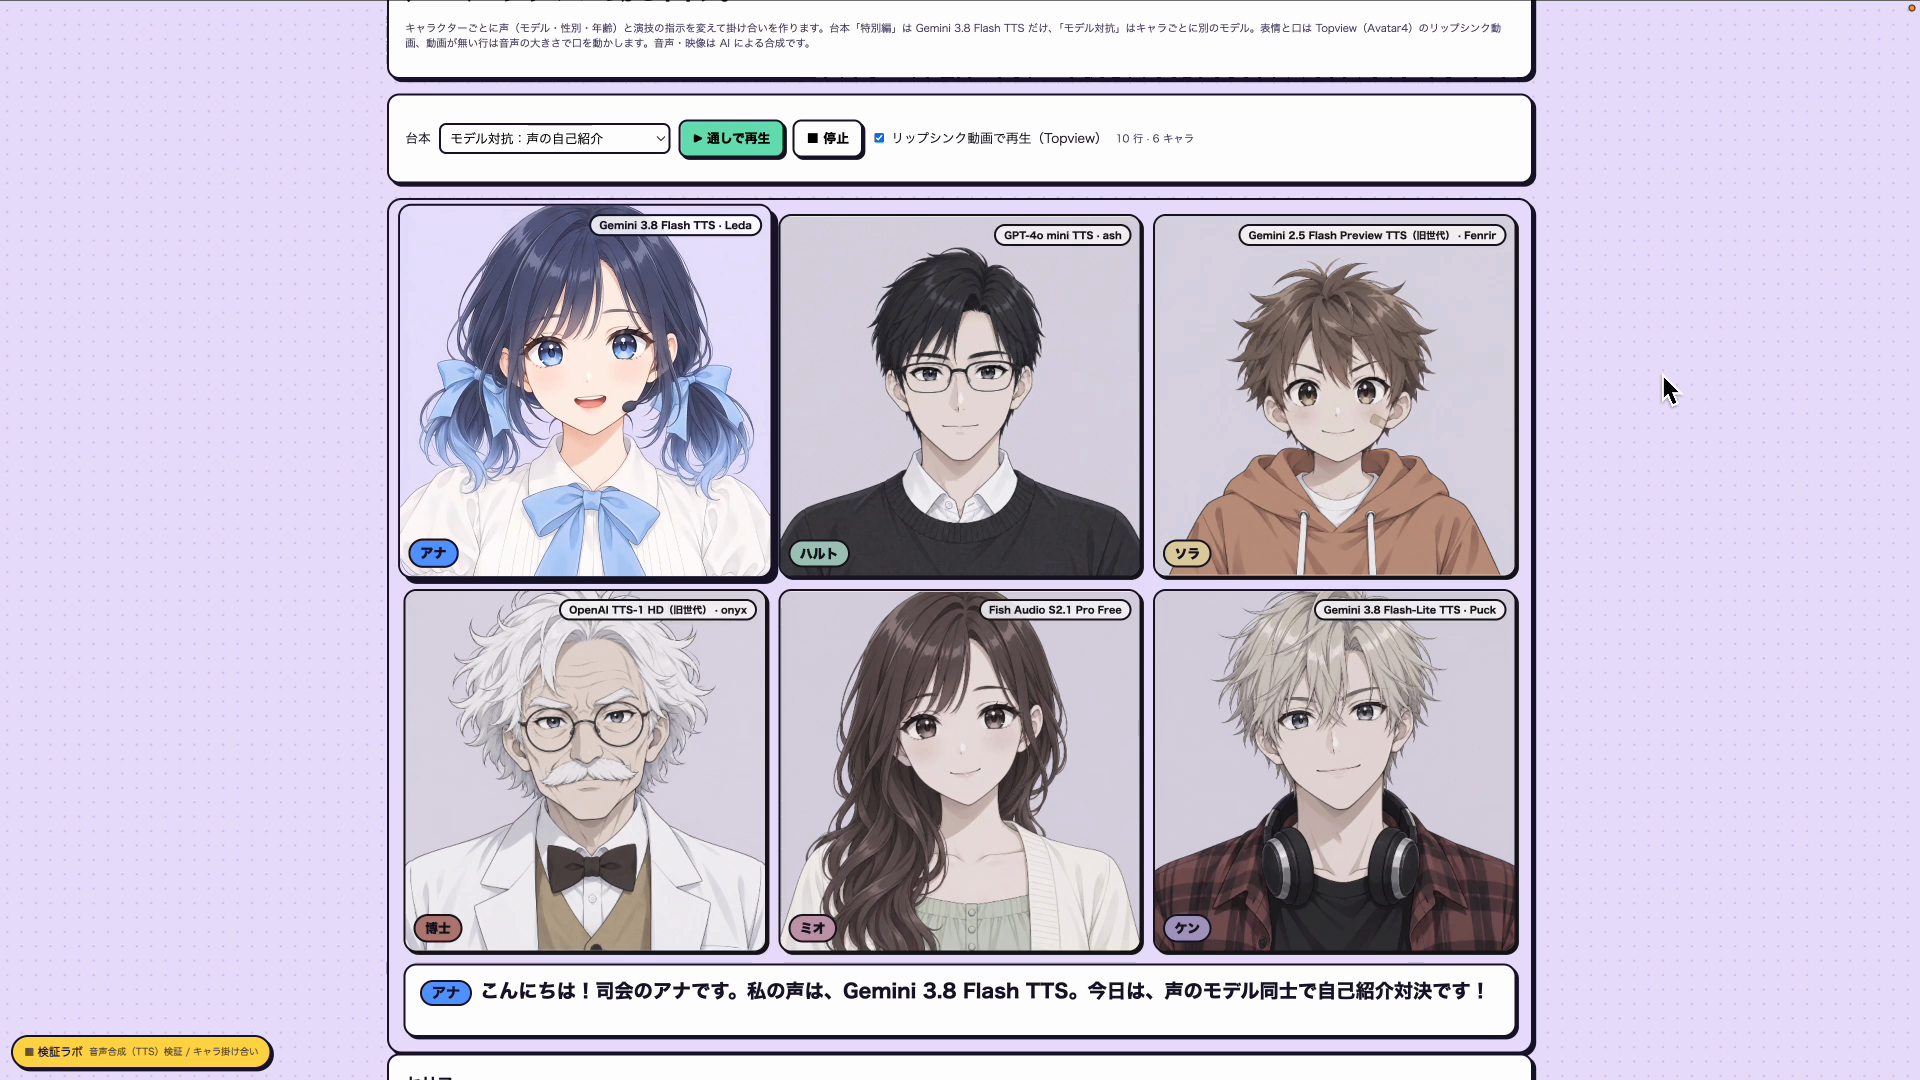
最後は、キャラクターごとに別のモデルを割り当てて掛け合いをさせた「モデル対抗」です。司会のアナがGemini 3.8 Flash TTS、DJのケンがFlash-Lite TTSを担当し、ほかにGPT-4o mini TTS、TTS-1 HD、Fish Audio、前の世代のGeminiが1人ずつ自己紹介をしていきます。
モデルが変わると声も話し方もここまで違うのかと驚くはずで、掛け合いの中で聞くとGemini 3.8 Flash TTSの自然さがいっそう際立ちます。Fish Audioの使い方は音声合成AI「Fish Audio AI」を徹底解説で紹介しています。
Gemini 3.8 Liveのリアルタイム会話|割り込んでも話題が自然に切り替わった
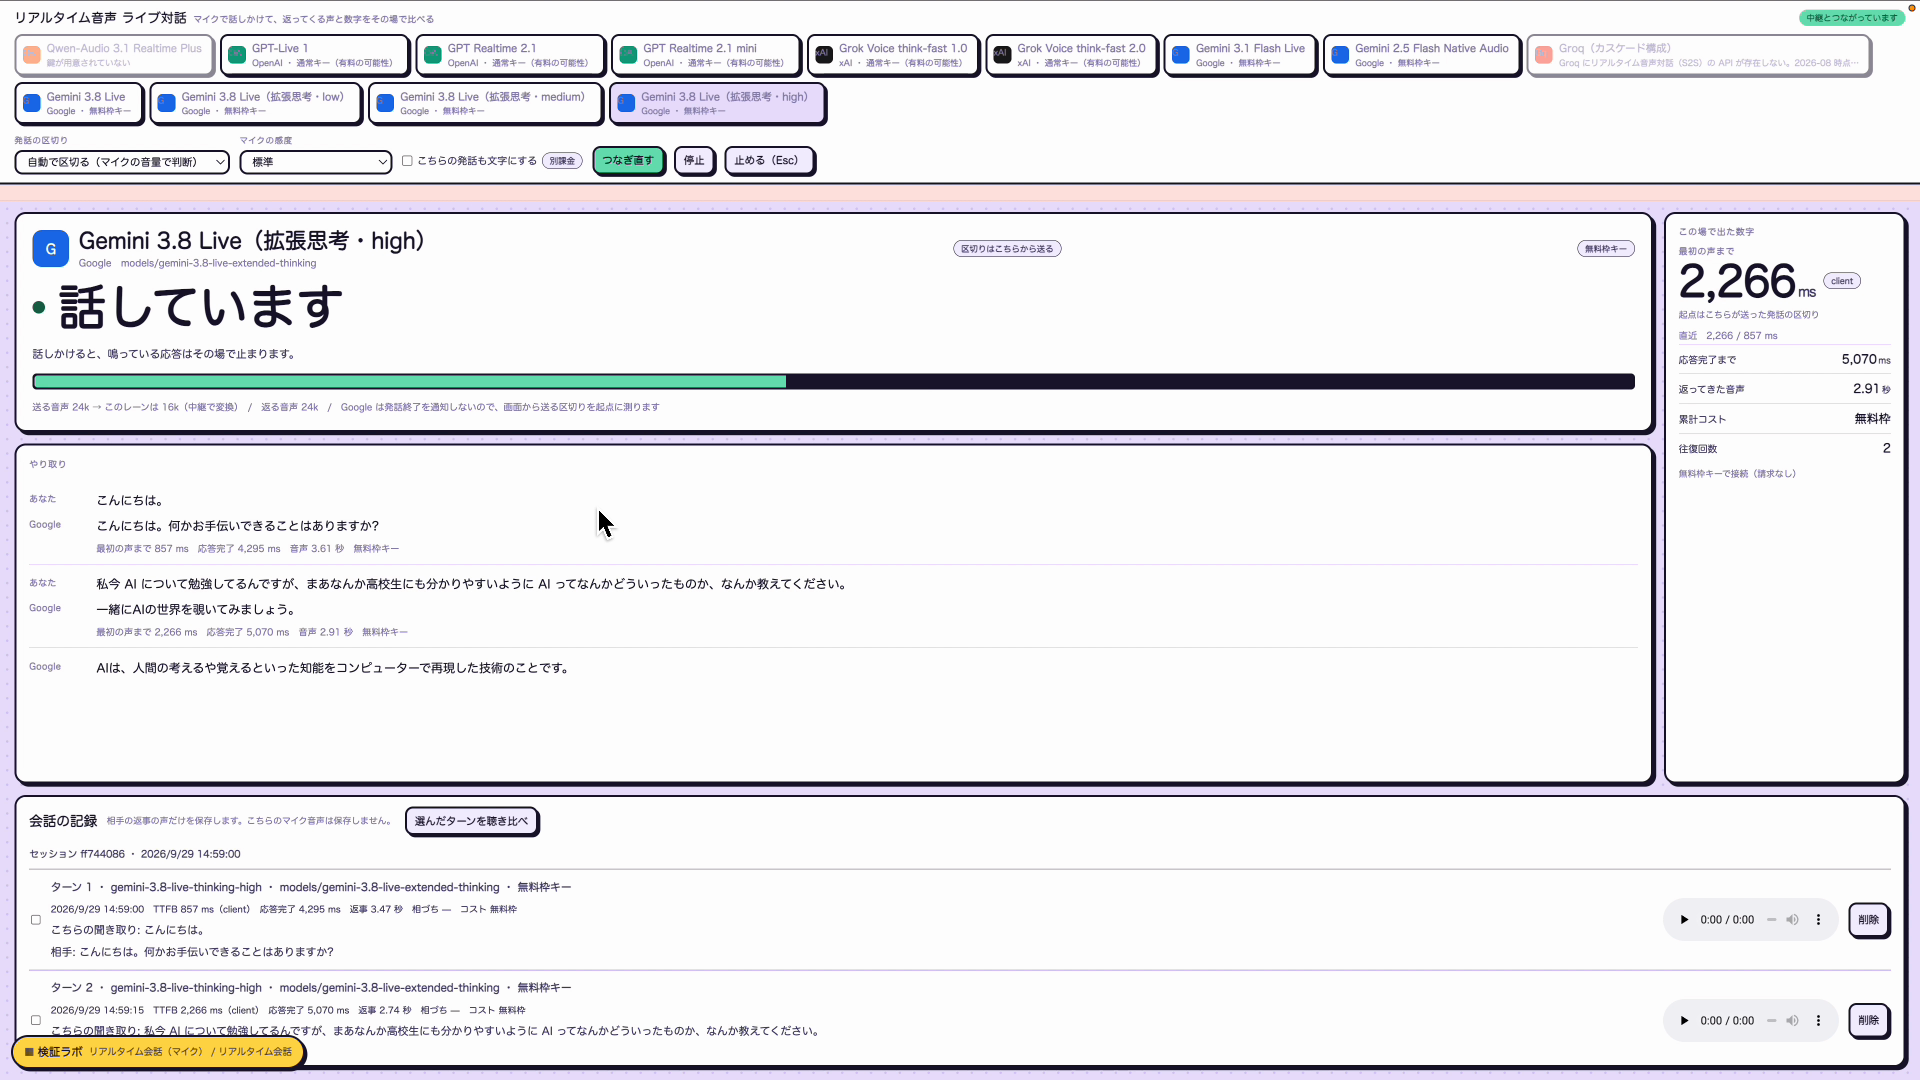
TTSとあわせて、リアルタイムで会話するGemini 3.8 Liveも試しました。自作の検証ラボのリアルタイム会話ページで、いちばん品質の高いモデルを選び、「高校生でも分かりやすいように、AIってどういったものか教えてください」と話しかけてみます。
Gemini 3.8 Liveはまず「一緒にAIの世界を覗いてみましょう」とひと言返しました。そのうえで、AIは人間の考える・覚えるといった知能をコンピューターで再現した技術だと、スマホの顔認証やおすすめ動画の例を交えて説明してくれました。
賢いと感じたのは、この最初のひと言です。答えを用意する間に黙ると会話が不自然になるので、ワンクッション置いてから本題に入っているように見えました。おかげで待たされている感じがしません。
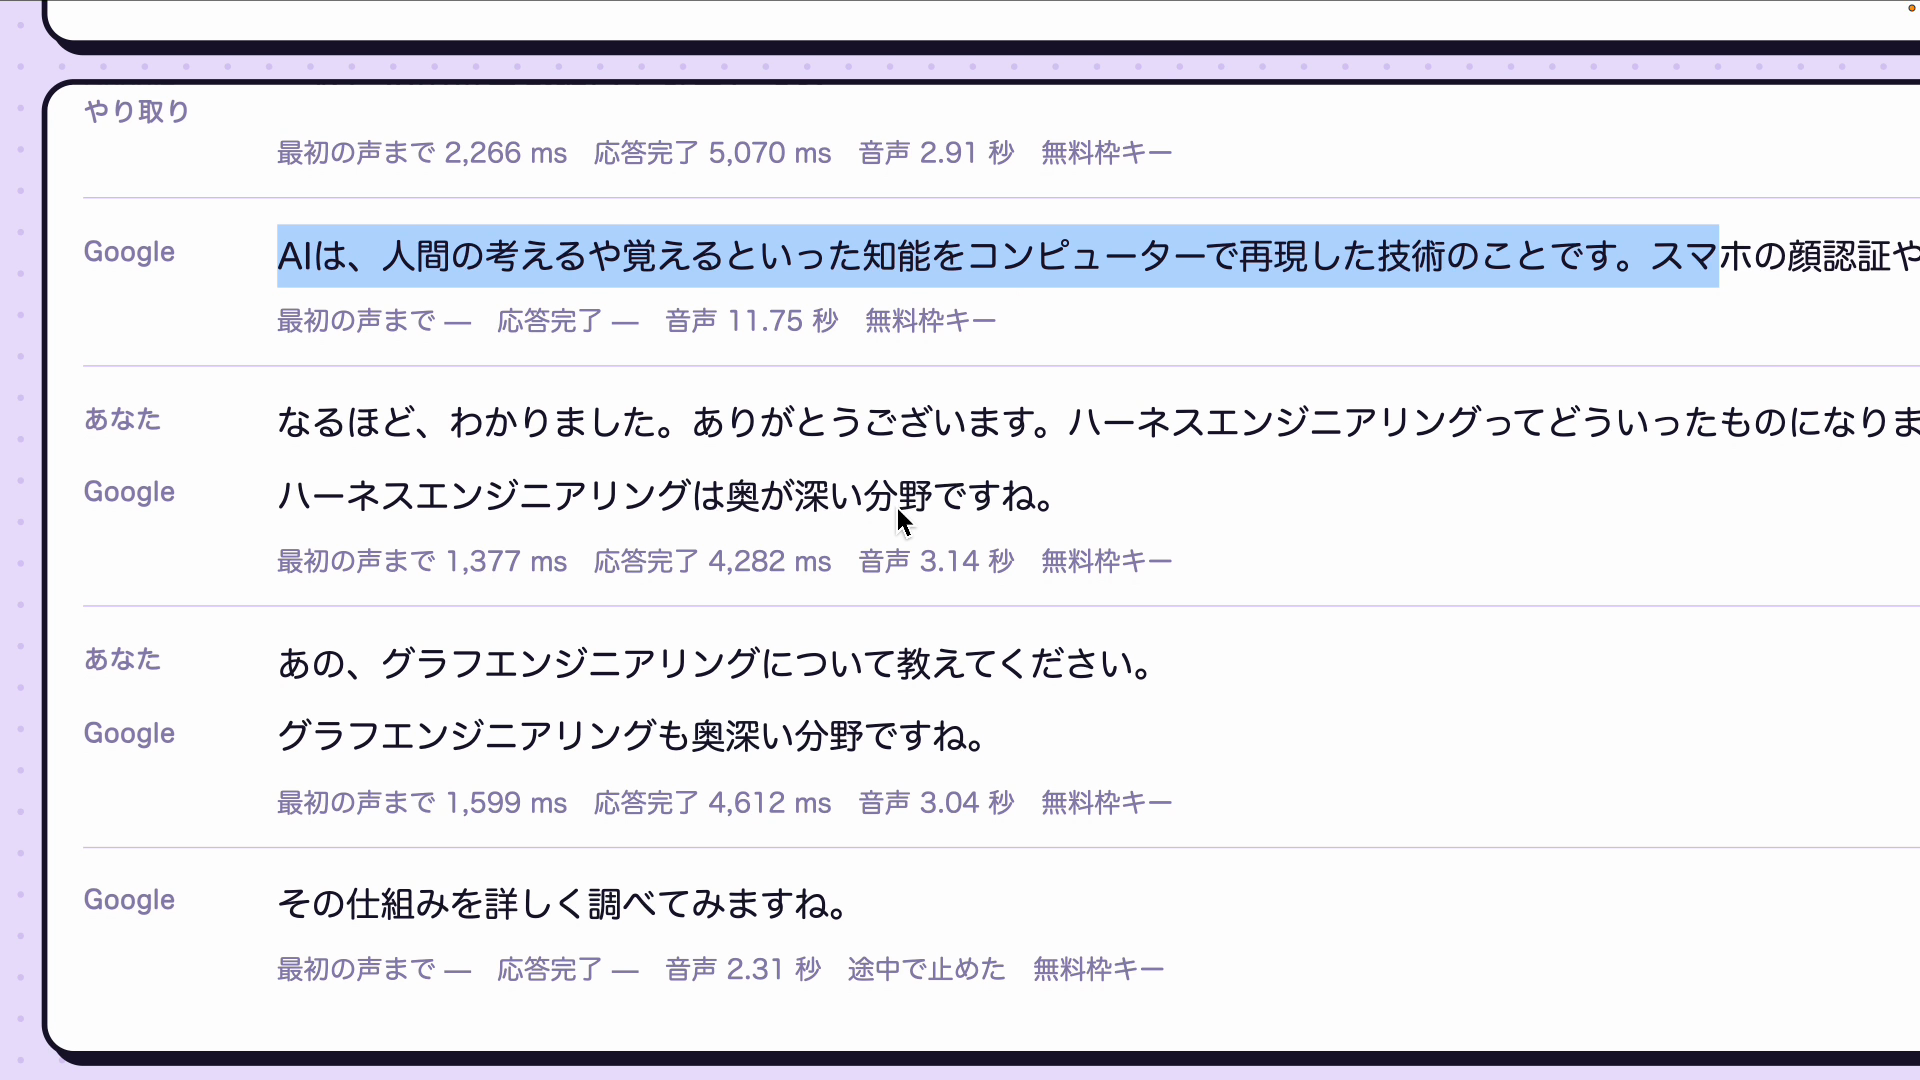
さらに、ハーネスエンジニアリングについて答えている途中で声をかぶせ、「グラフエンジニアリングについて教えてください」と割り込んでみました。すると前の話をすっと切り上げて、次の話題に自然に切り替わります。割り込みに強いので、会話のテンポが崩れません。
個人的には、ChatGPTのリアルタイム音声の最新モデルよりも、Gemini 3.8 Liveのほうが自然に使えると感じました。アプリ開発でアバターと声でやり取りする仕組みを作りたい方には、かなり使えるモデルです。
リアルタイム音声AIどうしの比較は、リアルタイム音声AIを実機比較|GPT・Grok Voice・Geminiのどれが自然に喋るかでも詳しく試しています。
-
-
リアルタイム音声AIを実機比較|GPT・Grok Voice・Geminiのどれが自然に喋るか
続きを見る
Gemini 3.8 Flash TTSが向く仕事・向かない仕事と注意点
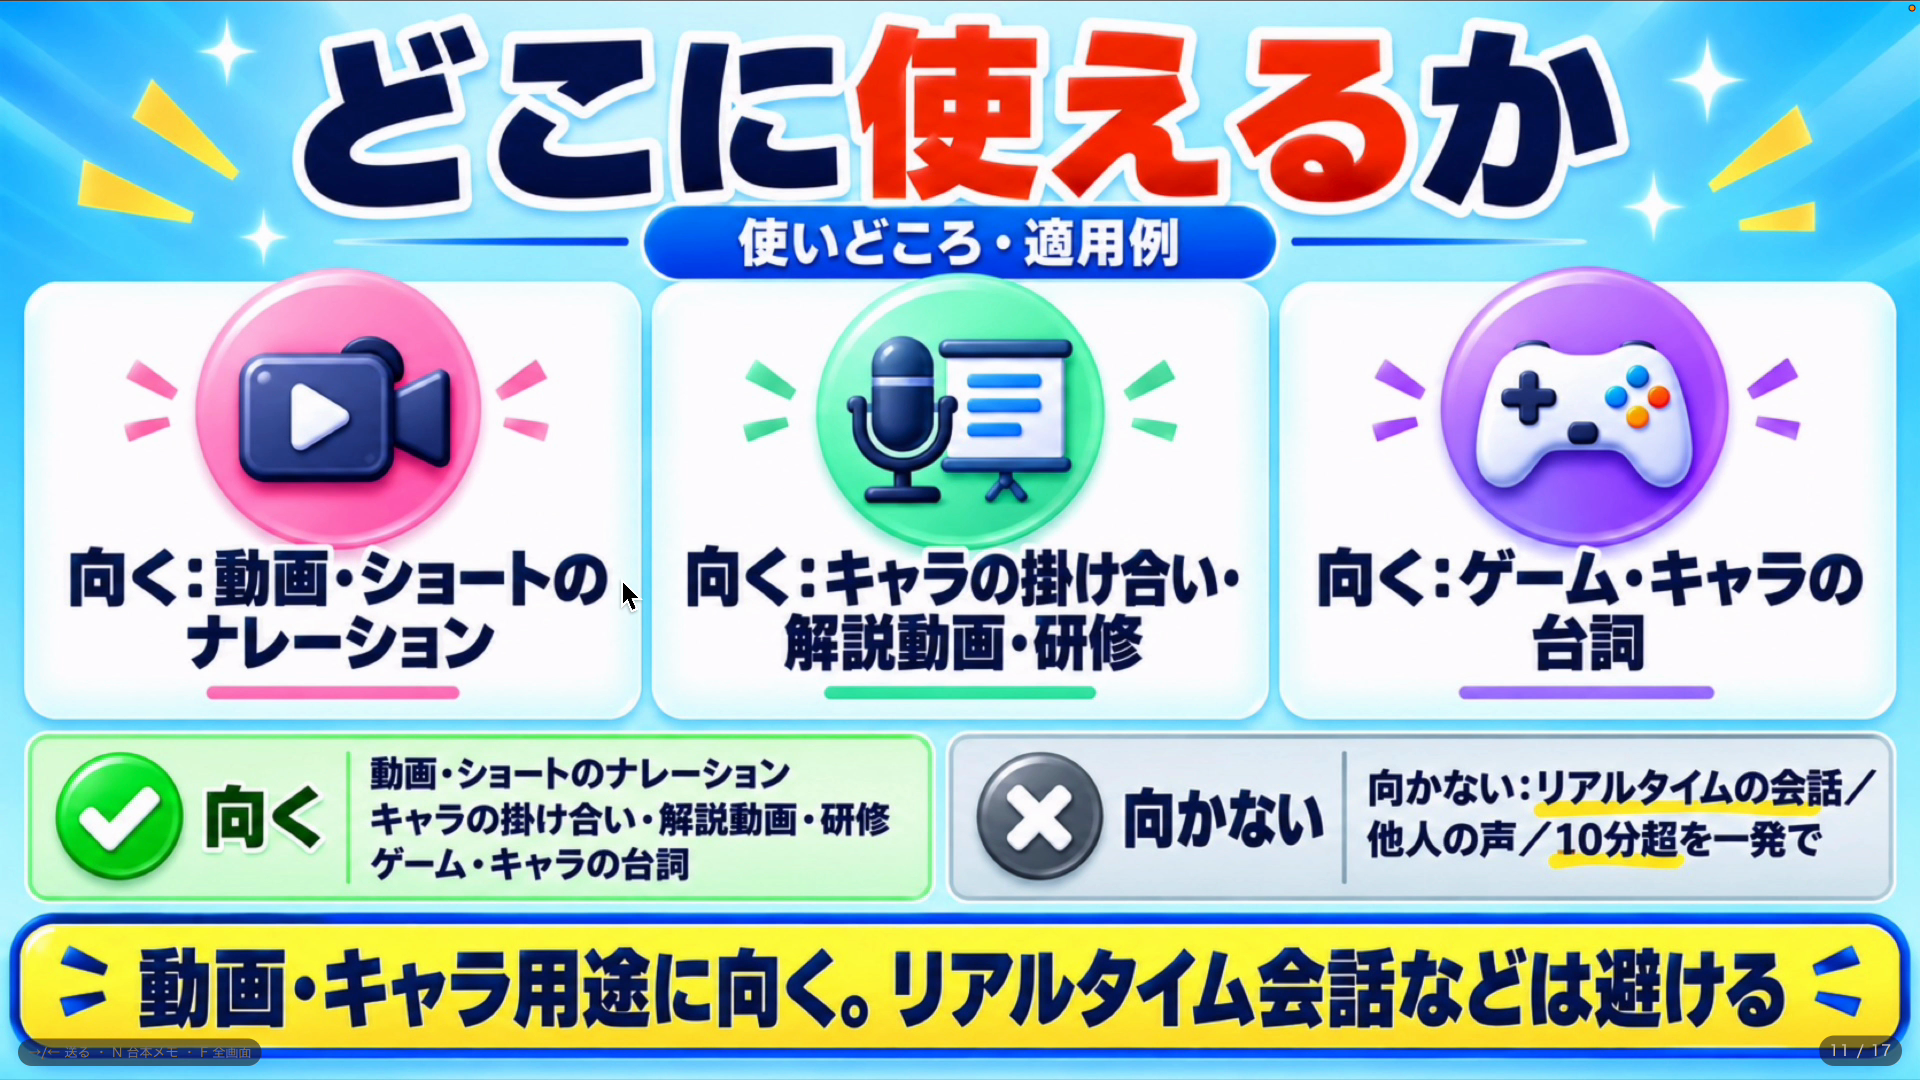
ここまでの検証をふまえて、Gemini 3.8 Flash TTSが向く仕事と向かない仕事を整理します。ひと言でいえば、「言わせたいセリフが決まっているコンテンツ」に強いモデルです。
| 仕事 | 向き・不向き | 理由 |
|---|---|---|
| 動画・ショートのナレーション | 向く | 台本どおりに読み、感情や間も自然 |
| キャラクターの掛け合い | 向く | 1つのモデルで声を選び分けて、複数のキャラを演じられる |
| ゲーム・シミュレーターの台本やセリフ | 向く | 英単語や数字が混ざっても安定して読める |
| 長い音声を毎日大量に作る | 注意 | 1本は安いが費用が積み上がる。2027年1月から単価が倍 |
| リアルタイムの会話・音声アシスタント | 向かない | 会話はGemini 3.8 Liveの担当 |
声が本当にリアルなので、使うときは注意も必要です。声の複製は必ず本人の声だけにして、人をだますなりすましには絶対に使わないでください。Googleの生成AIの利用ポリシーでも禁止されています。
また、Gemini 3.8 Flash TTSで作った音声にはすべて「SynthID」という電子透かしが入っています(Google公式ブログ・2026年9月時点)。AIで作った音声だと後から確かめられる仕組みです。
まとめ
Gemini 3.8 Flash TTSの要点をまとめます。
- 台本の読み上げ専用。1つのモデルで6人のキャラの声を演じ分けられる
- 音声の出力は100万トークンあたり9ドル(実測1分約1.7セント)。2027年1月から倍
- 日本語の聞き比べで1位(2026年9月29日時点)。英語の総合はEleven v4が1位
- Google AI StudioのVoice Designで、文章から声を作れる
- 感情・英日混在・長文も安定。会話はGemini 3.8 Liveの担当
まずはGoogle AI Studioで用意された声を聞いて、気に入ったらVoice Designで自分だけの声を作ってみてください。ナレーションやキャラの掛け合いを作りたい方なら、1つのモデルでの演じ分けにきっと驚くはずです。
今回はモデルの紹介にとどめましたが、音声を使ったコンテンツの作り方は、YouTubeメンバーシップのスタンダードAIプランやビジネスAIプラン、限定のDiscordコミュニティで共有していきます。最新のAI情報や活用事例は、公式LINEでも配信しています。

