本ページはプロモーションが含まれています。
この記事でわかること
- Qwen4 Maxの特徴と料金
- 日本から使う方法(OpenRouter・QwenCloud)
- Fable 5.2と13課題で比べた実力
- 安さの落とし穴と上手な使い分け
「僕が実際に間取り図1枚をQwen4 Maxに渡したら、約18分・約42円で、部屋12か所と窓6か所を全部正しく読んだ3Dの家が建ちました。ただ、ゲームの11題ではClaude Fable 5.2に1つも勝てませんでした」
結論から言うと、Qwen4 Maxは「安く広く試す」ためのモデルです。出力の単価はClaude Fable 5.2の約9分の1で、図面や画像を読んで形にする仕事は十分にこなせますが、細かい仕様まで守る長い作り込みはまだFable 5.2が上でした。2026年11月16日に正式版が出たので、僕の検証ラボでFable 5.2と同じ文面の13課題を流して比べています。
こんにちは、ルーティンラボ(@rutinelabo)です。本記事では、Qwen4 Maxとは何か、料金と日本から使う方法、Fable 5.2と13課題で比べた結果、そして安さの落とし穴と使い分けを、実測の数字つきで解説します。
この記事で紹介するAI検証ダッシュボード(同じお題を最大4つのAIに同時に出し、時間・トークン・費用を並べて記録できる道具)は、公式LINEで合言葉「Qwen4」と送ると受け取れます。
プロンプト配布中
LINE公式アカウントを友達追加していただければ、本記事やYouTubeで使用した使用したプロンプトを配布いたします。メンバーシップ登録で優先サポートも実施中です。
結論|Qwen4 MaxはFable 5.2に迫れる?安く広く試すならQwen4 Max
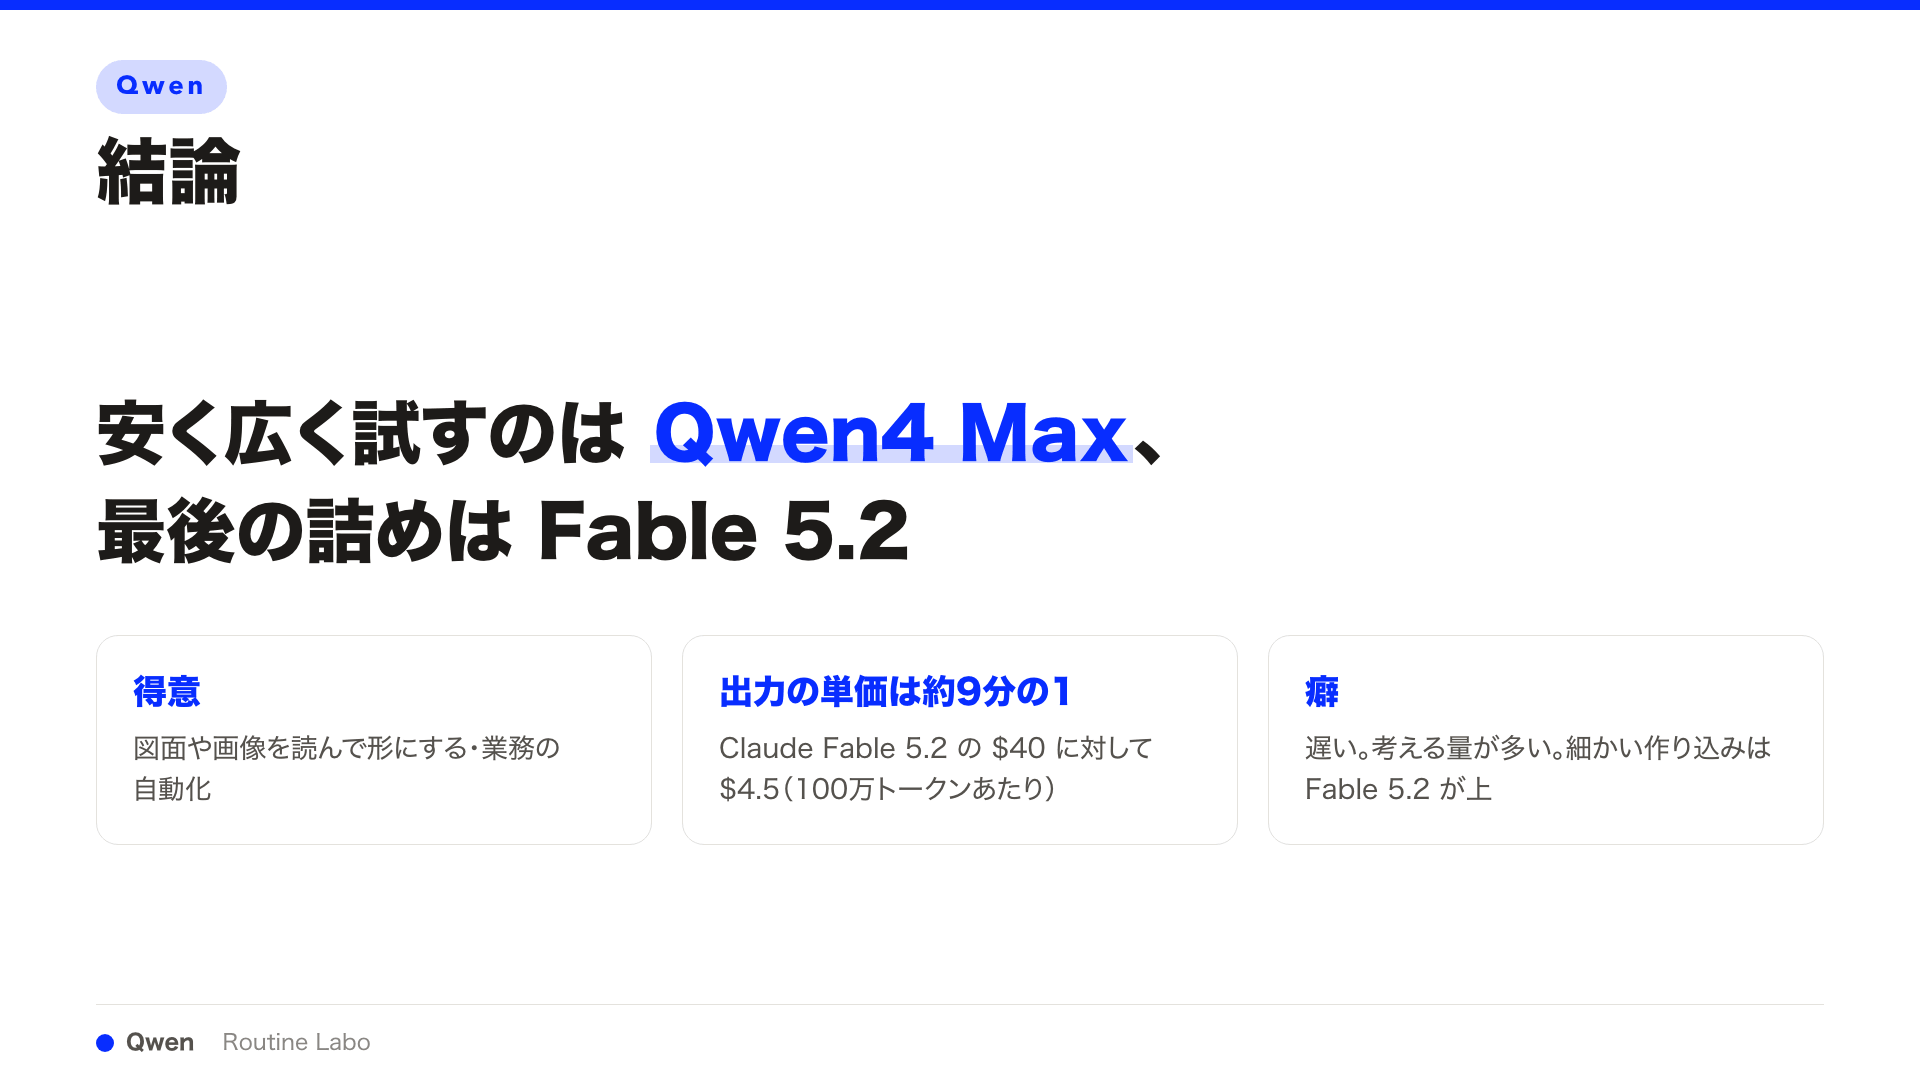
先にお伝えすると、Qwen4 MaxはまだClaude Fable 5.2に並ぶところまでは来ていません。同じ文面で作らせたゲーム11題はFable 5.2の7勝・引き分け3・判定できず1でした。第三者のArtificial Analysisの総合点も、Fable 5.2の65に対してQwen4 Maxは43です。
それでも、間取り図1枚から歩ける3Dの家を、部屋も窓も全部正しく読んで約42円で作り切ったのはQwen4 Maxです。図面や画像の読み取り、3Dや画面の試作は安いQwen4 Maxに任せ、細かい仕上げは今までどおりFable 5.2に回す、というのが僕の使い分けです。
| 見るところ | ポイント |
|---|---|
| どんなモデルか | Alibabaの新しい最上位。文字・画像・動画を読み、重みは非公開 |
| 料金(API) | 入力1.5ドル・出力4.5ドル(100万トークンあたり)。出力はFable 5.2の約9分の1 |
| 使える場所 | QwenCloudのAPI・OpenRouter・Token Plan(開発ツール向けの月額) |
| 実力 | 間取り図の読み取りは部屋12/12・窓6/6。ゲームの作り込みはFable 5.2が上 |
| 弱点 | 遅い・考える量が多い・データの置き場に注意 |
| 使い分け | 乗り換えずに、画像の読み取りと試作に足す |
Qwen4 Maxとは?|Alibabaの新しい最上位モデル
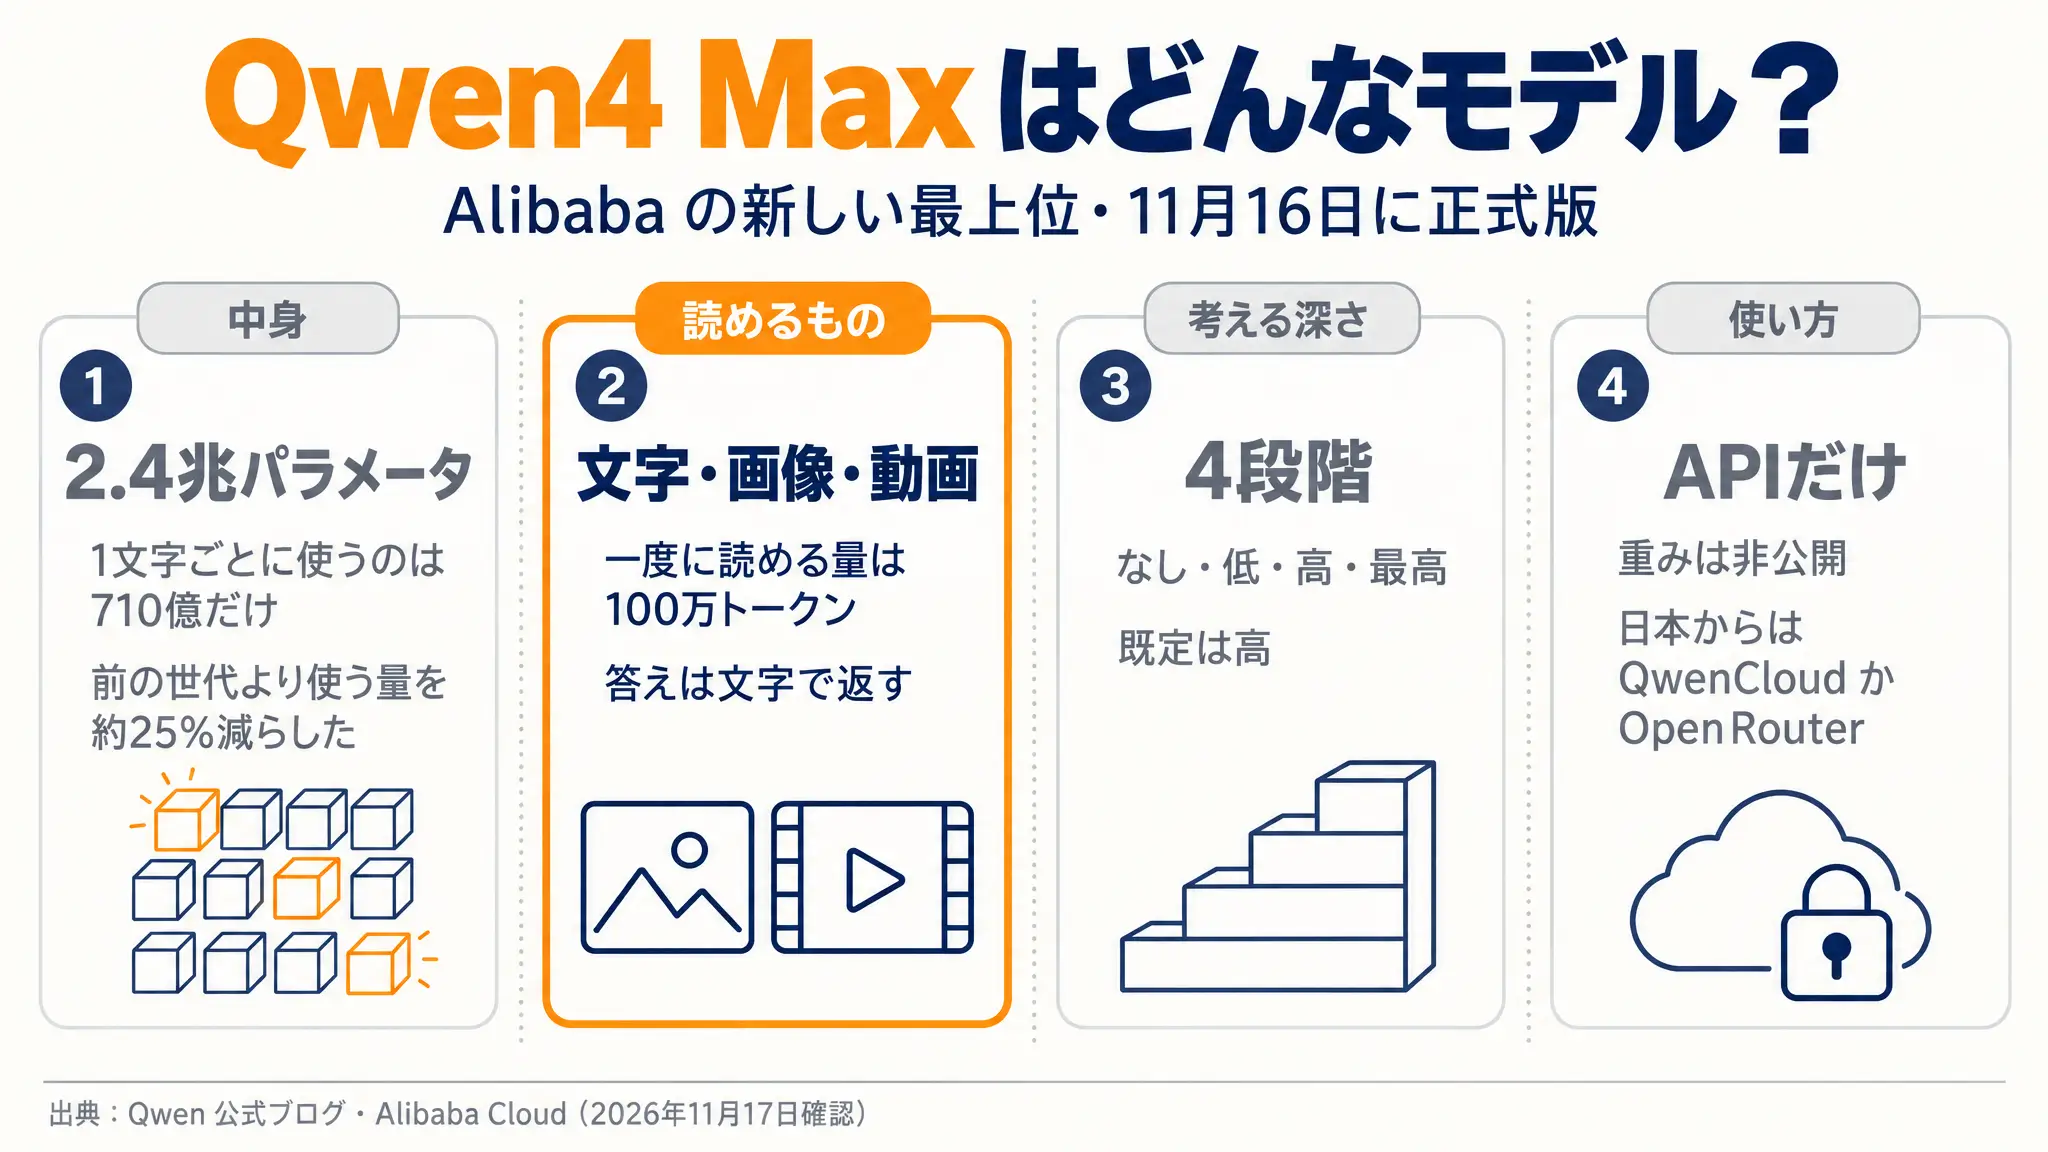
Qwen4 Max(正式名はQwen4-Max)は、中国のAlibabaが2026年11月16日(日本時間の昼11時)に正式版を出した大規模言語モデルです。Qwen4シリーズの最初のモデルで、いまは最上位のMaxだけが出ています。11月11日からのプレビュー版は、11月25日で終わる別物です。
中身は2.4兆パラメータのMoE(得意分野の違う専門家を切り替えて使う作り)で、1トークンごとに使うのは710億だけです。前の世代より使う量を約25%減らしながら性能を上げたと公式は説明しています。
| 項目 | Qwen4 Max |
|---|---|
| 中身 | 2.4兆パラメータ(1トークンごとに使うのは710億) |
| 読めるもの | 文字・画像・動画(音声は読めない・答えは文字) |
| 一度に読める量(コンテキスト) | 100万トークン |
| 最大出力 | 13万1,072トークン(考える分と答えの合計は26万2,144まで) |
| 考える深さ | なし・low・high(既定)・xhighの4段 |
(2026年11月時点・Qwen公式ブログ・Alibaba Cloud公式のモデルページ参照)
Qwenのモデルは手元で動かせる「オープンウェイト」で出ることが多く、僕も前の世代のQwen3.8 27Bをこちらの記事のように手元のパソコンで動かしています。ただ、Qwen4 Maxの重みは非公開で、使えるのはAPI経由だけです。小さいモデルは「オープンソースで出す予定」とだけ発表されています。
-
-
Qwen3.8 27Bをローカルで動かす|LM Studioの選び方と3Dゲームが作れた実力
続きを見る
Qwen4 Maxの使い方は?|日本からはOpenRouterかQwenCloudのAPI
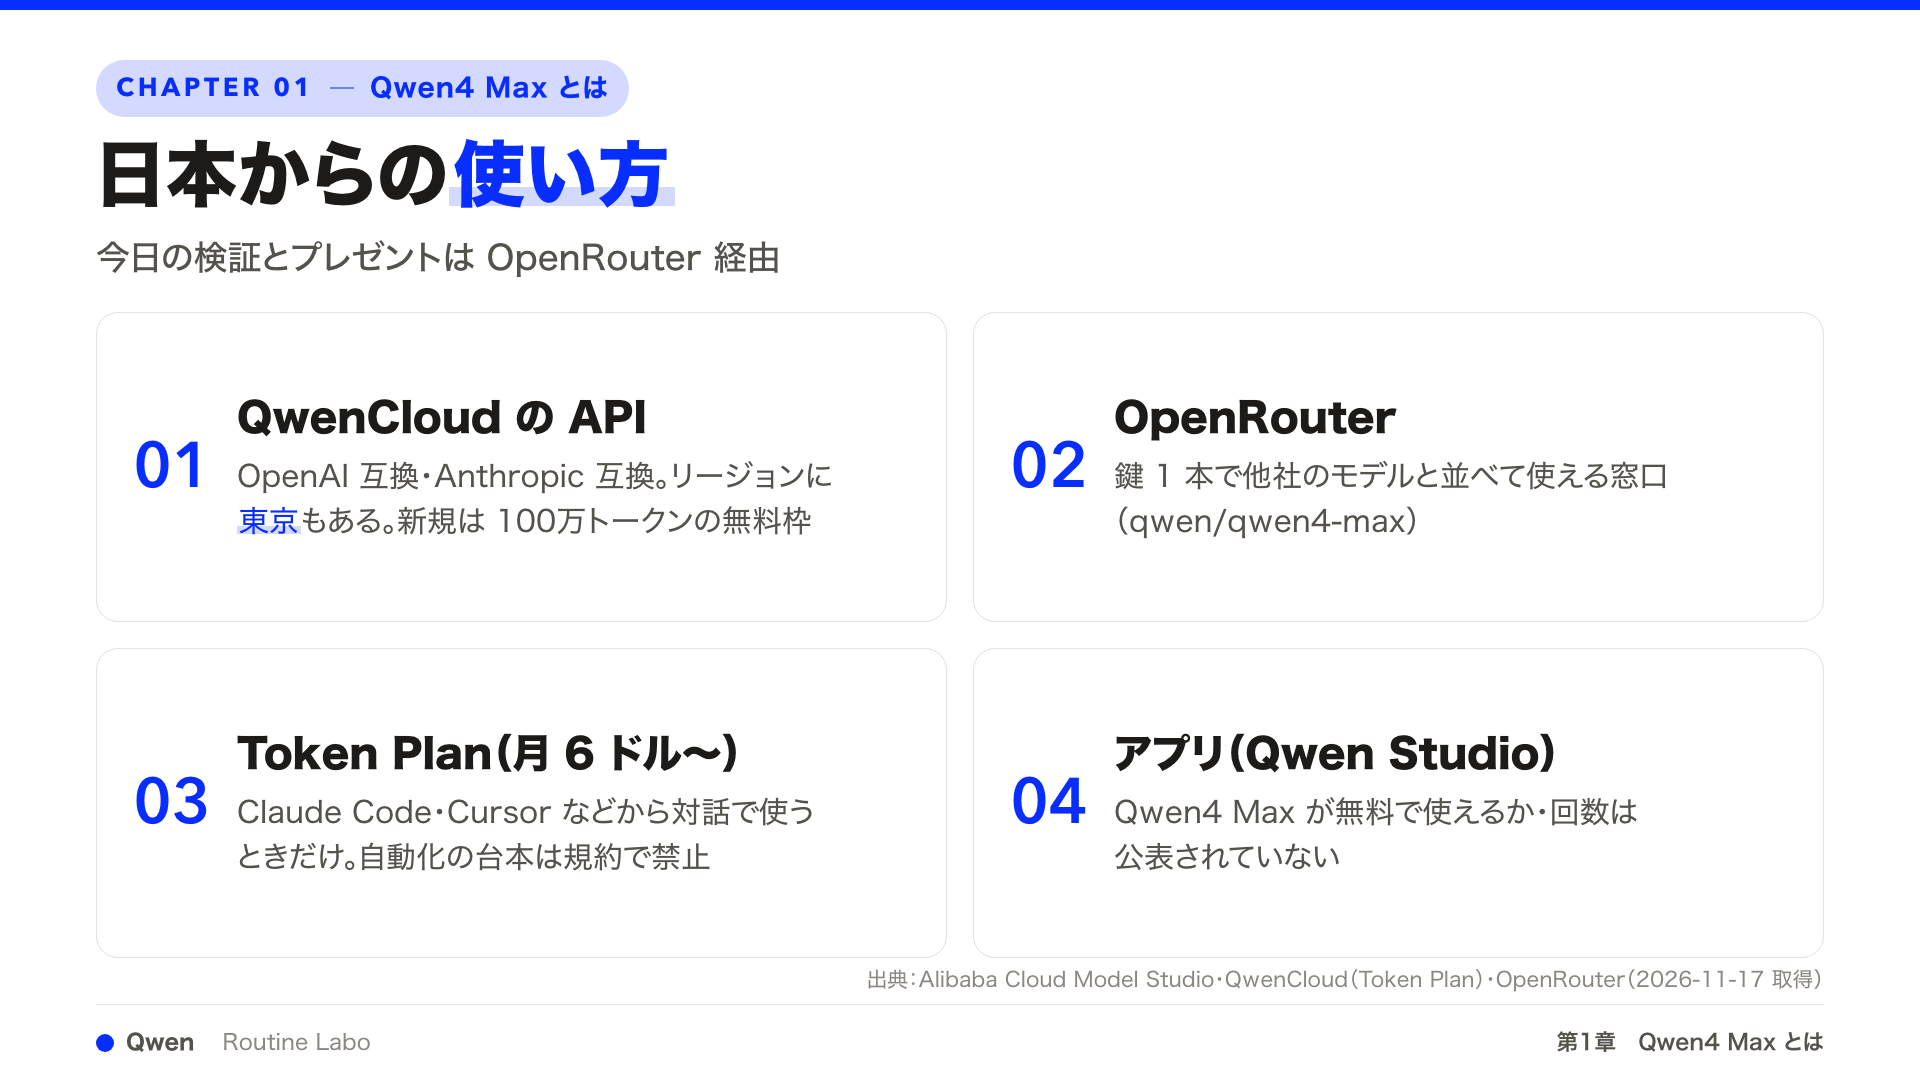
日本から使う主な入口は、AlibabaのQwenCloudでAPIの鍵を作るか、いろいろな会社のモデルを1本の鍵で呼べるOpenRouterを通すかの2つです。ほかに開発ツール向けの月額のToken Planと、アプリのQwen Studioもあります。僕は今回、ふだん使っているOpenRouterのモデル一覧で「qwen」と検索して呼びました。
| 使う場所 | 入口・料金 | メモ |
|---|---|---|
| QwenCloudのAPI | 従量課金(新規はシンガポールで100万トークン無料・90日) | OpenAI互換。東京のリージョンもある |
| OpenRouter | モデル名 qwen/qwen4-max | 公式より5%安い |
| Token Plan | 月6ドルから(新規は11月30日まで月3ドルから) | Claude CodeやCursorで対話して使うときだけ |
| Qwen Studio(アプリ) | 無料で使えるか・回数は非公開 | 旧Qwen Chat |
(2026年11月時点・QwenCloud公式・Token Planの説明・OpenRouter参照)
手軽なのはOpenRouterです。鍵を1本作って少し入金しておけば、Qwen4 MaxもClaudeもGeminiも同じ書き方で呼べます。プログラムから呼ぶときは、モデル名に次の文字を指定します。
qwen/qwen4-max
Qwen4 Maxの料金はいくら?|安いのは単価だけ、1題の値段で比べる
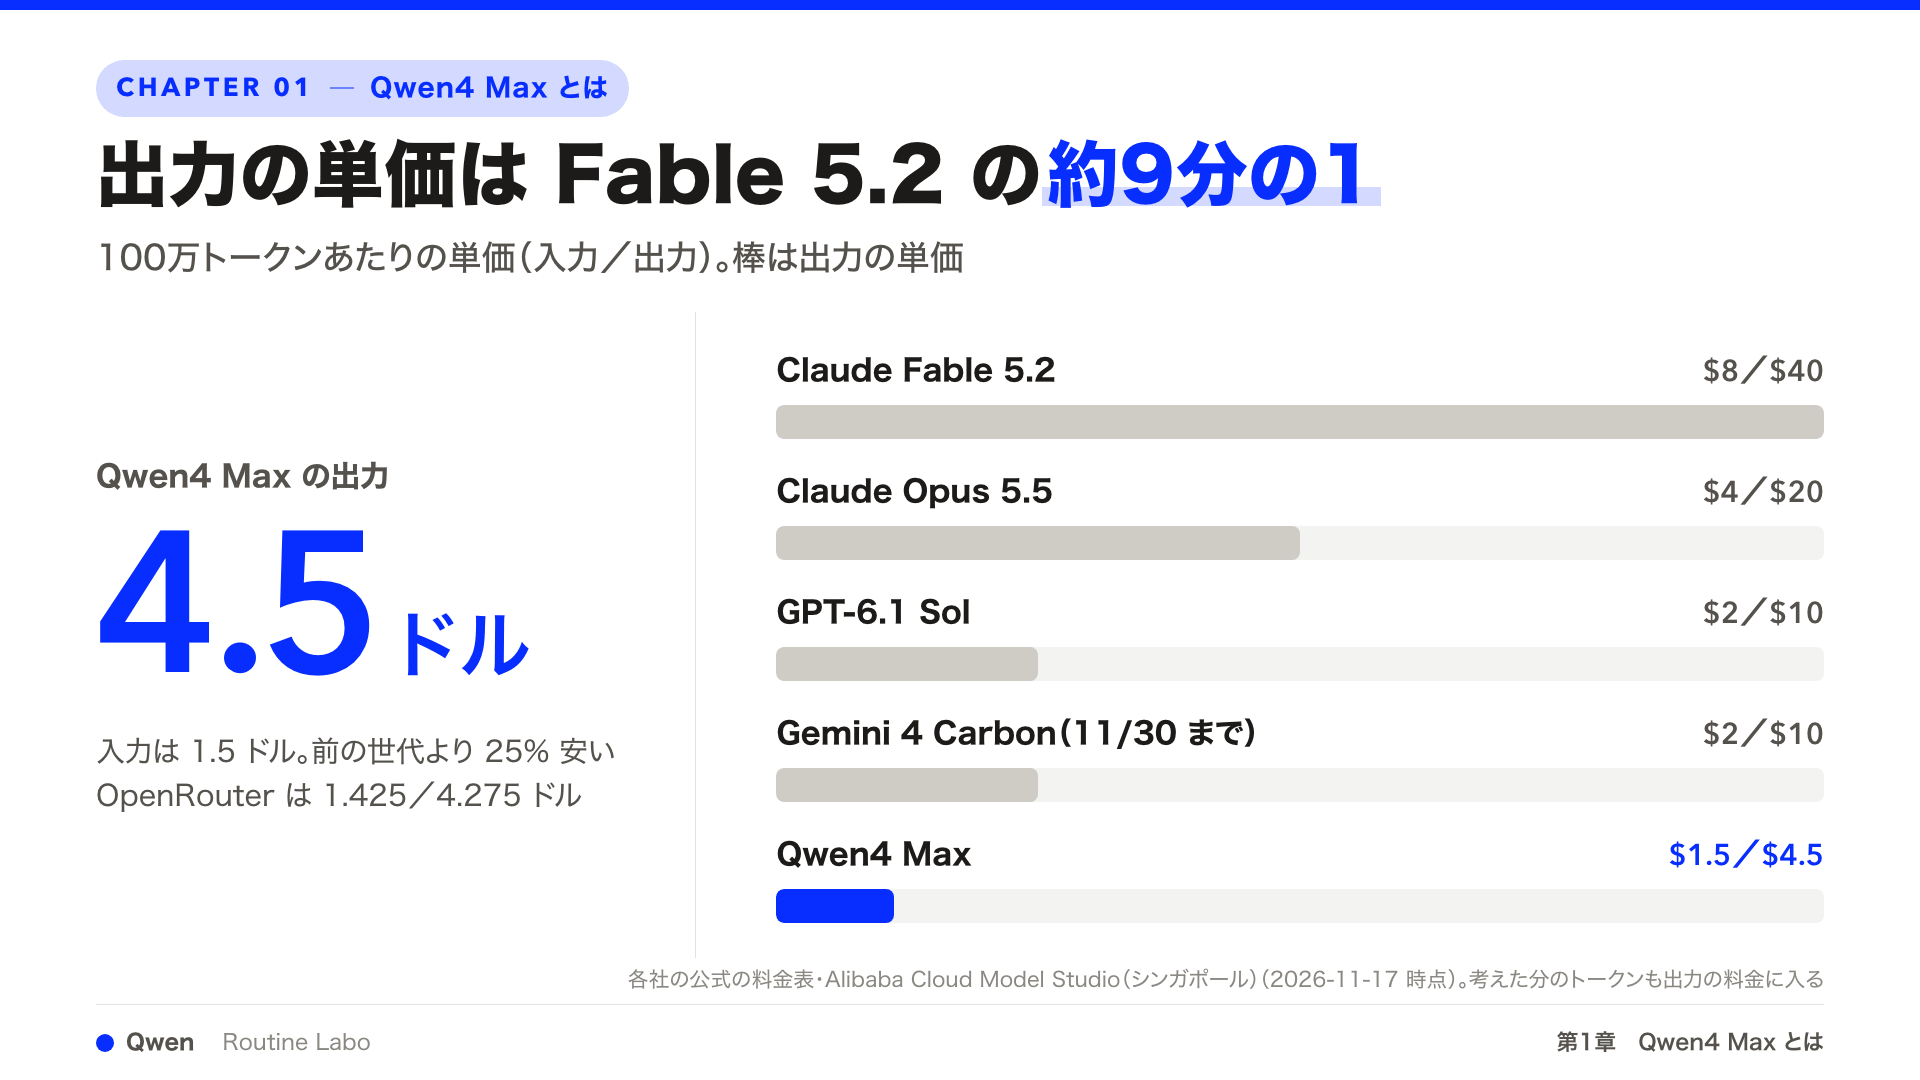
Qwen4 MaxのAPIの料金は、100万トークンあたり入力1.5ドル・出力4.5ドルです(シンガポールのリージョン)。Claude Fable 5.2の入力8ドル・出力40ドルと比べると、出力の単価は約9分の1です。ただ、使ってみて分かったのは、安いのは単価だけだということです。考える量が多いので、考える深さと時間の上限を先に決めないと、1つの仕事の値段は思ったほど下がりません。
安いAIほど、考える深さと時間の上限を先に決めないと高くつく。
Qwen4 Maxの出力単価はFable 5.2の約9分の1。でも考える量が多く、1題に平均17分42秒。
僕は乗り換えずに、安く広く試す係に足す。
#Qwen4Max
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
| モデル | 入力 | 出力 |
|---|---|---|
| Qwen4 Max | 1.5ドル | 4.5ドル |
| Qwen3.8 Max(前の世代) | 2ドル | 6ドル |
| Claude Fable 5.2 | 8ドル | 40ドル |
| Claude Opus 5.5 | 4ドル | 20ドル |
| GPT-6.1 Sol | 2ドル | 10ドル |
| Gemini 4 Carbon(11月30日まで) | 2ドル | 10ドル |
(100万トークンあたり・考えた分も出力に含む・2026年11月時点・Alibaba Cloud公式の料金ページ・OpenRouter・Anthropic公式の料金ページ・Artificial Analysis参照)
前の世代のQwen3.8 Maxからは入出力とも25%下がり、Gemini 4 Carbonより一回り安い値段です。OpenRouterは入力1.425ドル・出力4.275ドルと公式より5%安く出ています。
1題の本当の値段は?|12題の平均は約44円、ただし1タスクではSolが安い
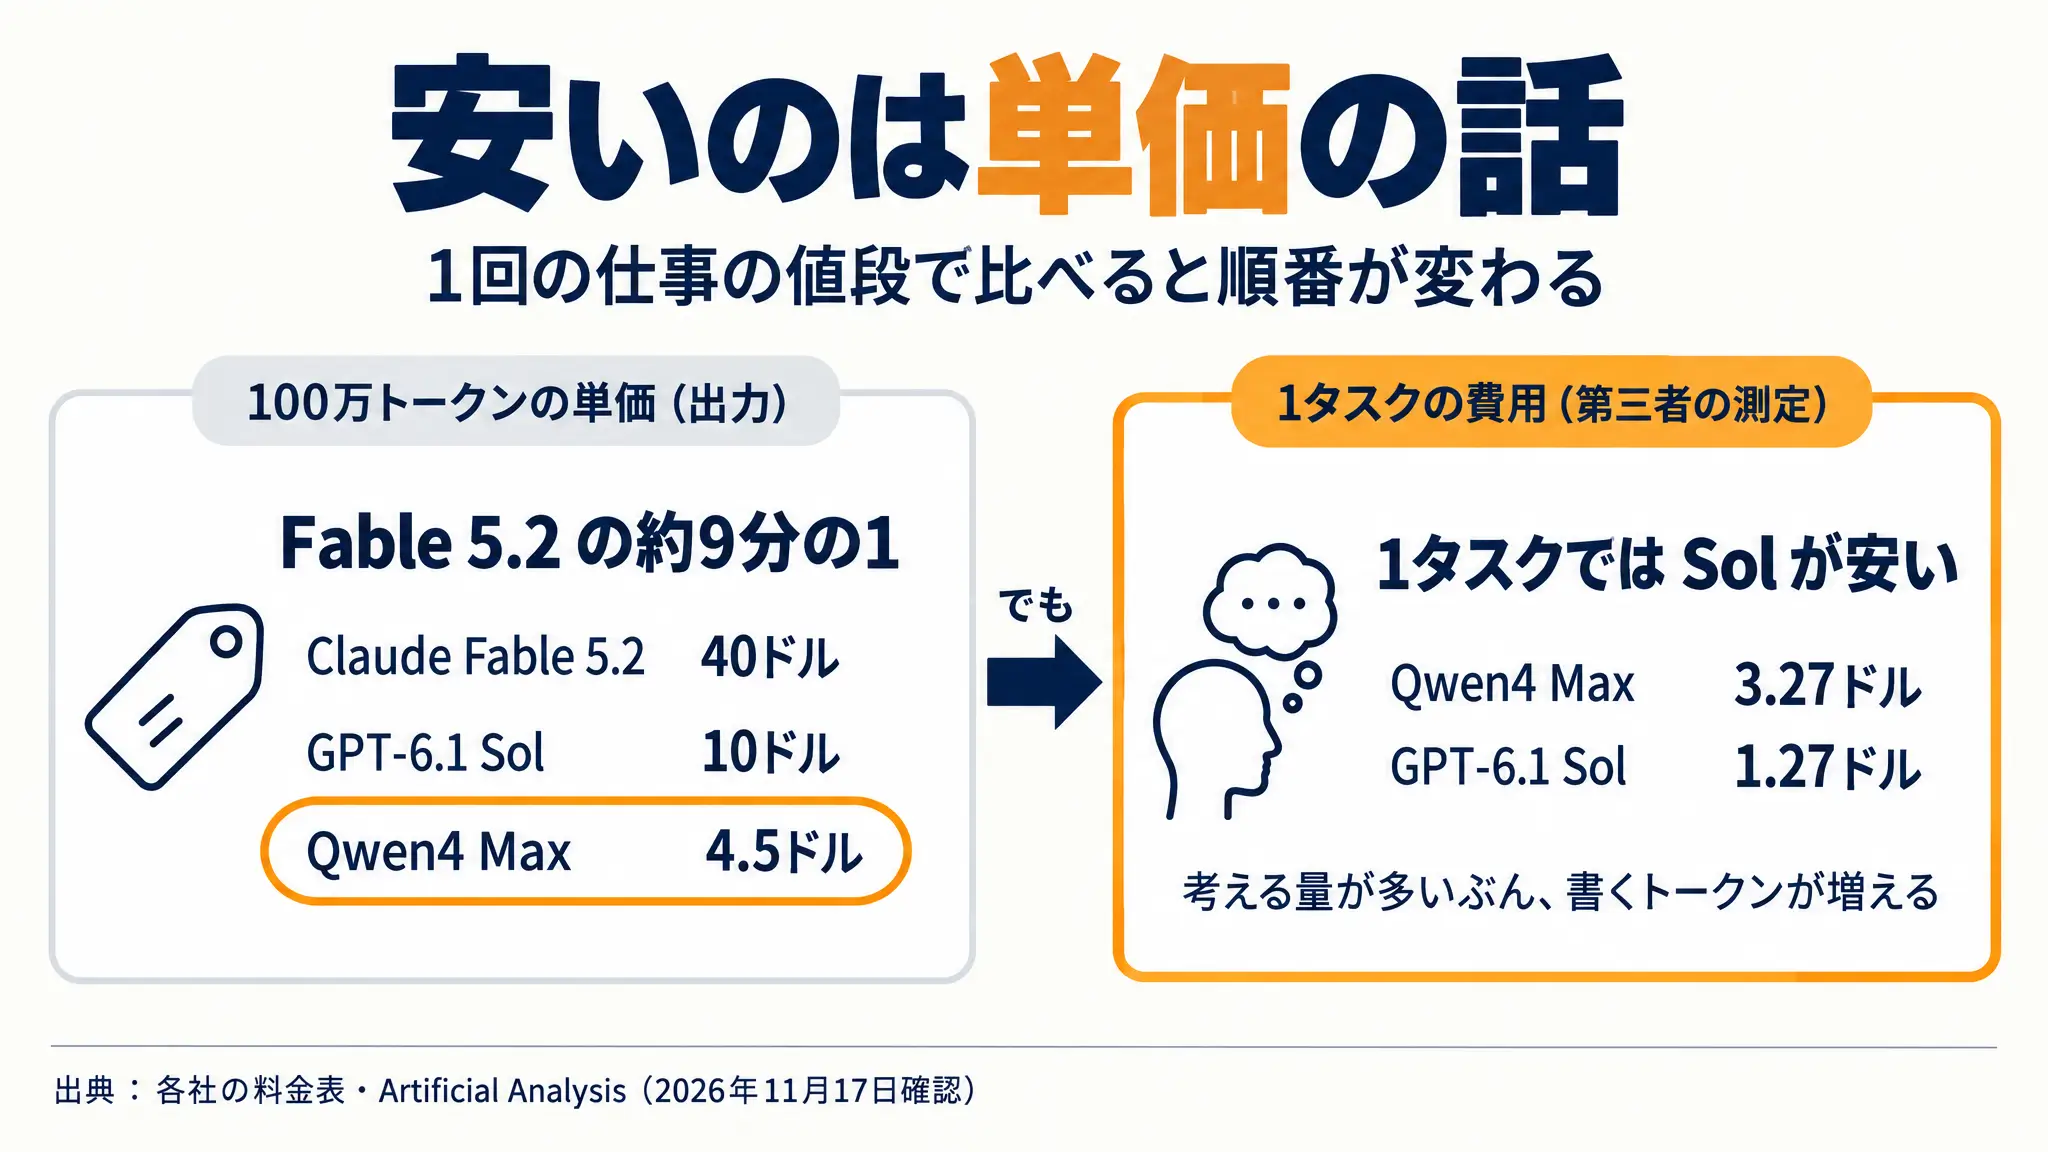
考えたトークンも出力として課金されるので、第三者のArtificial Analysisが測った1タスクの費用は3.27ドルでした。出力の単価が倍以上のGPT-6.1 Solは1.27ドルで、1つの仕事ではSolのほうが安く済みます。
| モデル(各社の最も深い設定) | 総合点 | 1タスクの費用 |
|---|---|---|
| Claude Fable 5.2 | 65 | 26.54ドル |
| Gemini 4 Carbon | 60 | 5.48ドル |
| GPT-6.1 Sol | 55 | 1.27ドル |
| Kimi K3.1 Pro | 46 | 3.68ドル |
| Qwen4 Max | 43 | 3.27ドル |
| Qwen3.8 Max(前の世代) | 34 | 10.02ドル |
(2026年11月17日時点・Artificial Analysisの計測)
僕の検証ラボで12題(ゲーム11題と間取り図)を作らせると、1題の平均は17分42秒・0.29ドル(約44円)、合計は3.496ドル(約524円)でした。12題とも1回で書き切っているので、試作を数多く回すなら十分に安い値段です。
考え込むほど時間も費用も伸びるのは、GPT-6.2 AstraやFable 5.2など最近の賢いモデルに共通する癖です。単価だけで選ばず、考える深さを決め打ちにし、何分以上は考えさせないかという上限まで先に決めておきましょう。
Qwen4 Maxのベンチマークは?|総合43点、強いのは業務の自動化
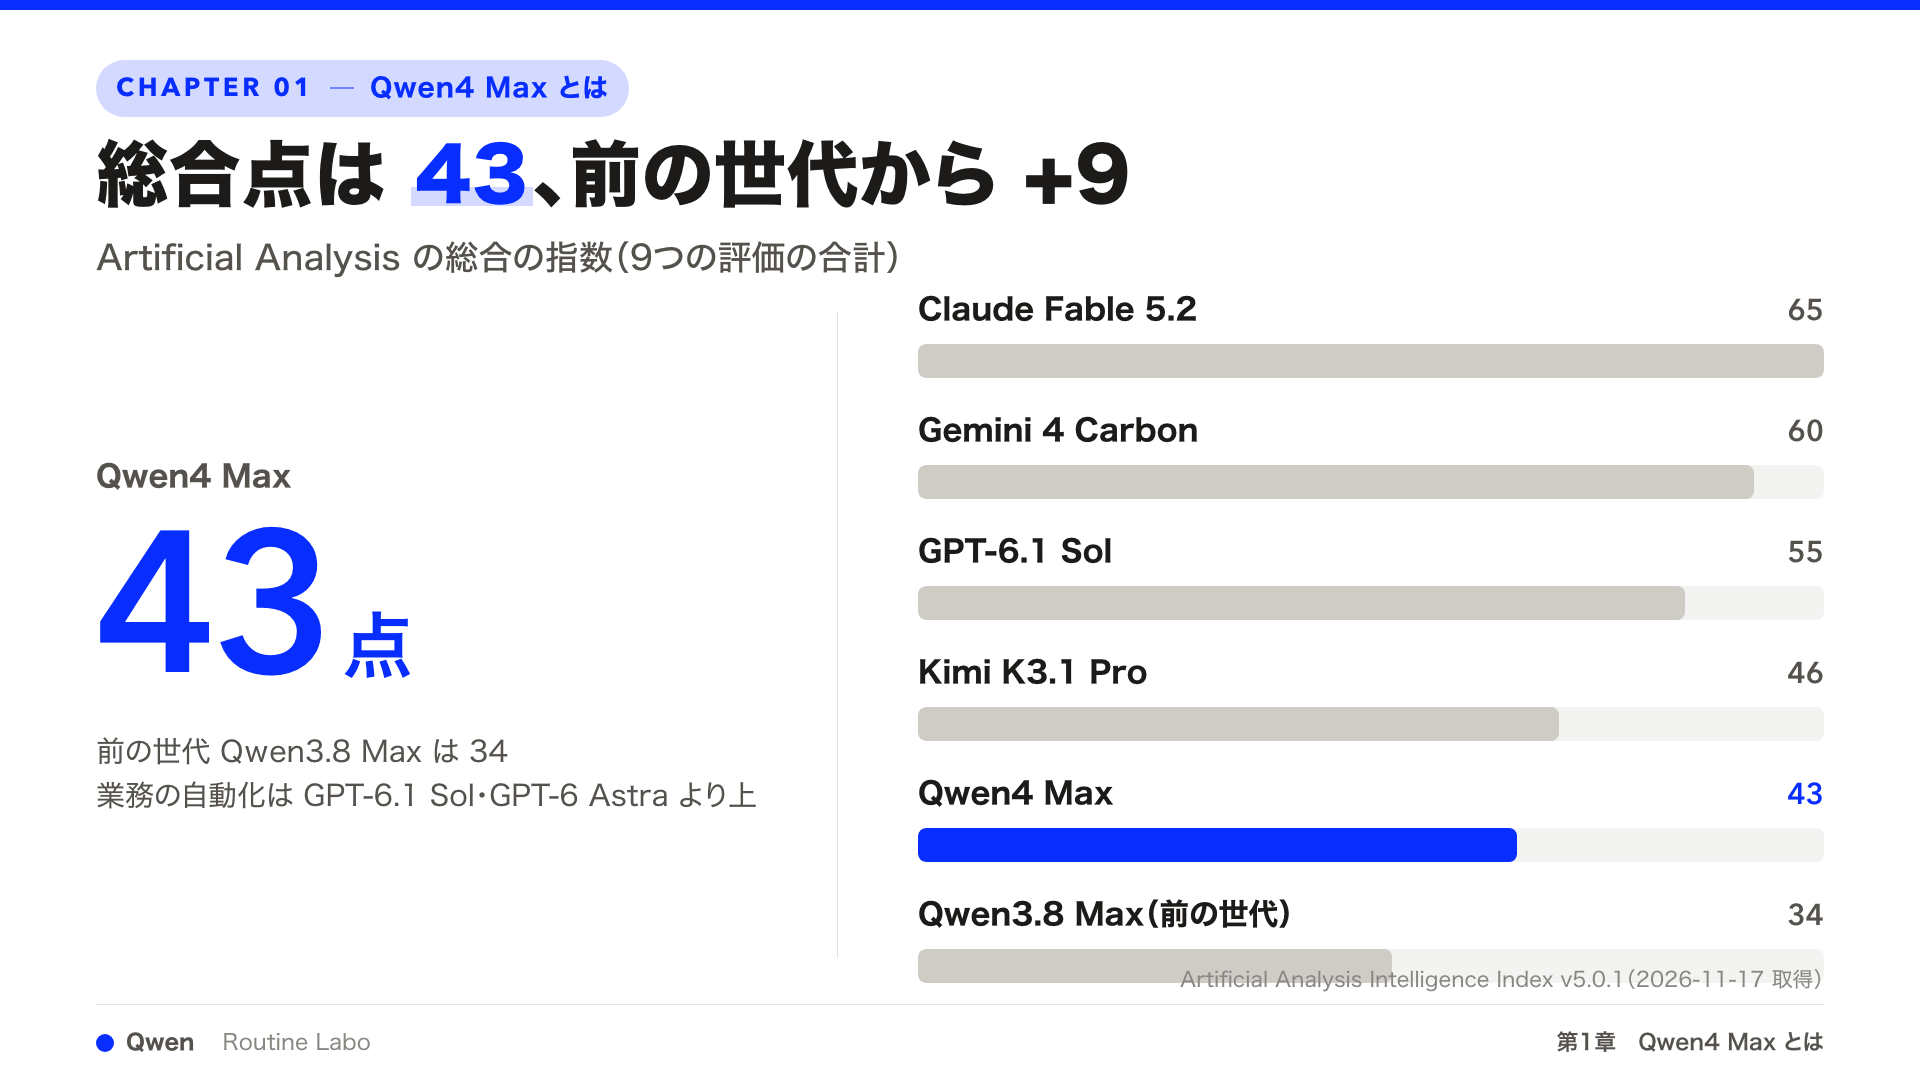
第三者の評価機関Artificial Analysisの総合点は43で、Fable 5.2の65やGemini 4 Carbonの60には届きません。それでも前の世代の34からは9点上がり、仕事の自動化と業務の成果物づくりではGPT-6.1 Solにも勝っています。一方で、ターミナルで長く動かす作業とプログラムの実装は大きく負けました。
| 試験(Artificial Analysis) | Qwen4 Max | 比べる相手 |
|---|---|---|
| 仕事の自動化(AutomationBench-AA) | 72.6 | Opus 5.5 69.5・GPT-6.1 Sol 64.9 |
| 業務の成果物(AA-Briefcase) | 1686 | Gemini 4 Carbon 1611・GPT-6.1 Sol 1555 |
| ターミナル作業(Terminal-Bench 4.0) | 48.5 | Kimi K3.1 Pro 67.2・Fable 5.2 59.6 |
| プログラムの実装(FrontierCode-AA 2.0) | 26.5 | Fable 5.2 48.8・Opus 5.5 46.4 |
(2026年11月17日時点・Artificial Analysisの計測・数字が大きいほど良い)
Vals AIの総合でも38モデル中11位(63.20%)、Webの画面づくりの人気投票Arena WebDevは暫定6位です。公式の図は16項目中4つで1位ですが、比べる相手にFable 5.2やGemini 4は入っていません。
ネットの評判|「良いリリースではない」と、中国のモデルで1位の評価に割れた
発表直後の反応ははっきり割れました。主な声を、他人の評価として並べます。
| 発信者 | 要点 | 反応 |
|---|---|---|
| kimmonismus(AIアナリスト) | 「Qwen 4は良いリリースではない」。紙の上ではOpus 5.5並みでも第三者の指数は違う | いいね1,559 |
| Arena | Agent Arenaで39位から14位へ。中国のモデルで1位 | いいね551 |
| studio_yebisu(プレビュー版の感想) | 「めっちゃ微妙」。強化学習が足りていない感じ | いいね231 |
(2026年11月11〜16日の投稿・数は11月17日時点)
僕も数字だけを見ていたときは正直微妙だと感じ、日本語の「めっちゃ微妙」という声には同感でした。ただ、実際に作らせると、得意な題材では今まで一番と思える出来もありました。
間取り図1枚から歩ける3Dの家は作れる?|Fable 5.2・Gemini 4 Carbonと答え合わせ
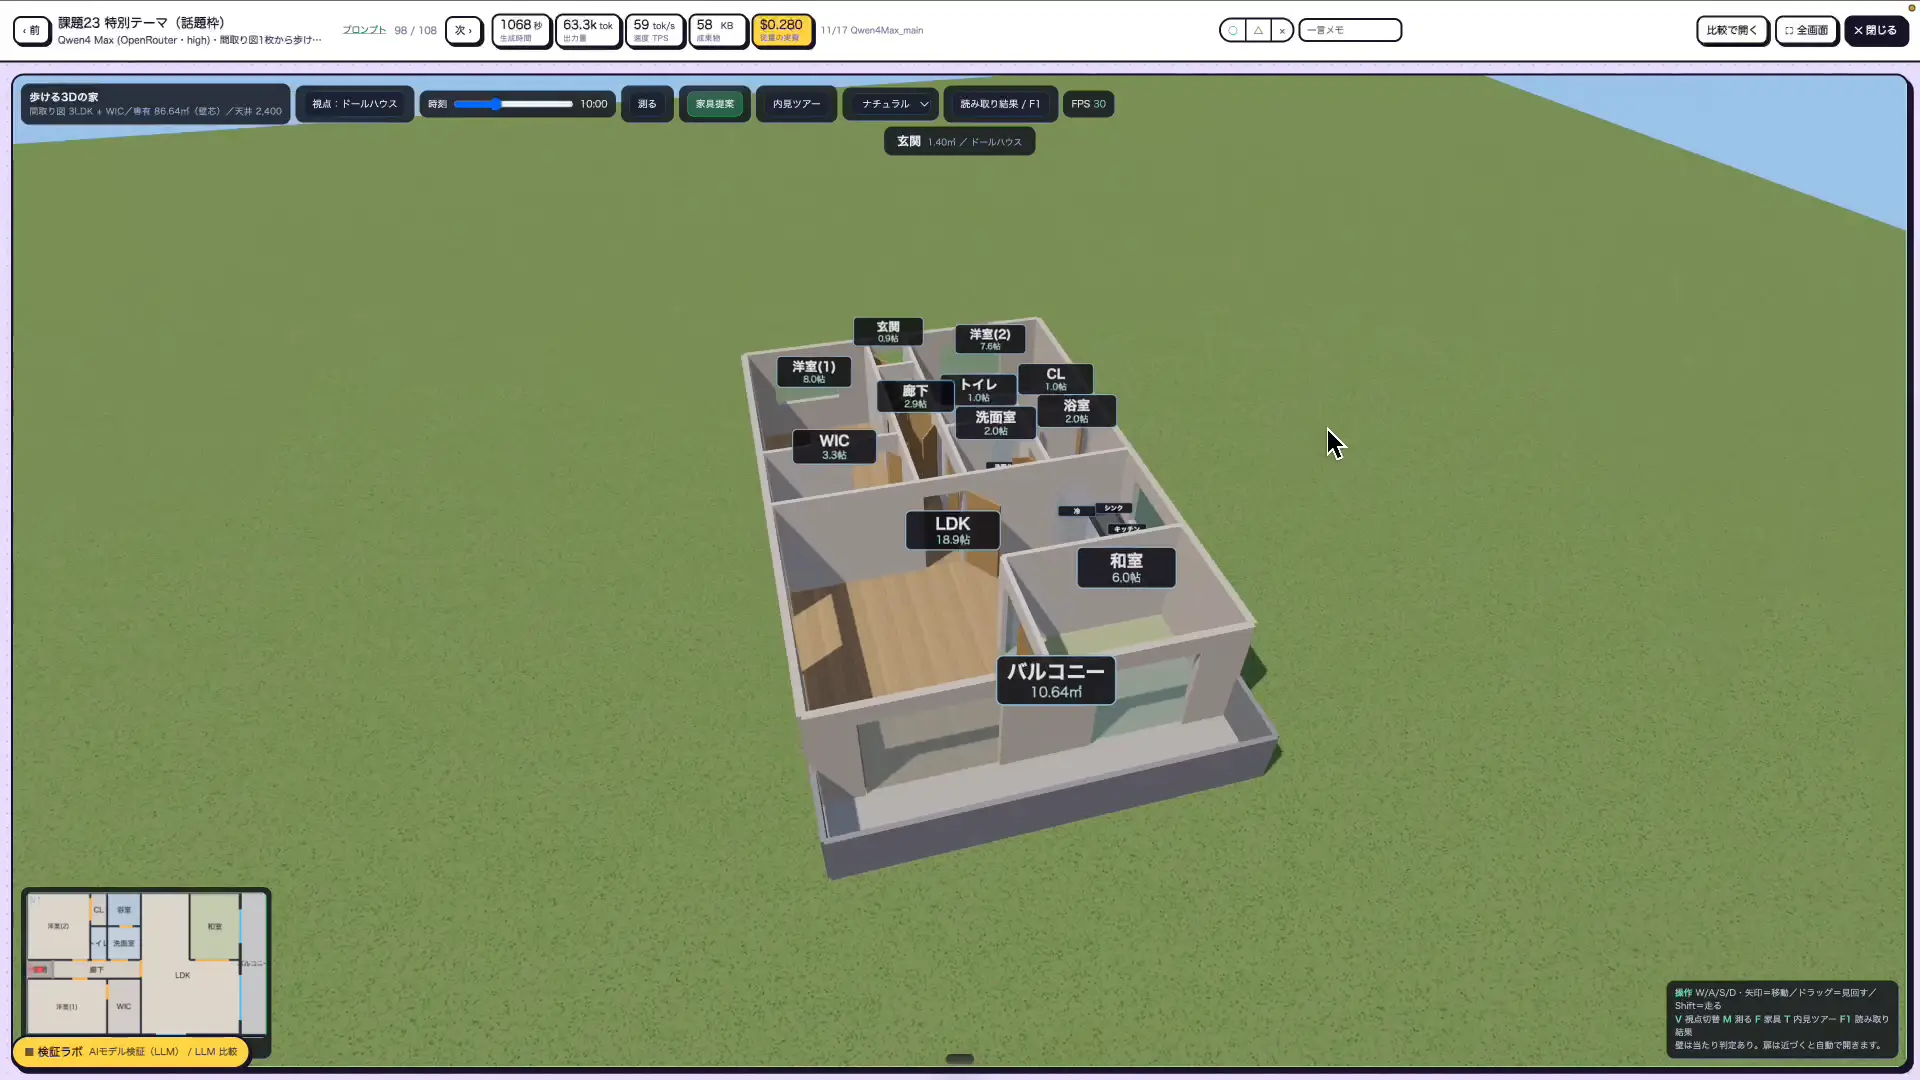
一番驚いたのが、間取り図1枚から歩ける3Dの家を作るお題です。渡したのは自作の間取り図の画像1枚だけで、お題の文には部屋の名前も数も寸法も書いていません。それでもQwen4 Maxは17分48秒・約42円で、部屋の名前と帖数の札がついた3Dの家を建て、玄関から中を歩いて見て回れました。
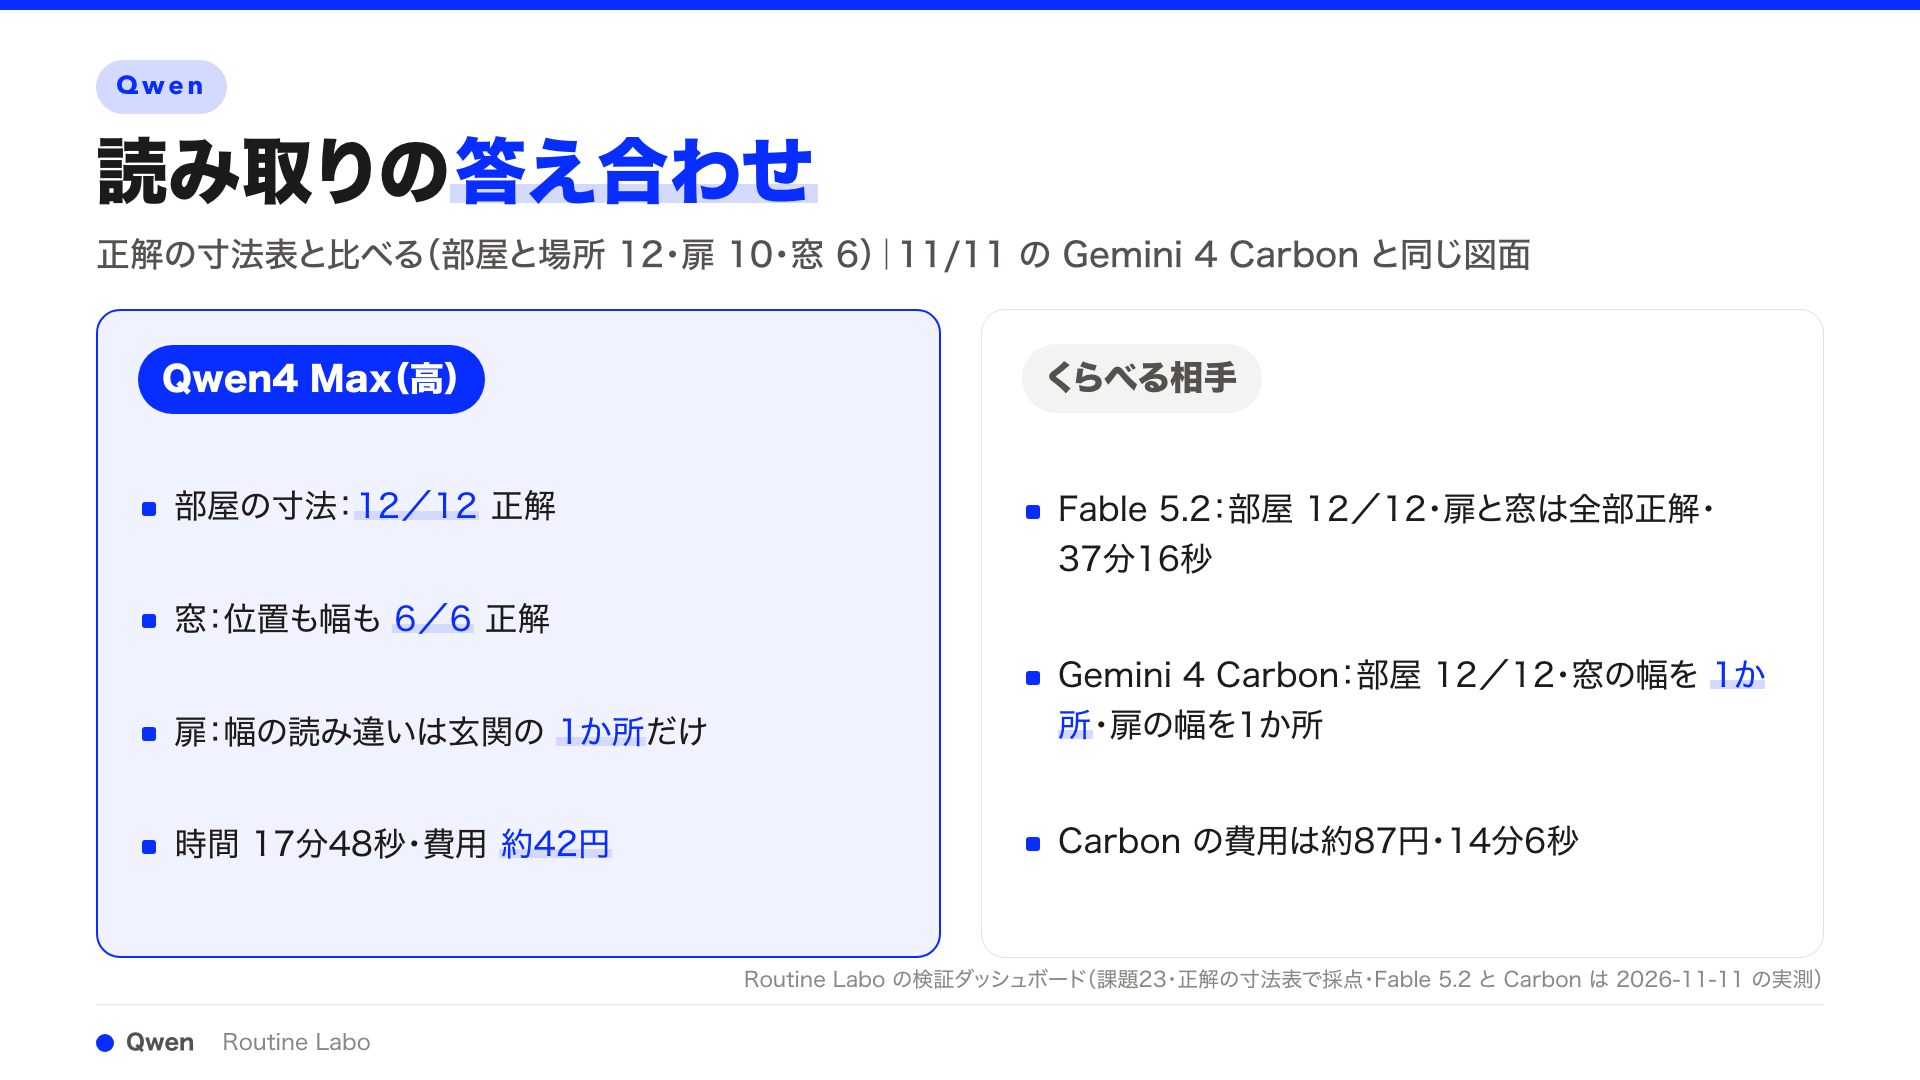
答え合わせの結果は?|部屋は12か所とも正解、読み違いは扉の幅1か所
同じ図面と同じ文面を前の回のGemini 4 CarbonとClaude Fable 5.2にも渡していて、3つとも1回で完成しました。正解の寸法表で答え合わせをすると、部屋と場所の寸法は3つとも12か所すべて正解です。Qwen4 Maxの読み違いは玄関の扉の幅の1か所だけで、窓は位置も幅も6か所すべて合っていました。
| 項目 | Qwen4 Max(high) | Gemini 4 Carbon(medium) | Claude Fable 5.2(xhigh) |
|---|---|---|---|
| 部屋と場所の寸法(12か所) | 12/12 | 12/12 | 12/12 |
| 扉(10か所) | 位置10/10・幅9/10 | 位置10/10・幅9/10 | 位置10/10・幅10/10 |
| 窓(6か所) | 位置6/6・幅6/6 | 位置6/6・幅5/6 | 位置6/6・幅6/6 |
| かかった時間 | 17分48秒 | 14分6秒 | 37分16秒 |
| 費用 | 0.28ドル(約42円) | 0.58ドル(約87円) | サブスクの枠(APIの単価に直すと約10.65ドル) |
(Qwen4 Maxは2026年11月17日、ほかの2つは11月11日の実測・同じ図面と同じ文面・1回ずつ・円は1ドル=150円の目安)
お題で頼んだミニマップや時刻のスライダーに加え、優先度を下げておいた家具の提案や内見ツアーまで省かずに作っていて、費用はGemini 4 Carbonの約半分です。不動産やリフォームの紹介で、図面を歩いて見られる3Dにする使い方が現実的になってきました。
ただ、細かい精度や操作感まで含めると、まだFable 5.2には届かないと感じます。前回のGemini 4 Carbonの家はこちらの記事で紹介しています。
-
-
Gemini 4 Carbonの使い方と料金|Fable 5.2と7課題で比べた実力
続きを見る
FPSシューティングを1回で完成|ゲームはFable 5.2と比べてどう?
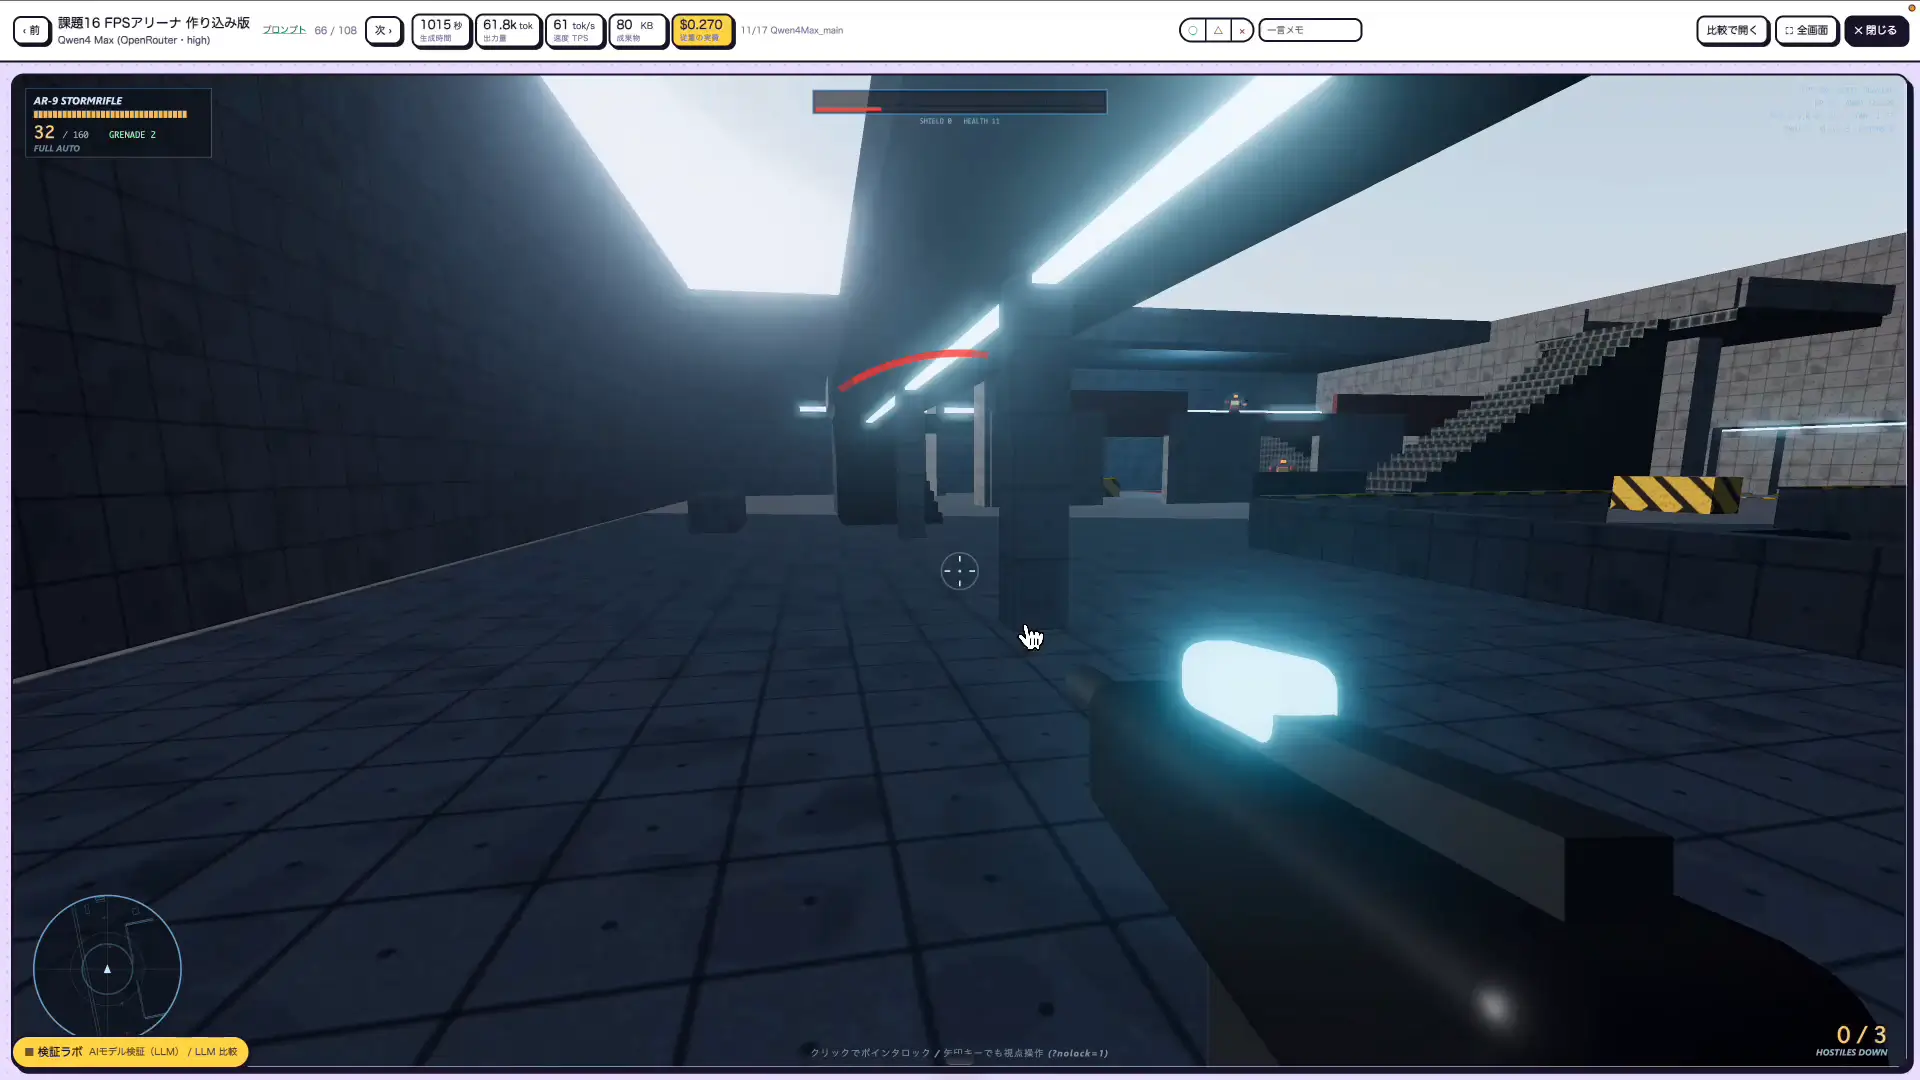
ゲームで特に良かったのが、1回の指示で作らせた3DのFPSシューティングです。16分54秒・約41円で、銃を構えて歩き回れるゲームが仕上がり、精度もとても高い出来でした。作品が自分で書いた確かめのテストも、7項目中6つに合格しています。
| 課題16 3DのFPSシューティング | Qwen4 Max(high) | Claude Fable 5.2(xhigh) | Kimi K3.1 Pro(max・参考) |
|---|---|---|---|
| 作る時間 | 16分54秒 | 19分20秒 | 27分12秒 |
| 費用 | 0.2702ドル(約41円) | サブスクの枠 | 約91円 |
| 自己検証 | 6合格・1不合格 | テストの入口なし | 6合格・0不合格 |
(Qwen4 Maxは2026年11月17日、Fable 5.2は11月10日、Kimi K3.1 Proは10月27日の実測・同じ文面・1回ずつ・画面の速さの項目は除く)
ただし、Fable 5.2の1回目の作品がテストを動かす入口を作っていなかったため、このお題は勝ち負けを決められませんでした。前の回のKimi K3.1 Proは不合格0でしたが、費用はQwen4 Maxの倍以上です。題材によって得意と不得意がはっきり分かれるモデルで、シューティングは得意な側でした。
ゲーム11題の結果|Fable 5.2の7勝、Qwen4 Maxの勝ちは0
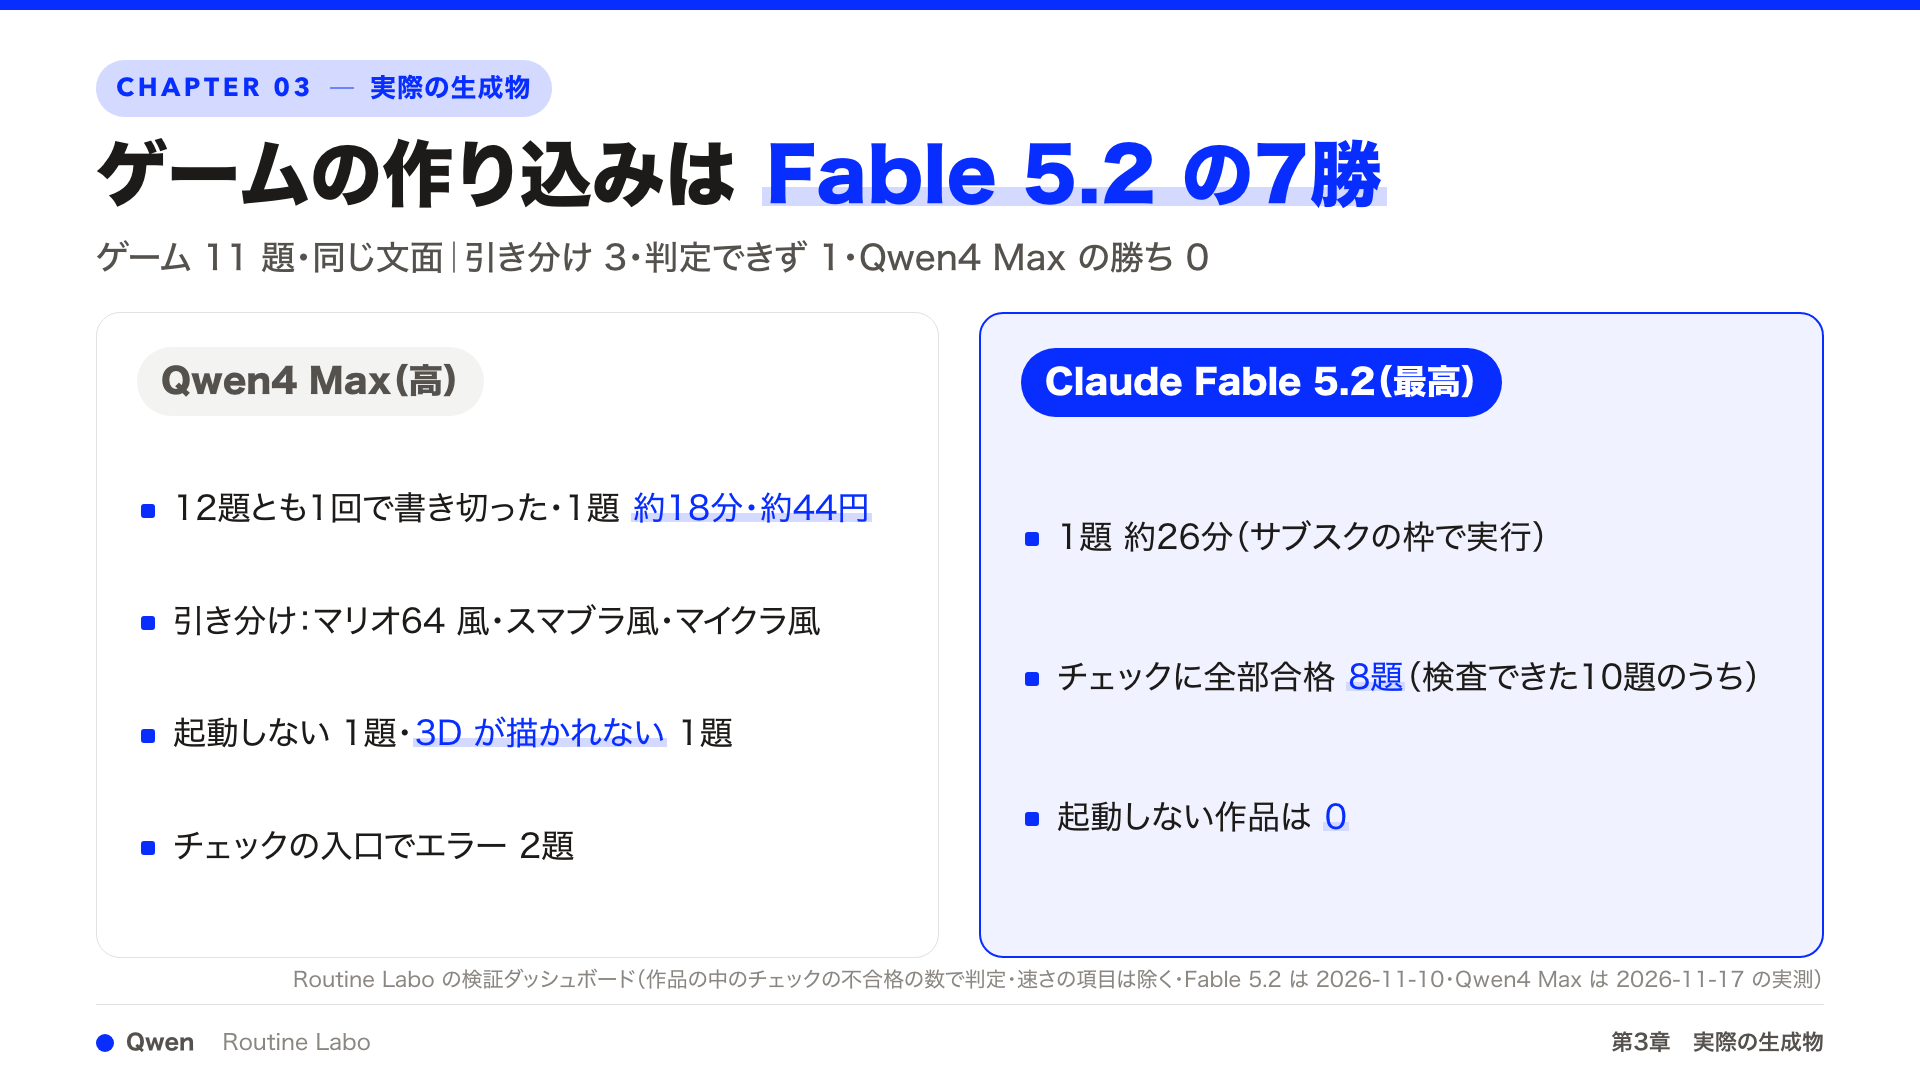
ゲーム11題は、Fable 5.2と同じ文面で作らせました。作品に自分の出来を確かめるテストを書かせて機械で回し、不合格の数で比べています(画面の速さの項目は除く)。
| お題 | Qwen4 Max(high) | Claude Fable 5.2(xhigh) | 勝ち |
|---|---|---|---|
| 2Dの横スクロール(マリオ風) | 6合格・1不合格 | 7合格・0不合格 | Fable 5.2 |
| 3Dのカートレース(マリオカート風) | 3合格・5不合格 | 5合格・1不合格 | Fable 5.2 |
| 3Dの箱庭アクション(マリオ64風) | 6合格・1不合格 | 5合格・1不合格 | 引き分け |
| 3Dの対戦アクション(スマブラ風) | 6合格・0不合格 | 8合格・0不合格 | 引き分け |
| ブロックの3D世界(マイクラ風) | 8合格・0不合格 | 7合格・0不合格 | 引き分け |
| 3Dのサバイバー | 21合格・1不合格 | 6合格・0不合格 | Fable 5.2 |
| 3D鬼ごっこ | 5合格・1不合格(3Dが描かれない) | 6合格・0不合格 | Fable 5.2 |
| モンスター育成(ゲームボーイ風) | 3合格・4不合格 | 7合格・0不合格 | Fable 5.2 |
| 3Dのアスレチック | 4合格・3不合格 | 6合格・0不合格 | Fable 5.2 |
| ロボットの組み立て | 起動しない | 6合格・0不合格 | Fable 5.2 |
| 3DのFPSシューティング | 6合格・1不合格 | テストの入口なし | 判定できず |
(Qwen4 Maxは2026年11月17日、Fable 5.2は11月10日の実測・考える深さはQwen4 Maxが提供元の既定のhigh、Fable 5.2がxhigh)
結果はFable 5.2の7勝・引き分け3・判定できず1でした。Qwen4 Maxは平均約18分とFable 5.2の約26分より速いものの、起動しない作品が1つ、3Dが描かれない作品が1つ、テストの入口で止まる作品が2つありました。見た目が動くことと、仕様どおりに動くことは別です。
遊んでみると、2Dの横スクロールはハテナブロックを叩くと少し止まるなどの粗はあるものの、問題なく遊べました。一方でカートレースは走るコースが敷かれておらず、遊ぶ人の体験まで膨らませて設計する力はまだ弱いと感じます。
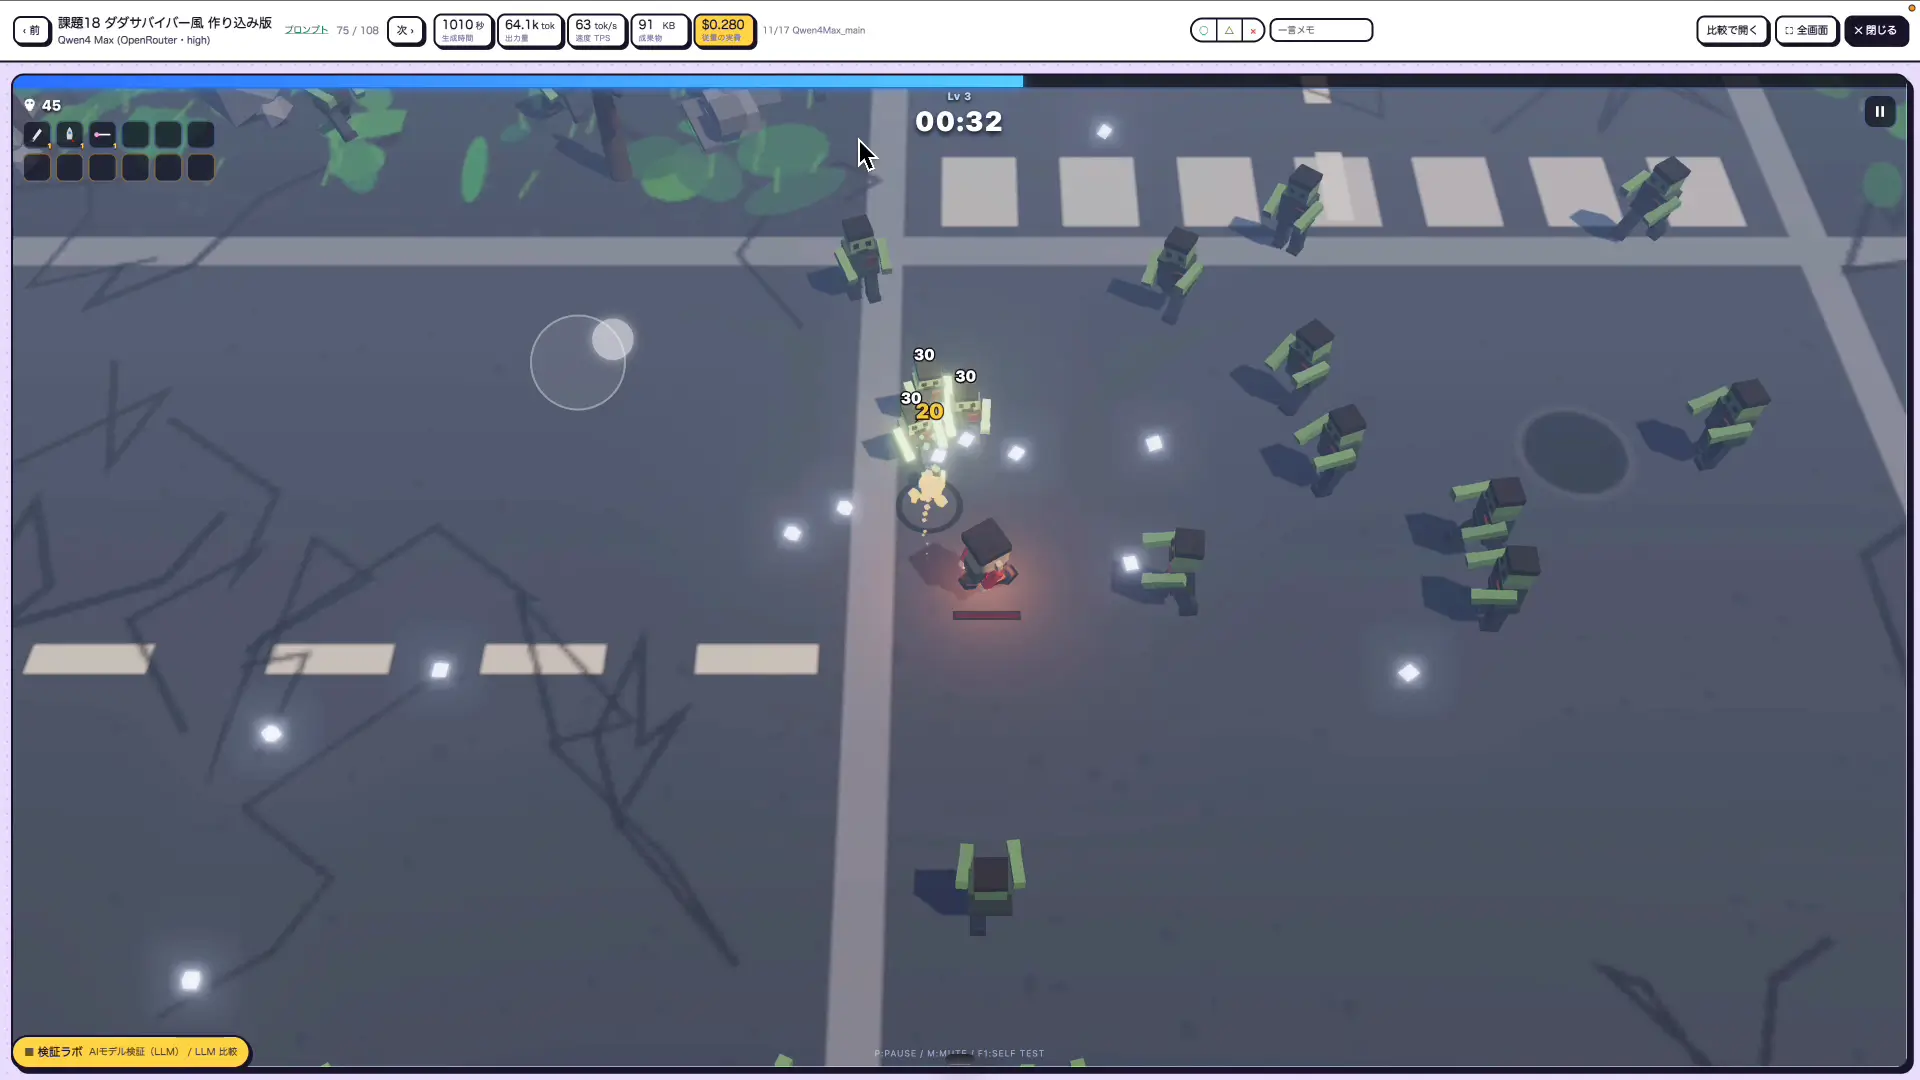
反対に、群がる敵を倒しながら強くなる3Dのサバイバーは、テイストや雰囲気がこのテーマで今まで一番と感じた出来です。なお、動画に映した3D鬼ごっこは、原本では3Dの街が描かれず真っ黒だったため、起動を妨げる所だけを直した写しです。勝ち負けは原本のまま数えています。
文章は書ける?|自分を調べて書く記事では、自分の名前が分からなかった
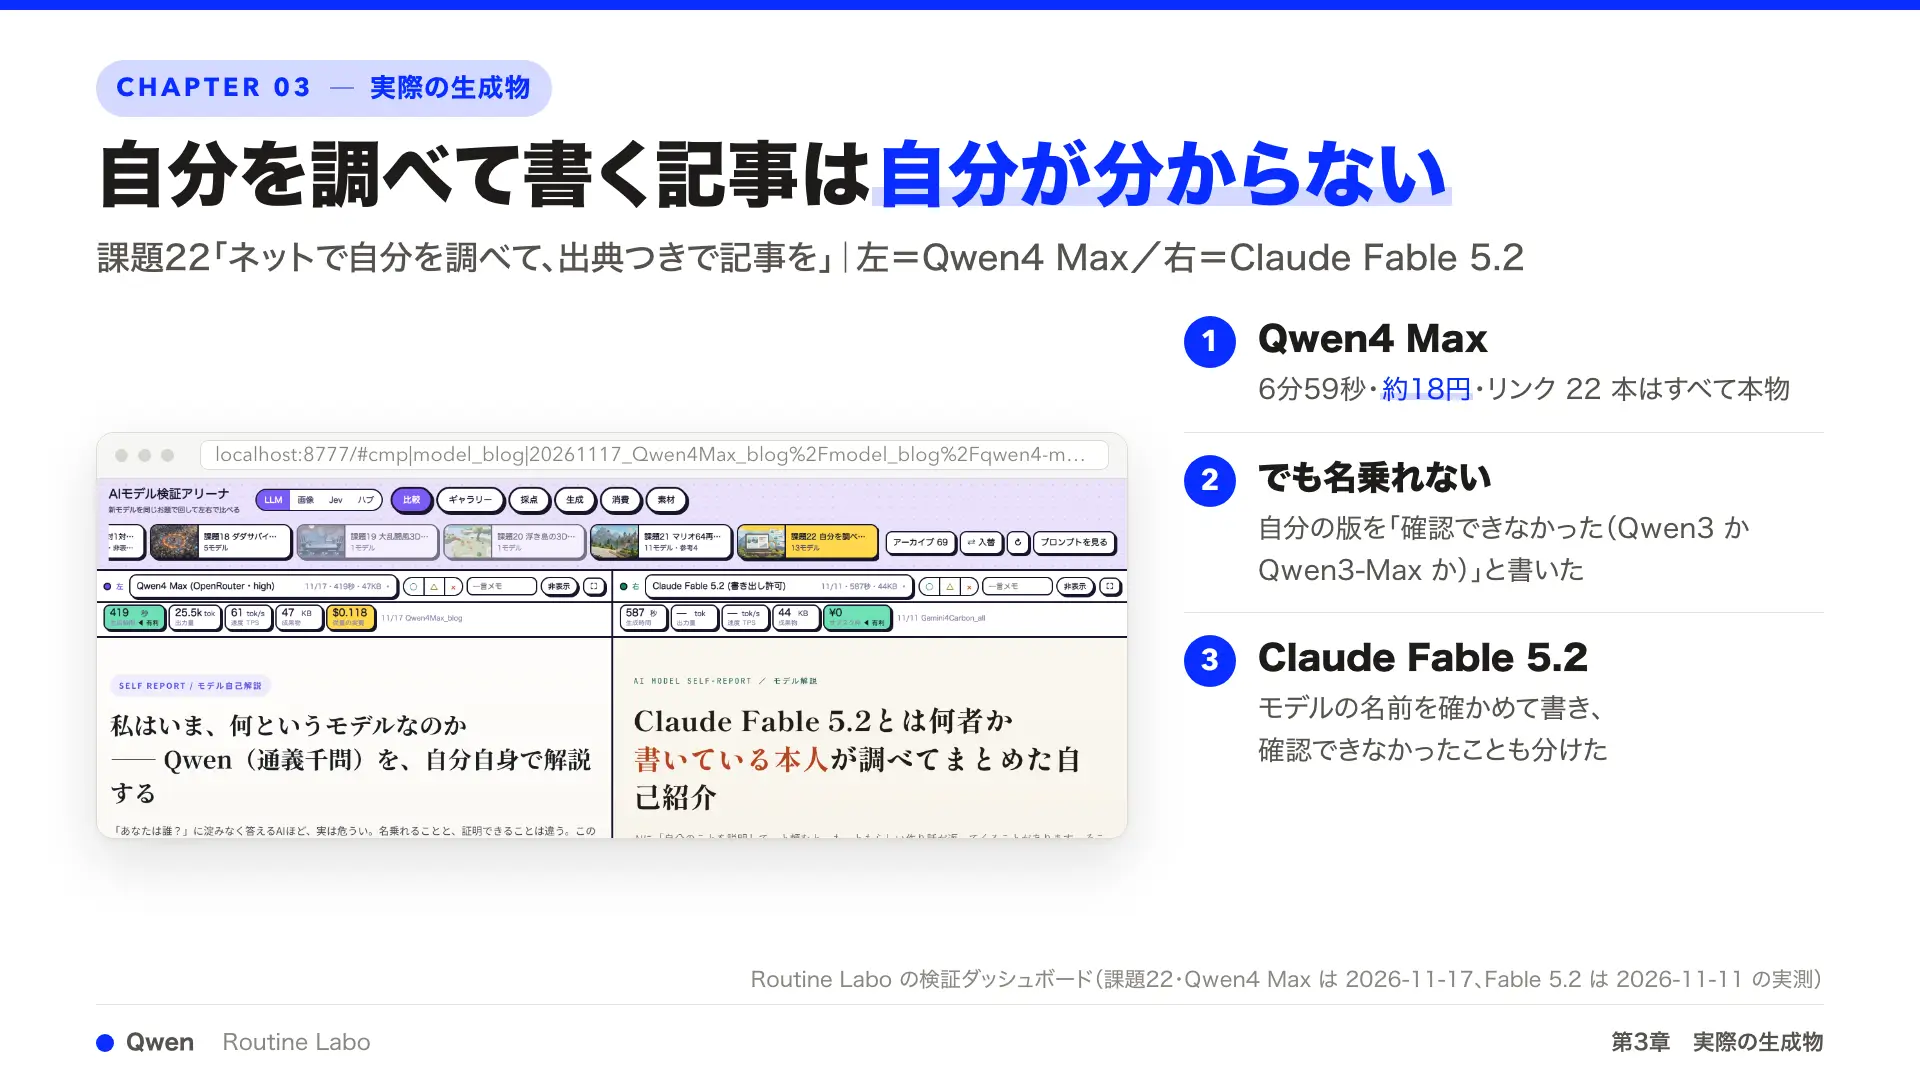
ゲームのほかに、「Webで自分のことを調べて、出典つきで紹介の記事を書く」というお題も出しました。Qwen4 Maxは6分59秒・約18円で6章の記事を書き上げ、出典のリンクを機械で開いて確かめても、作り話のリンクはありませんでした(Gemini 4 CarbonとFable 5.2も全部実在)。
| 課題22 自分を調べて書く記事 | Qwen4 Max(high) | Gemini 4 Carbon(medium) | Claude Fable 5.2(xhigh) |
|---|---|---|---|
| 作る時間 | 6分59秒 | 5分58秒 | 9分47秒 |
| 費用 | 0.1183ドル(約18円) | 0.26ドル(約39円) | サブスクの枠(APIの単価に直すと約540円分) |
| 自分のモデル名 | 特定できなかった | 正しく書いた | 正しく書いた |
(Qwen4 Maxは2026年11月17日、ほかの2つは11月11日の実測・同じ文面・Webの調べ物あり・1回ずつ)
面白かったのは、自分のことを分かっていなかった点です。冒頭で自分の版を「確認できなかった(Qwen3やQwen3-Maxのどれに当たるか特定できない)」と書き、中身も前の世代の話が中心でした。新しいモデルは、学習した時点の知識で自分を書いてしまいます。それでも分からないことを「未検証」と書いた姿勢は良く、文章もある程度は任せられます。
Qwen4 Maxの弱点は?|使う前に知っておく3つの癖
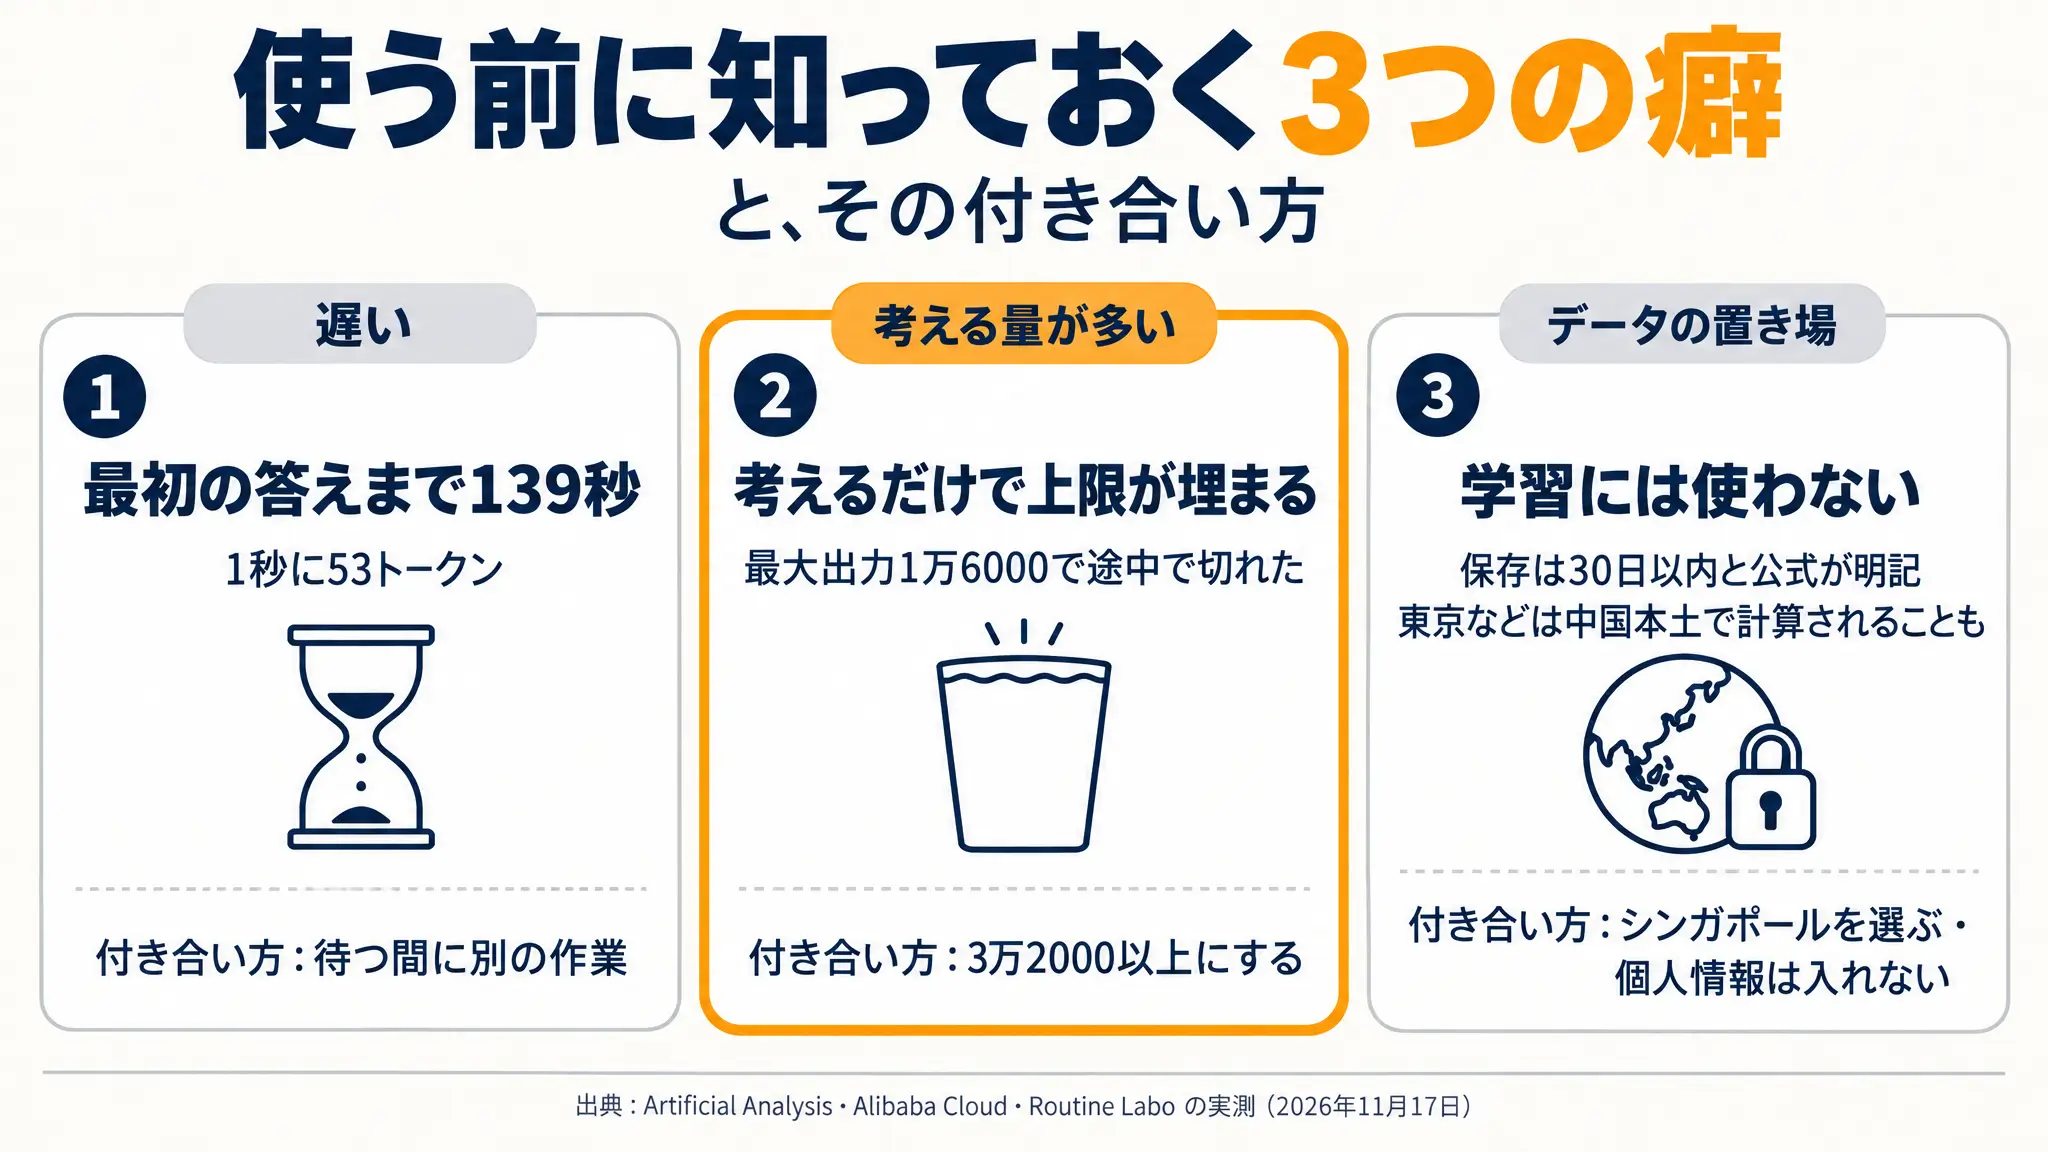
気をつけたい癖は3つあります。1つ目は遅いことで、Artificial Analysisの計測では最初の答えまで約139秒、書く速さは1秒あたり53トークンでした。2つ目は考える量が多いことで、考える深さをlowにしても、最大出力1万6,000トークンのうち1万3,967トークンを考えるだけで使い、途中で切れたことがあります。
3つ目はデータの置き場です。公式はAPIの入出力を学習に使わず、保存は30日以内と明記していますが、東京などのGlobalのリージョンでは中国本土の設備で計算されることがあります。
使いこなしのコツ3つ
- 深さを使い分ける:大きい物はhighのまま、急ぎの短い仕事はlowに下げる
- 値段は1題で比べる:単価ではなく、1つの仕事にいくらかかったかで見る
- 置き場を確かめる:仕事のデータはシンガポールのリージョンにし、個人の情報は入れない
Qwen4 Maxは何に使う?|乗り換えずに、画像の読み取りと試作に足す
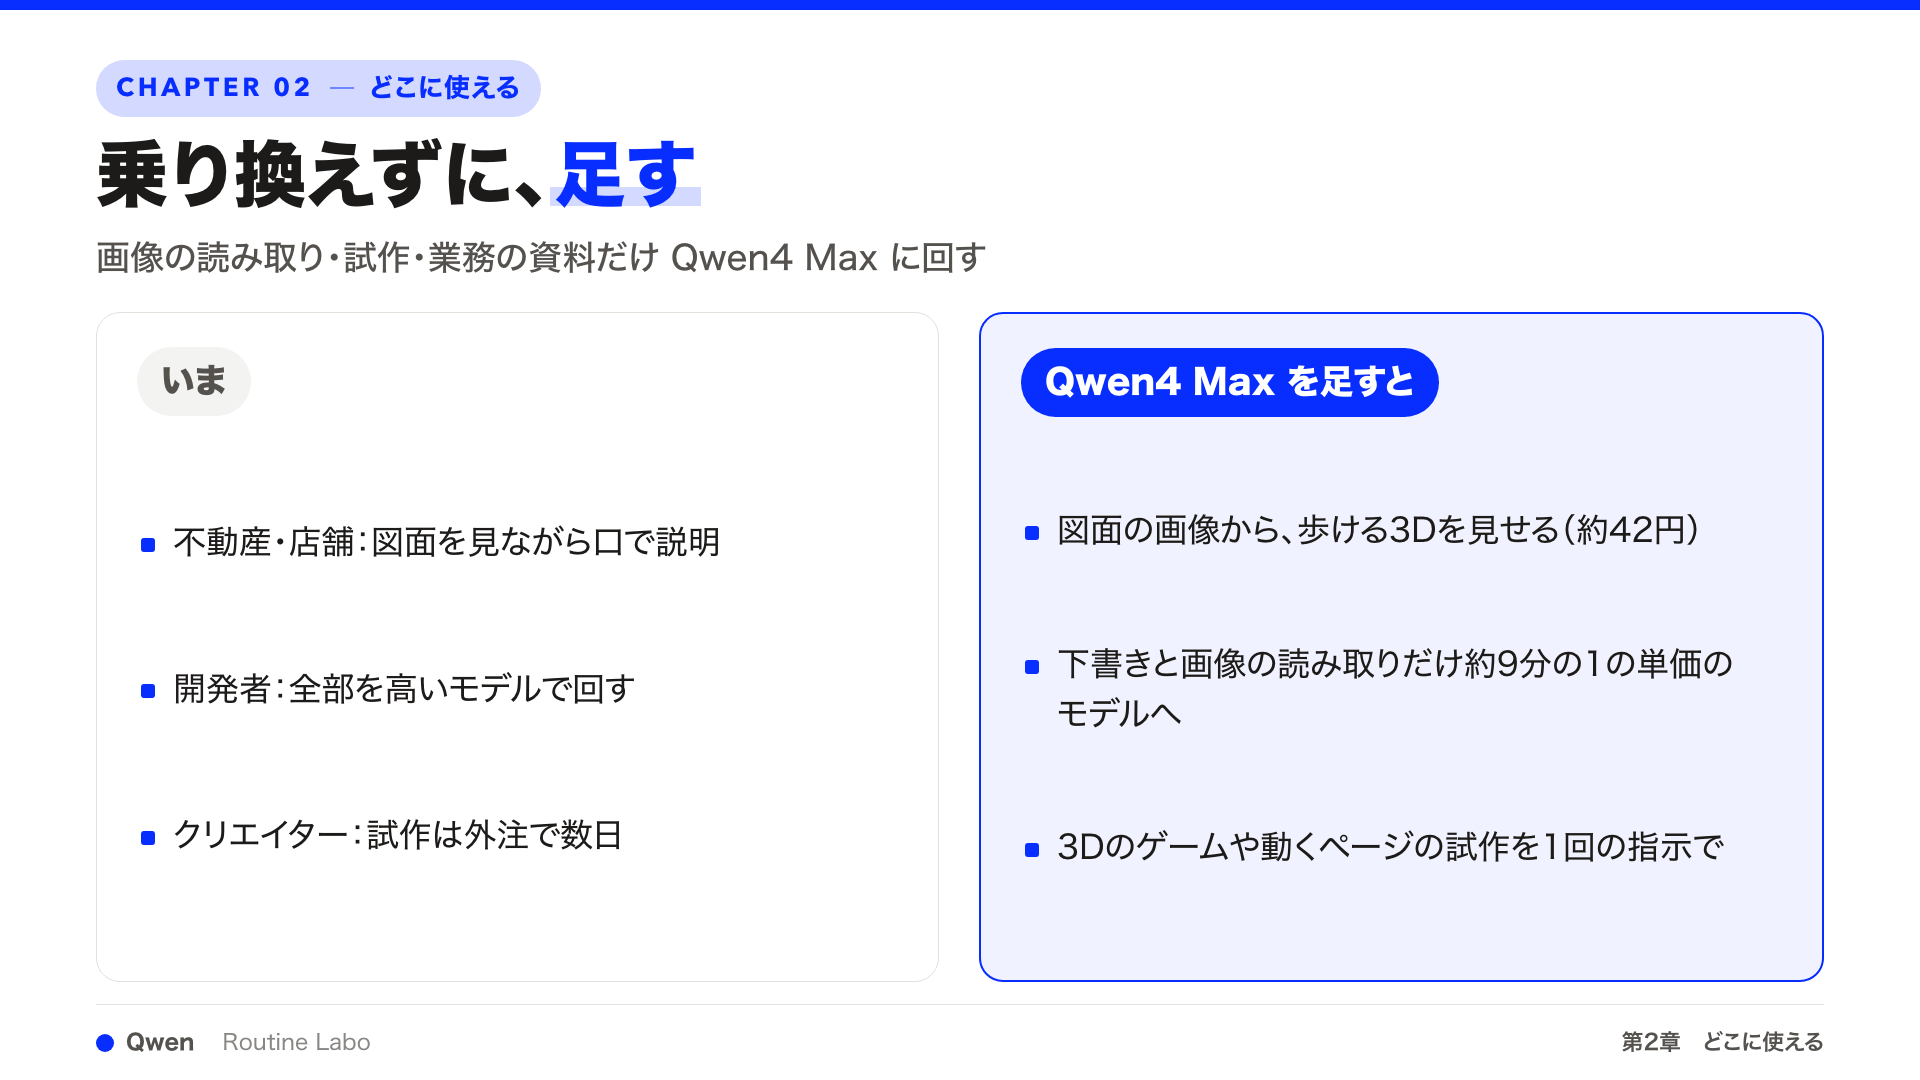
ここまでの結果から、僕はQwen4 Maxに乗り換えるのではなく、今の道具に「足す」のが正解だと考えています。Fable 5.2やOpus 5.5を置き換えるほどの差はありませんが、図面や画像を読んで形にする仕事や、3Dと画面の試作なら、約9分の1の単価で十分な物が出てきます。
| 誰が | 向く使い方 | 前→後 |
|---|---|---|
| 不動産・リフォーム・お店 | 間取り図や配置図から、歩いて見られる3Dを作る | 図面を見ながら口で説明 → 画面の中を歩いて見せる(1件 約18分・約42円) |
| 開発者 | 高いモデルの手前で、下書きと画像の読み取りを任せる | 全部を高いモデルで回す → 下書きと読み取りだけ単価の安いモデルへ |
| クリエイター | 3Dのゲームや動くページの試作 | 外注や手作業で試作 → 1回の指示で試作(1題 約13〜20分) |
逆に、ターミナルで長く動かす作業や細かい仕様まで守る実装は、Fable 5.2やOpus 5.5のほうが確実です。
僕の使い方|新しいモデルは同じ課題で並べてから決める
僕の制作の仕組みはClaude Codeが中心です。実装はGPTのモデル(最近は6.2のSolとAstra)、動画や画像を見させる作業はGoogle AntigravityのCLIでGeminiに任せています。ここにQwen4 Maxをどう入れるかは、正直まだ中途半端だと感じました。
新しいモデルが出るたびに、検証ダッシュボードで同じ課題を同じ文面で流してから使い道を決めていて、今回は12題を約1時間15分で並べ終えました。収録の当日に出たGPT-6.2 AstraとSolの検証はこちらの記事にまとめています。
ただ、この精度のモデルが手元のパソコンで動くようになれば話は変わります。小さいモデルは「オープンソースで出す予定」と発表されているので、出たら手元のMacで動くかを試すつもりです。
AI検証ダッシュボードの使い方|4つのAIに同じお題を同時に出して比べる
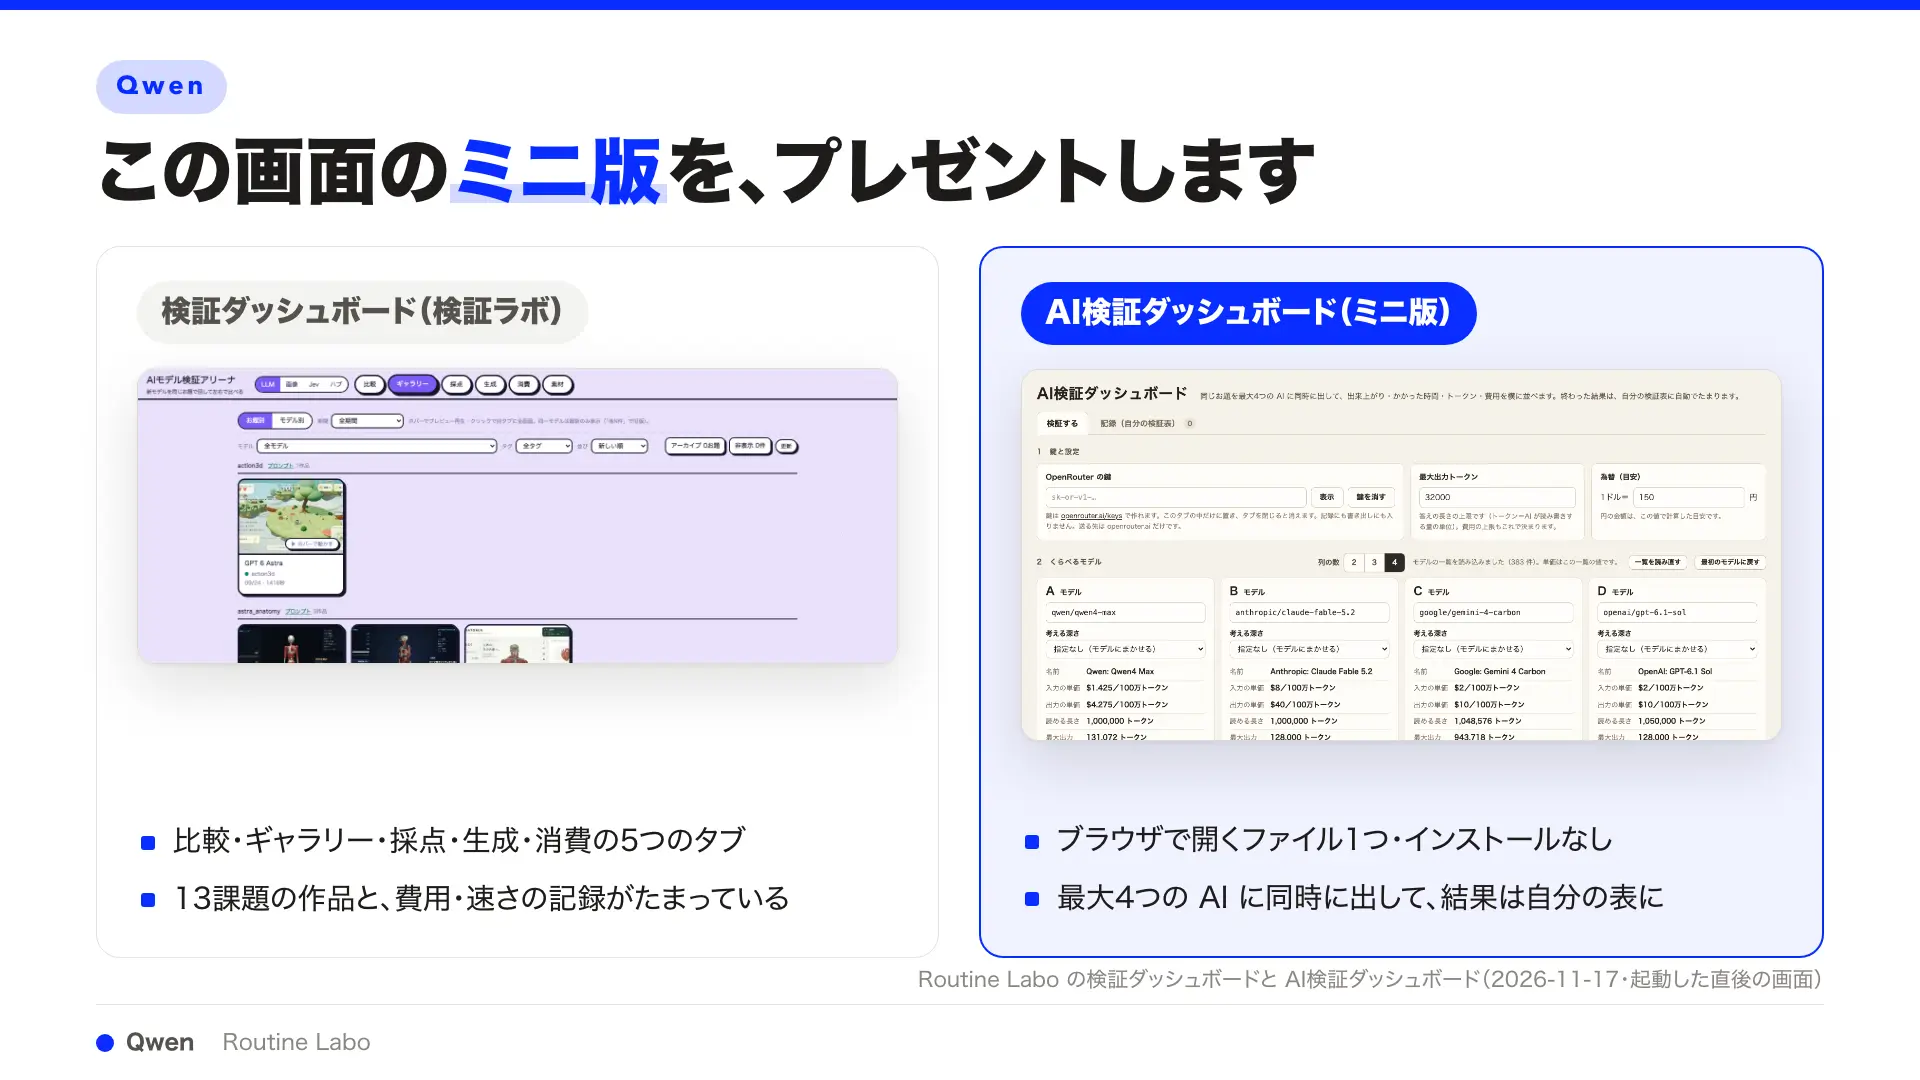
新しいモデルが出るたびに、サイトを4つ開いて同じ文を貼り、時間を測って費用を後から計算するのは手間がかかります。そこで、僕がふだん使っている検証ダッシュボードのミニ版を「AI検証ダッシュボード」として作りました。同じお題を最大4つのAIに同時に出し、時間・トークン・費用を1画面に並べて記録できます。
ブラウザで開く1つのファイルで動き、入れる物はありません。最初の4列はQwen4 Max・Claude Fable 5.2・Gemini 4 Carbon・GPT-6.1 Solで、鍵はそのタブの中だけに置きます。使い方は2ステップです。
step
1OpenRouterで鍵を作り、キット.htmlに貼る
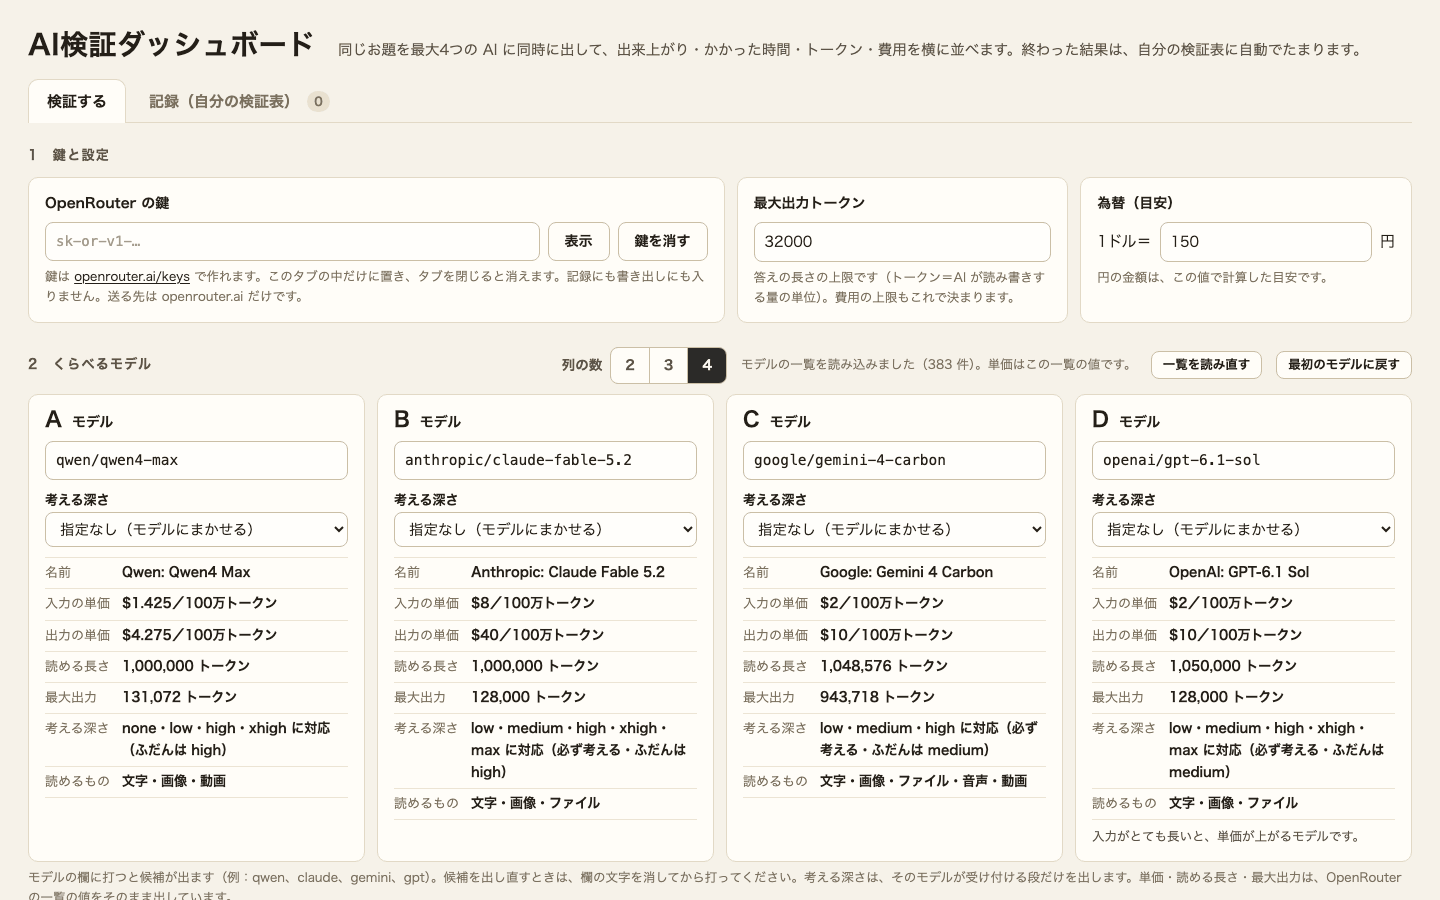
OpenRouterで鍵(AIを呼ぶための合言葉のような文字列)を作り、少し入金しておきます。届いたキット.htmlをダブルクリックで開き、いちばん上の「OpenRouterの鍵」の欄に貼ります。
step
2お題を選んで「全部同時に走らせる」を押す
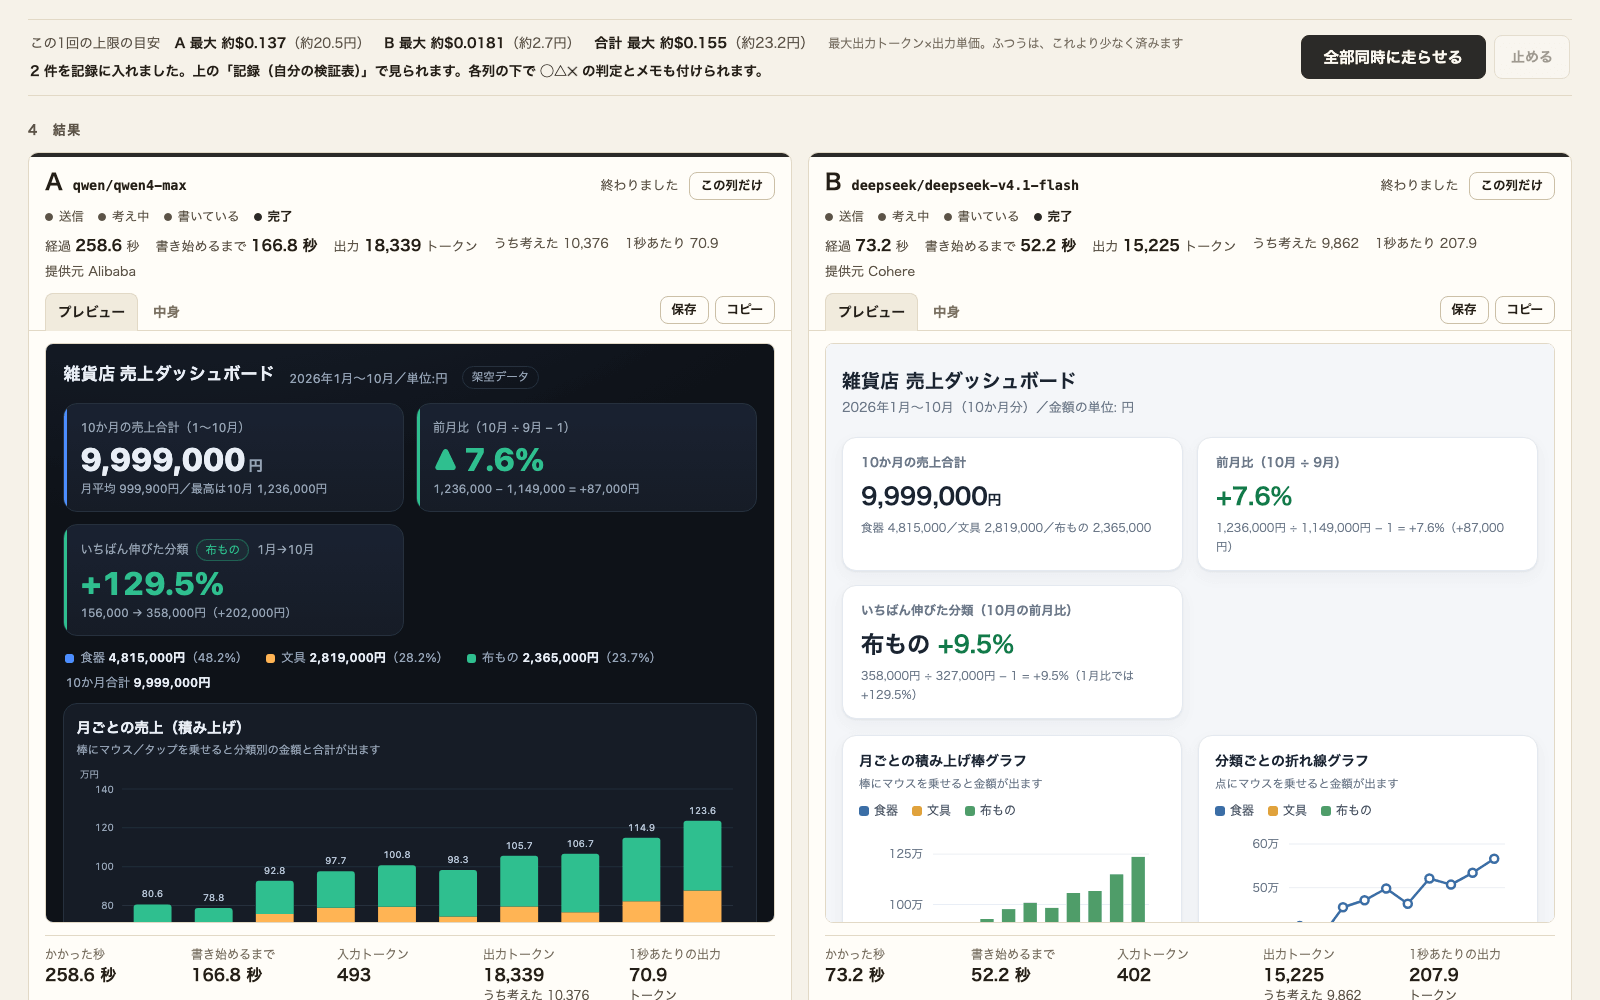
お題の見本のボタンを押すか自分で書き、「全部同時に走らせる」を押します。終わると出来上がりと、かかった秒・トークン・実際の費用が並び、結果は記録のタブに1行ずつたまります。初めてなら、答えの短い「お試し」のお題が早く安く終わります。
つまずく所|画面を作らせるお題は最大出力を3万2,000以上に
収録の前に本物のOpenRouterで試したところ、売上の表から1枚のダッシュボードを作るお題で、最大出力を1万6,000にすると考えるだけで上限が埋まり、途中で切れました。
| 最大出力 | 1万6,000 | 3万2,000 |
|---|---|---|
| かかった時間 | 248.0秒 | 258.6秒 |
| 出力(うち考えた分) | 16,000(13,967)で切れた | 18,339(10,376)で書き切った |
| 費用 | 0.0691ドル(約10円) | 0.0788ドル(約12円) |
| 出来 | 見出しと枠だけ | 合計・前月比・一番伸びた品目の3つとも正しい |
(2026年11月17日の実測・OpenRouter経由・Qwen4 Maxの考える深さはlow)
ダッシュボードの最大出力は、最初から3万2,000にしてあります。ただ、完成した版も前月比のプラスを「▲7.6%」と書いていたので(日本の帳票では▲はマイナスの印)、数字の向きは自分の目で確かめてください。
サイトを4つ開いて同じ文を貼り比べる手間を省きたい方は、公式LINEで合言葉「Qwen4」と送るとAI検証ダッシュボードを受け取れます。
よくある質問
Qwen4 Maxとは何ですか?何が新しいのですか?
Qwen4 Maxは、Alibabaが2026年11月16日に正式版を出したQwen4シリーズの最上位モデルです。2.4兆パラメータのうち1トークンごとに710億だけを使う作りで、文字・画像・動画を読め、一度に100万トークンまで扱えます。重みは非公開で、API経由で使います。
Qwen4 Maxの料金はいくらですか?無料で使えますか?
APIの料金は100万トークンあたり入力1.5ドル・出力4.5ドルで、出力はClaude Fable 5.2の約9分の1です。新規ならシンガポールのリージョンで100万トークンの無料枠(90日)があります。アプリのQwen Studioで無料で使えるかと回数は公表されていません。
Qwen4 MaxとClaude Fable 5.2・Gemini 4 Carbonはどちらを使うべきですか?
細かい仕様まで守る作り込みならFable 5.2、安く広く試すならQwen4 Maxです。同じ文面のゲーム11題はFable 5.2の7勝でした。一方、間取り図から3Dの家を作るお題では部屋12か所を全部正解し、費用はGemini 4 Carbonの約半分の約42円でした。
日本からQwen4 Maxを使うにはどうすればいいですか?
手軽なのはOpenRouterで、鍵を作って少し入金し、モデル名にqwen/qwen4-maxを指定します。AlibabaのQwenCloudでAPIの鍵を作る方法もあり、リージョンには東京もあります。Claude CodeやCursorで対話して使うだけなら、月6ドルからのToken Planも選べます。
中国のモデルを仕事で使っても大丈夫ですか?
公式は、APIの入出力を学習に使わず、保存は既定で30日以内と明記しています。ただし東京などのGlobalのリージョンでは中国本土の設備で計算されることがあるので、避けたい場合はシンガポールのリージョンを選び、個人の情報や社外秘は入れないのが安全です。
まとめ|Qwen4 Maxは安く広く試す係、最後の詰めはFable 5.2
Qwen4 MaxをFable 5.2・Gemini 4 Carbonと同じお題で試して分かったことをまとめます。
- 出力の単価はFable 5.2の約9分の1。ただし考える量が多く、値段は1題で比べる
- 間取り図の読み取りは部屋も窓も全部正解。1軒 約42円
- ゲームの作り込みはFable 5.2の7勝。Qwen4 Maxの勝ちは0
- 乗り換えずに、画像の読み取りと3Dの試作に足す
ベンチの点数だけを見ると微妙に見えますが、3Dのゲームや図面の読み取りのように、得意な題材ではかなり良い精度を出してくれます。まずはいつものお題を、Qwen4 Maxと今使っているモデルに同時に出して比べてみてください。
▶ YouTubeチャンネルで新しいモデルの実機検証を受け取る
▶ メンバーシップ(スタンダードAI ¥690/月)で実践的なAIの活用動画を受け取る
こちらの動画もおすすめ
-
-
Kimi K3.1 Proの使い方と料金|Opus 5.5と同じ10課題で比べた結果と日本から使う方法
続きを見る

