本ページはプロモーションが含まれています。
この記事でわかること
- Fish Audio Drama 3でできること
- 演技の指示と3人の掛け合いの書き方
- 料金と、APIで損しないための1行
- ElevenLabs・Geminiと聞き比べた日本語の結果
「僕が実際にFish Audio Drama 3で3人の掛け合いを作ったら、約30秒の会話劇が1回の生成・約4.5秒で出てきました」
YouTubeの寸劇やショートの掛け合いを作りたくても、声優さんを何人も頼むのは大変です。AIの声は棒読みになりがちで、日本語の読み間違いや料金、ElevenLabsとの違いも気になるところだと思います。Fish Audio Drama 3は、台本に書いた演技の指示どおりに声が演じ、何人もの掛け合いを1回で作れる新しい音声モデルです。
こんにちは、ルーティンラボ(@rutinelabo)です。本記事では、Fish Audio Drama 3の特徴と料金、演技の指示と掛け合いの書き方を解説します。あわせて、Gemini 3.8 Flash TTS・ElevenLabs v4との聞き比べと、自分の声のクローンで読ませた結果も紹介します。
この記事の演技の指示の書き方・3人の掛け合いのテンプレ・読み間違いの直し方(Drama 3 ボイスドラマ台本キット)は、公式LINEで合言葉「ひとり芝居」と送ると受け取れます。
プロンプト配布中
LINE公式アカウントを友達追加していただければ、本記事やYouTubeで使用した使用したプロンプトを配布いたします。メンバーシップ登録で優先サポートも実施中です。
結論|Fish Audio Drama 3は台本に書いた演技で何人もの声が演じ分ける音声AI
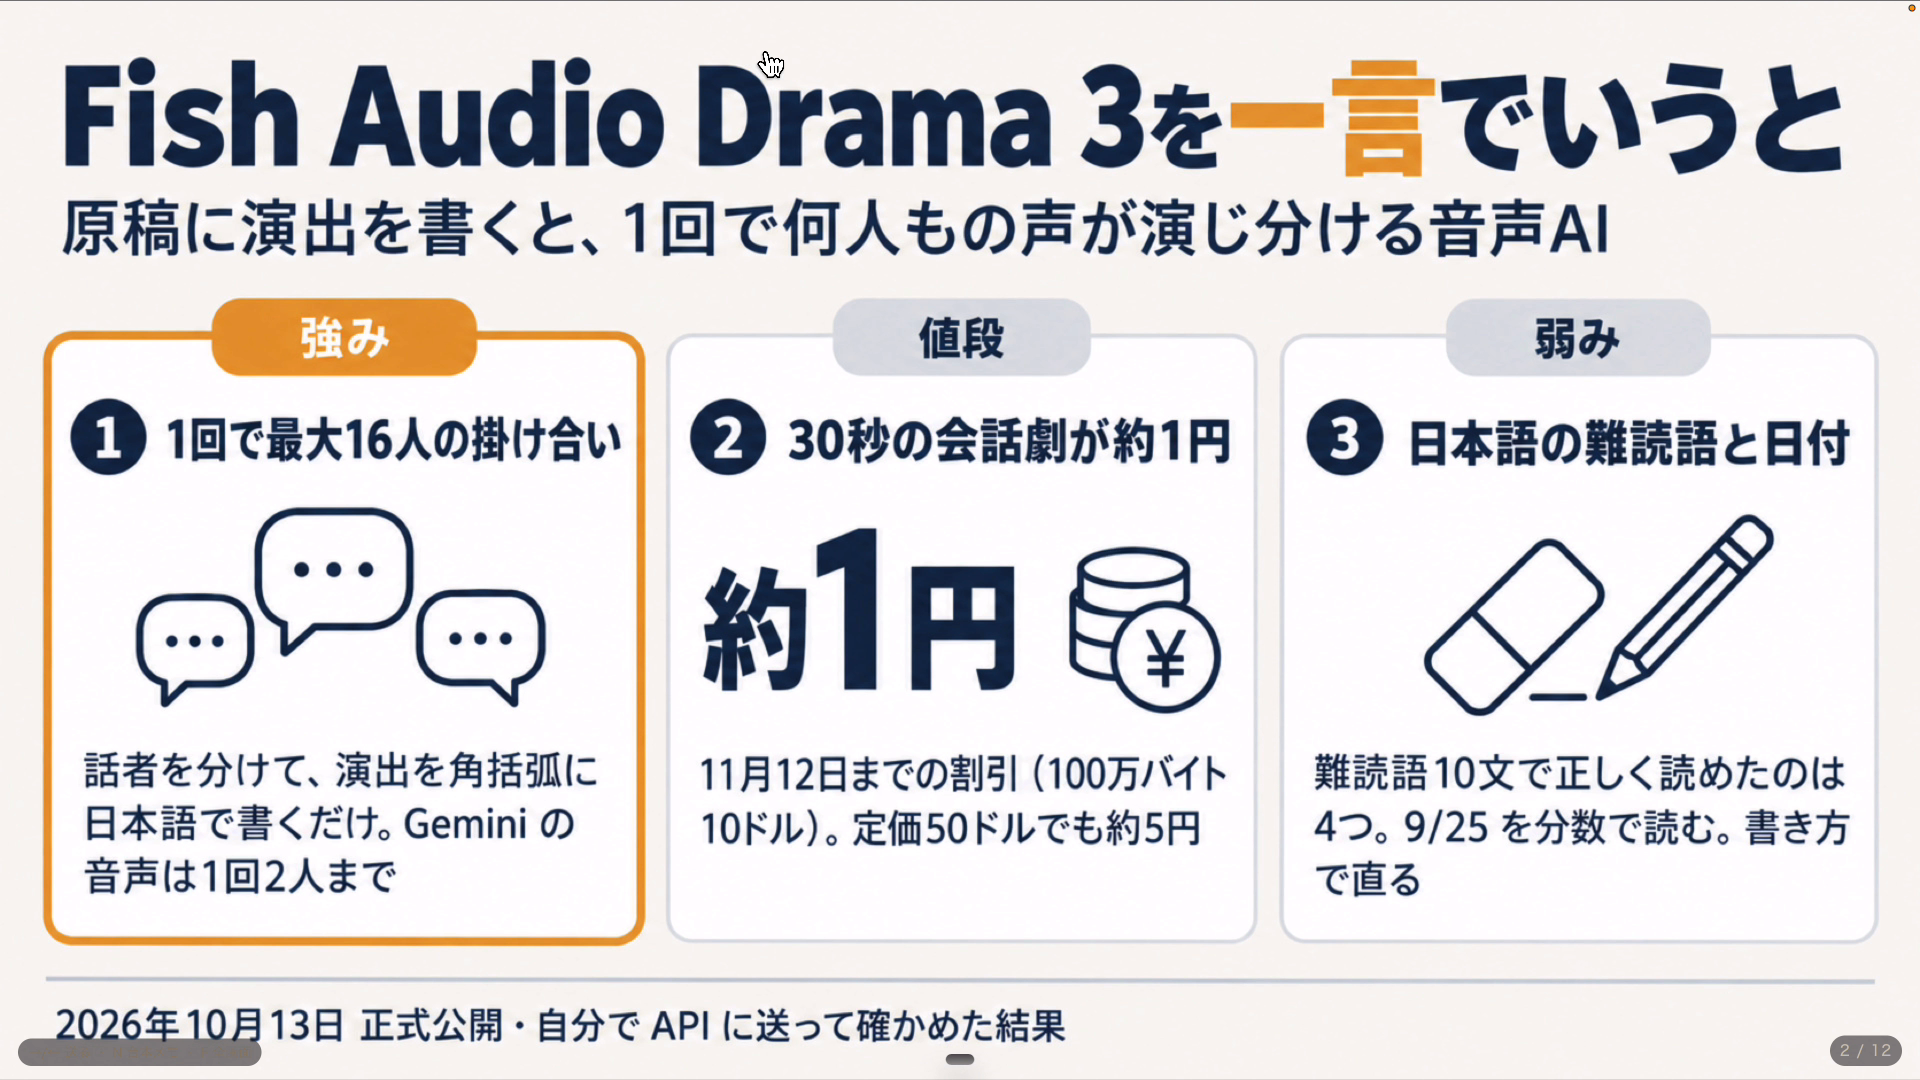
先に結論をお伝えします。Fish Audio Drama 3は、台本に書いた演技の指示どおりに声が演じ、1回の生成で最大16人の掛け合いまで作れる音声モデルです。僕が試した30秒の会話劇は、割引中(2026年11月12日まで)の料金で約1円、定価でも約5円でした。
ただし日本語の難読語や日付は苦手で、ニュースのようなふつうの読み上げは、Gemini 3.8 Flash TTSやElevenLabs v4とほとんど差がありませんでした。演技と掛け合いが要る場面で選ぶと、良さがいちばん生きるモデルです。
| 見るところ | ポイント |
|---|---|
| できること | 角かっこ[ ]に書いた演技の指示どおりに読む。1回の生成で最大16人の掛け合い |
| 料金 | APIは100万バイトあたり50ドル。2026年11月12日までは80%引きの10ドル(2026年10月時点) |
| 日本語 | ふつうの読み上げは他社とほぼ同じ。難読語と日付は書き方で直す |
| 注意点 | 掛け合いは声が入れ替わる行がある。APIはmodelヘッダの1行を忘れない |
Fish Audio Drama 3とは|台本に一言で演技が変わる新しい音声モデル
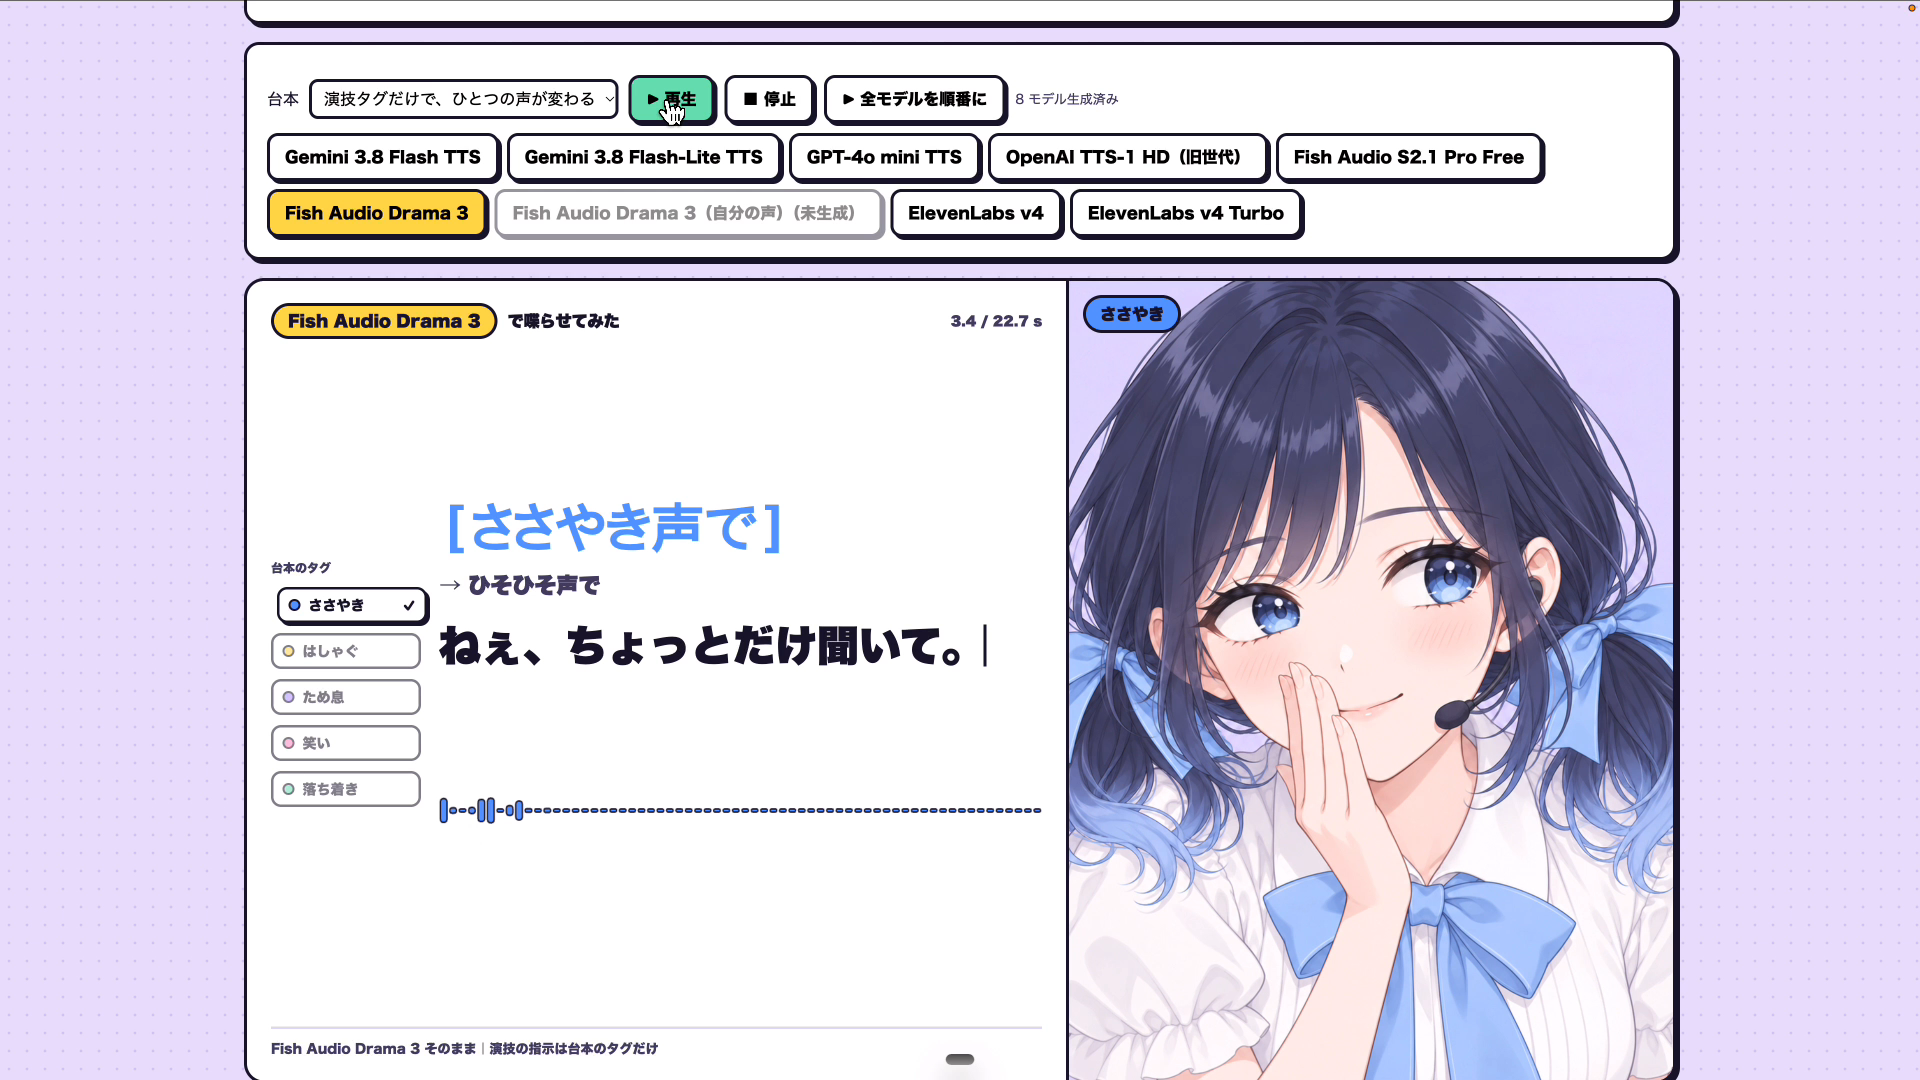
Fish Audio Drama 3は、音声AIのFish Audioが2026年10月13日に正式公開した読み上げモデルです。台本の中に[ささやき声で]のような演技の指示を一言書くだけで、ひとつの声がその指示どおりに演じ分けます。
台本に一言書くだけで、声の演技が変わった!
Fish Audio Drama 3 で、ささやき・はしゃぐ・ため息・笑いを1つの声に演じさせてみました。
はしゃぐ声にはささやきが少し残る。それでも寸劇の声なら、僕はこれを使う。
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
動画の冒頭では、ひとつの声に、ささやき・はしゃぐ・ため息・笑い・落ち着きの5つの演技を続けて切り替えさせました。指示の文は読み上げられず、声の調子だけが変わります。ささやき・ため息・笑いは聞き分けられた一方で、はしゃぐ声と落ち着いた声には前のささやきの調子が残りました(AIに聞かせた判定・1回)。
| 新しくなったところ | 中身 |
|---|---|
| 演技を文章で指示 | 角かっこ[ ]に自然な文で書く。英語でも日本語でもよい |
| 言葉だけを変えるタグ | whisper(ささやき)・emphasis(強調)・slow(ゆっくり)などで囲んだ言葉だけが変わる |
| 掛け合い | 話者タグで声を分け、1つの台本に最大16人(Gemini 3.8 Flash TTSは2人) |
| 使える場所 | Webのテキスト読み上げ・スマホアプリ・API(モデル名はdrama-3)。モデルの重みも公開 |
出典:Fish Audio公式ブログ・Drama 3のドキュメント・Hugging Faceのモデルカード・Gemini APIのドキュメント(2026年10月時点・公式参照)
1年前の世代と比べて変わったのは演技と掛け合い
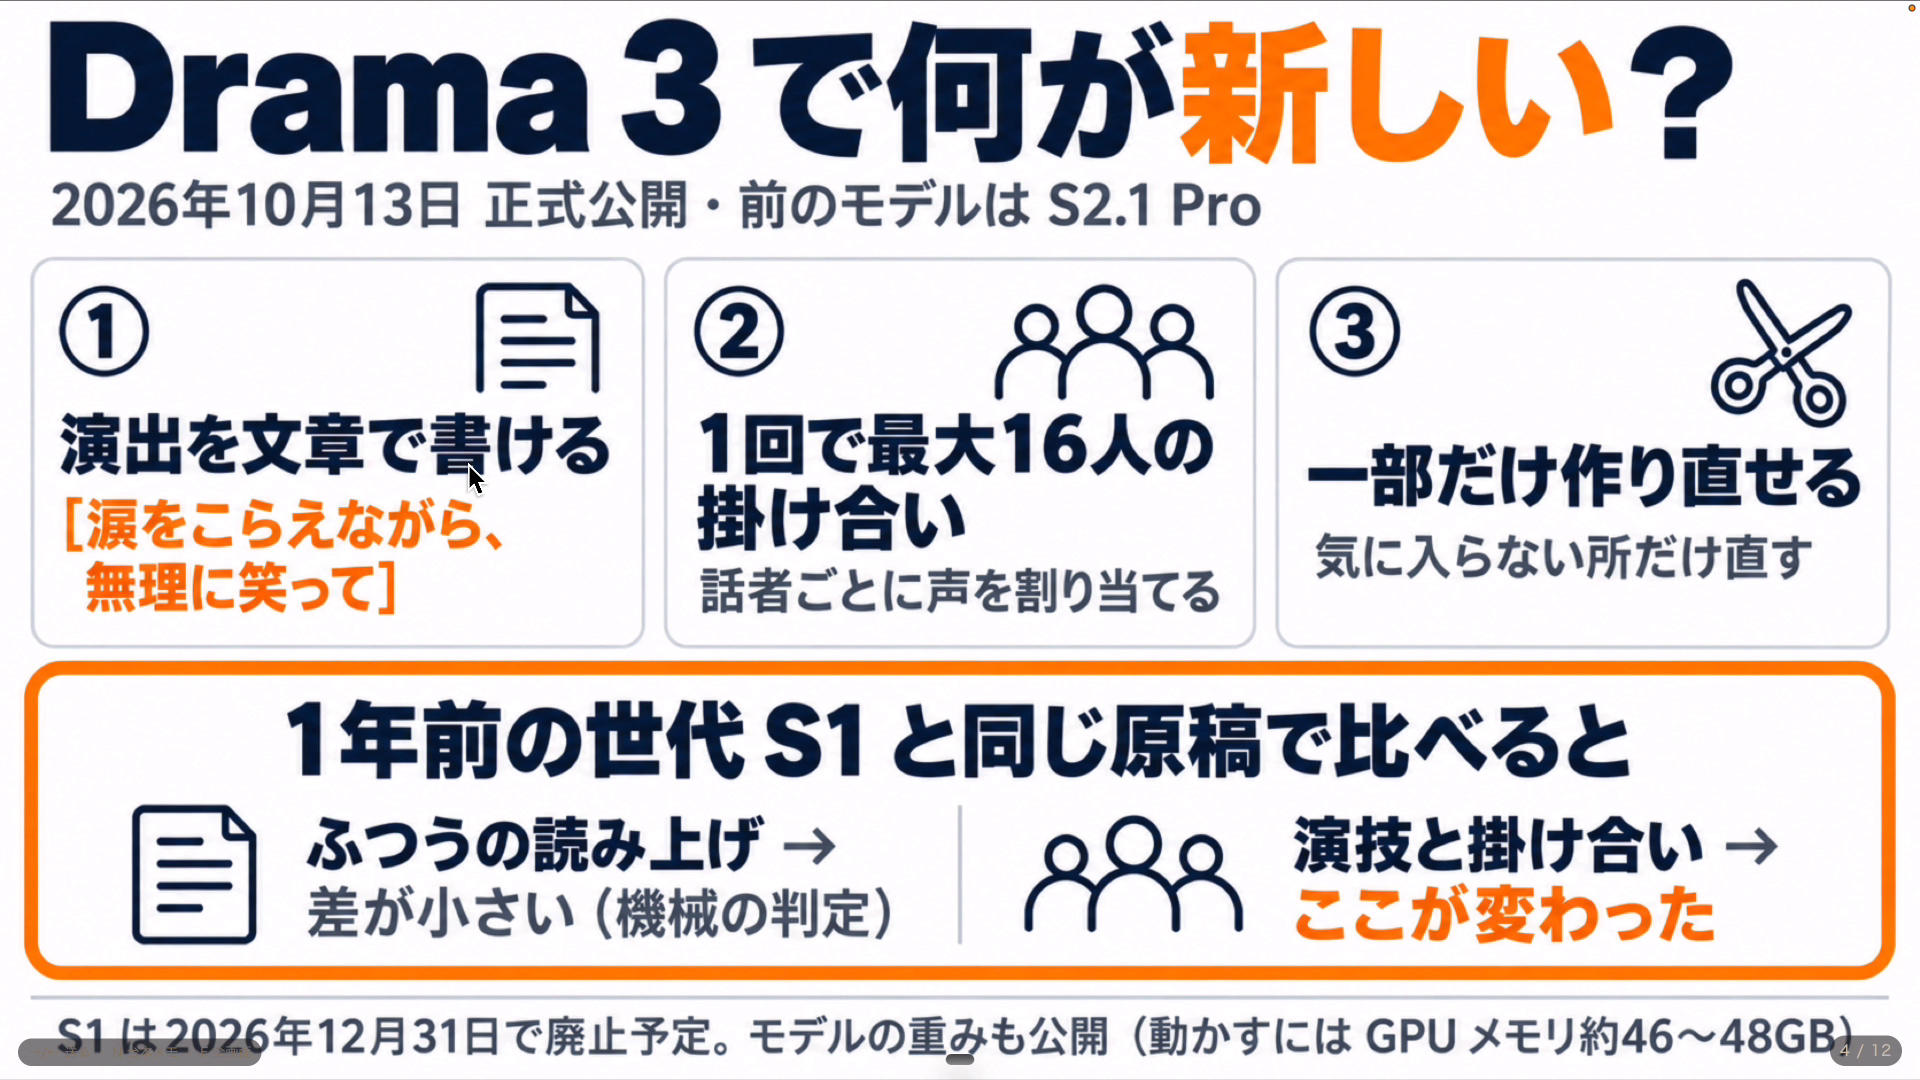
僕は1年以上前からFish Audioを、動画のオープニングでアバターに話させるときなどに使ってきました。1年前の世代(S1)とDrama 3に同じナレーション原稿を読ませると、ふつうの読み上げはAIに聞かせた判定で差が出ませんでした。
変わったのは演技です。自分の声に「大丈夫です。もう、慣れましたから。」と読ませると、指示なしでは平坦な2.85秒でした。そこに[涙をこらえながら、無理に笑って]と書き足すと、間の入った4.02秒の苦笑いに変わりました。
前回はElevenLabs v4にも、タグで同じように演技をさせています。タグの書き方の違いは、ElevenLabs v4の使い方の記事で紹介しています。
-
-
ElevenLabs v4の使い方|日本語ナレーションをタグで演技させる・Geminiと聞き比べ
続きを見る
Fish Audio Drama 3の料金|無料プランとAPIの単価、数えるのは文字ではなくバイト
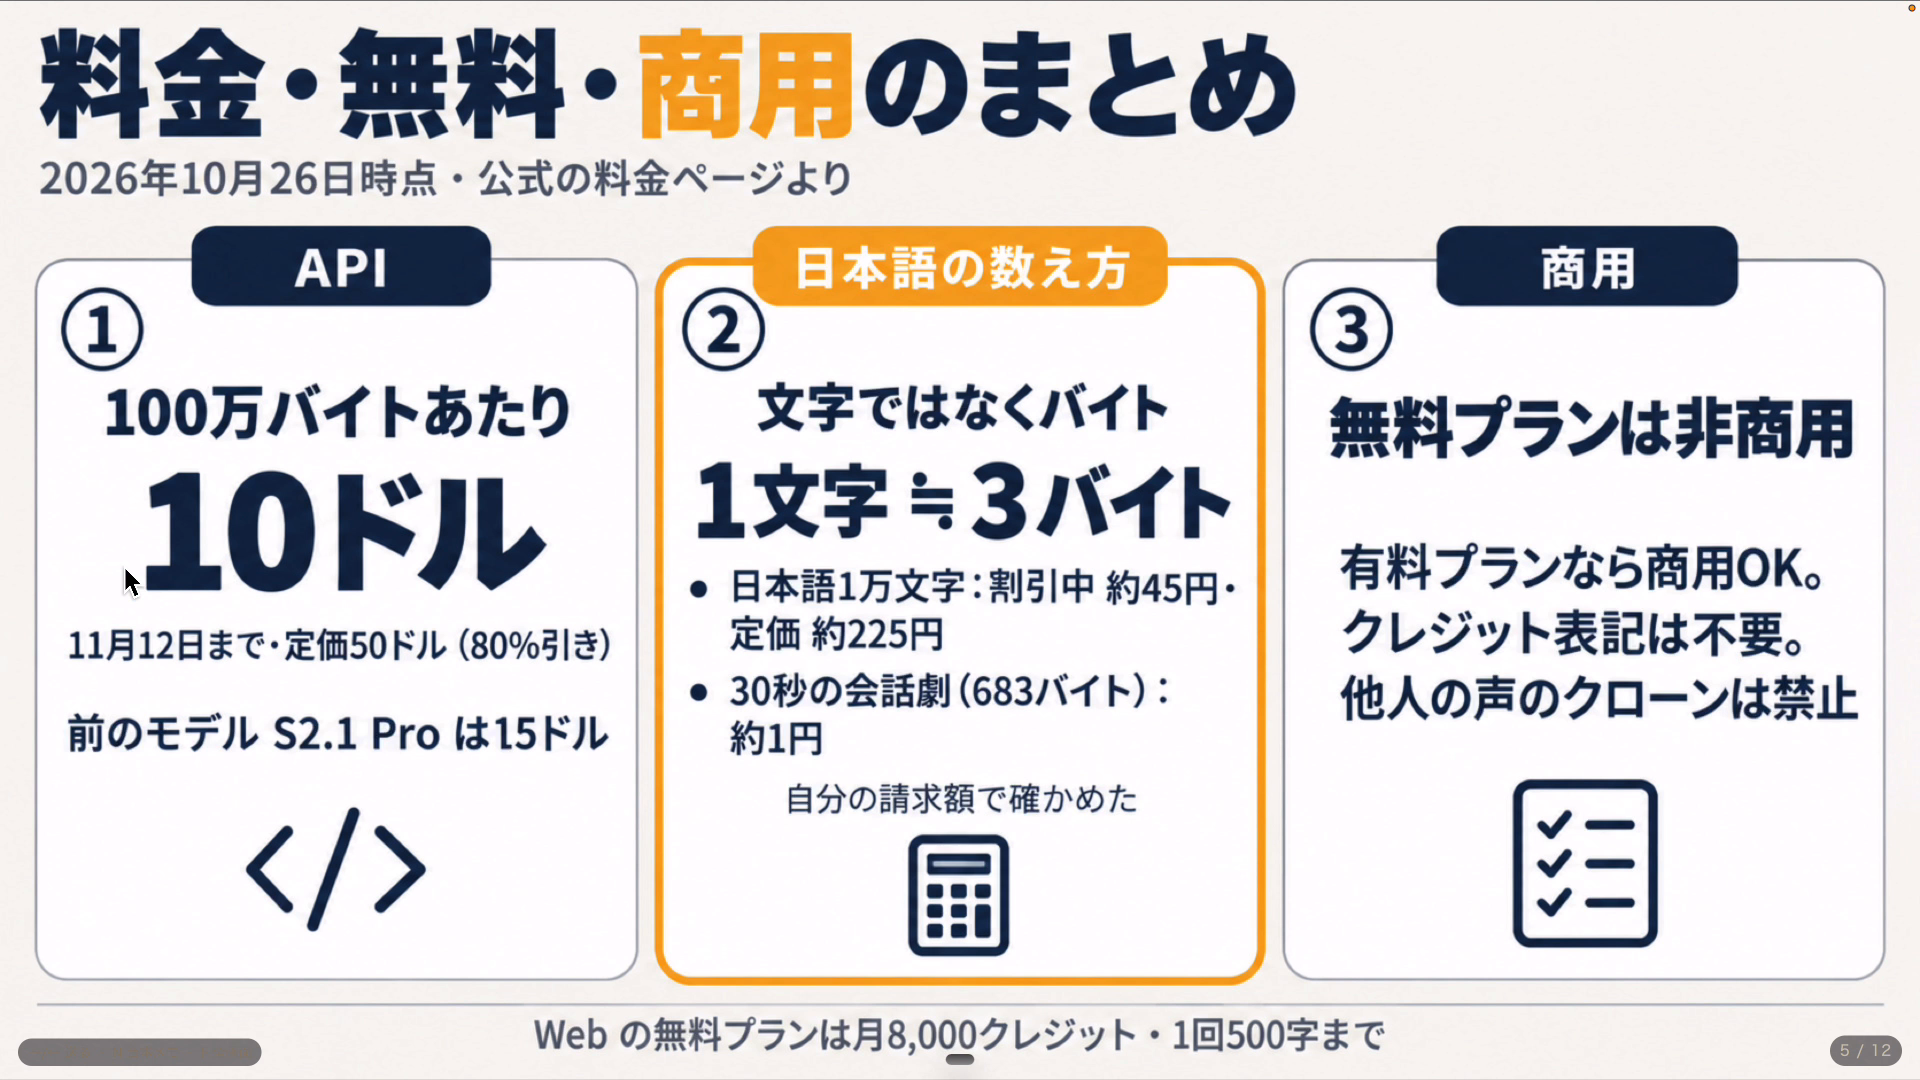
APIの料金は、読み上げる原稿100万バイトあたりの従量課金です。Drama 3の定価は50ドルで、2026年11月12日(日本時間は11月13日の午前2時)までは80%引きの10ドルで使えます。Webで使う場合は月ごとのクレジット制で、Drama 3もS2.1 Proと同じクレジットで使えます。
| 使い方 | 料金 |
|---|---|
| API(Drama 3) | 100万バイトあたり50ドル。2026年11月12日までは10ドル(80%引き) |
| API(前のモデルS2.1 Pro) | 100万バイトあたり15ドル |
| Web 無料プラン | 月8,000クレジット・1回500字まで。生成した音声は個人の非商用だけ |
| Web Plusプラン | 年払い132ドル(月あたり11ドル)・月25万クレジット・商用利用できる |
| Web Proプラン | 年払い900ドル(月あたり75ドル)・月200万クレジット |
出典:Fish Audio「Pricing and rate limits」・料金プラン(2026年10月時点・公式参照)
注意したいのは、数えるのが文字ではなくバイトだという点です。発表ブログは100万文字、ドキュメントは100万バイトと書いていて食い違っていたので、自分の請求額で確かめたところ、バイトで計算した額と一致しました。日本語は1文字がおよそ3バイトなので、文字で数えるより約3倍かかります。
| 原稿 | 割引中(11月12日まで) | 定価 |
|---|---|---|
| 30秒の3人の会話劇(683バイト) | 約1円 | 約5円 |
| 日本語1万文字(約3万バイト) | 約45円 | 約225円 |
出典:ルーティンラボの計測(2026年10月26日・実際の請求額で確認・1ドル150円で換算)
無料プランの商用利用は、料金ページの機能の一覧とよくある質問で書き方が違っていました。YouTubeなどで収益化する動画に使うなら、有料プランを選んでおくと安心です。
Fish Audio Drama 3の使い方|演技の指示と3人の掛け合いの書き方
Webで試すなら、Fish Audioの公式サイトのテキスト読み上げから始められます。最近の僕は画面を操作するよりAPIで使うことが多いのですが、まずはWebで演技の指示の効き方をつかむのがおすすめです。
step
1公式サイトでテキスト読み上げを開く
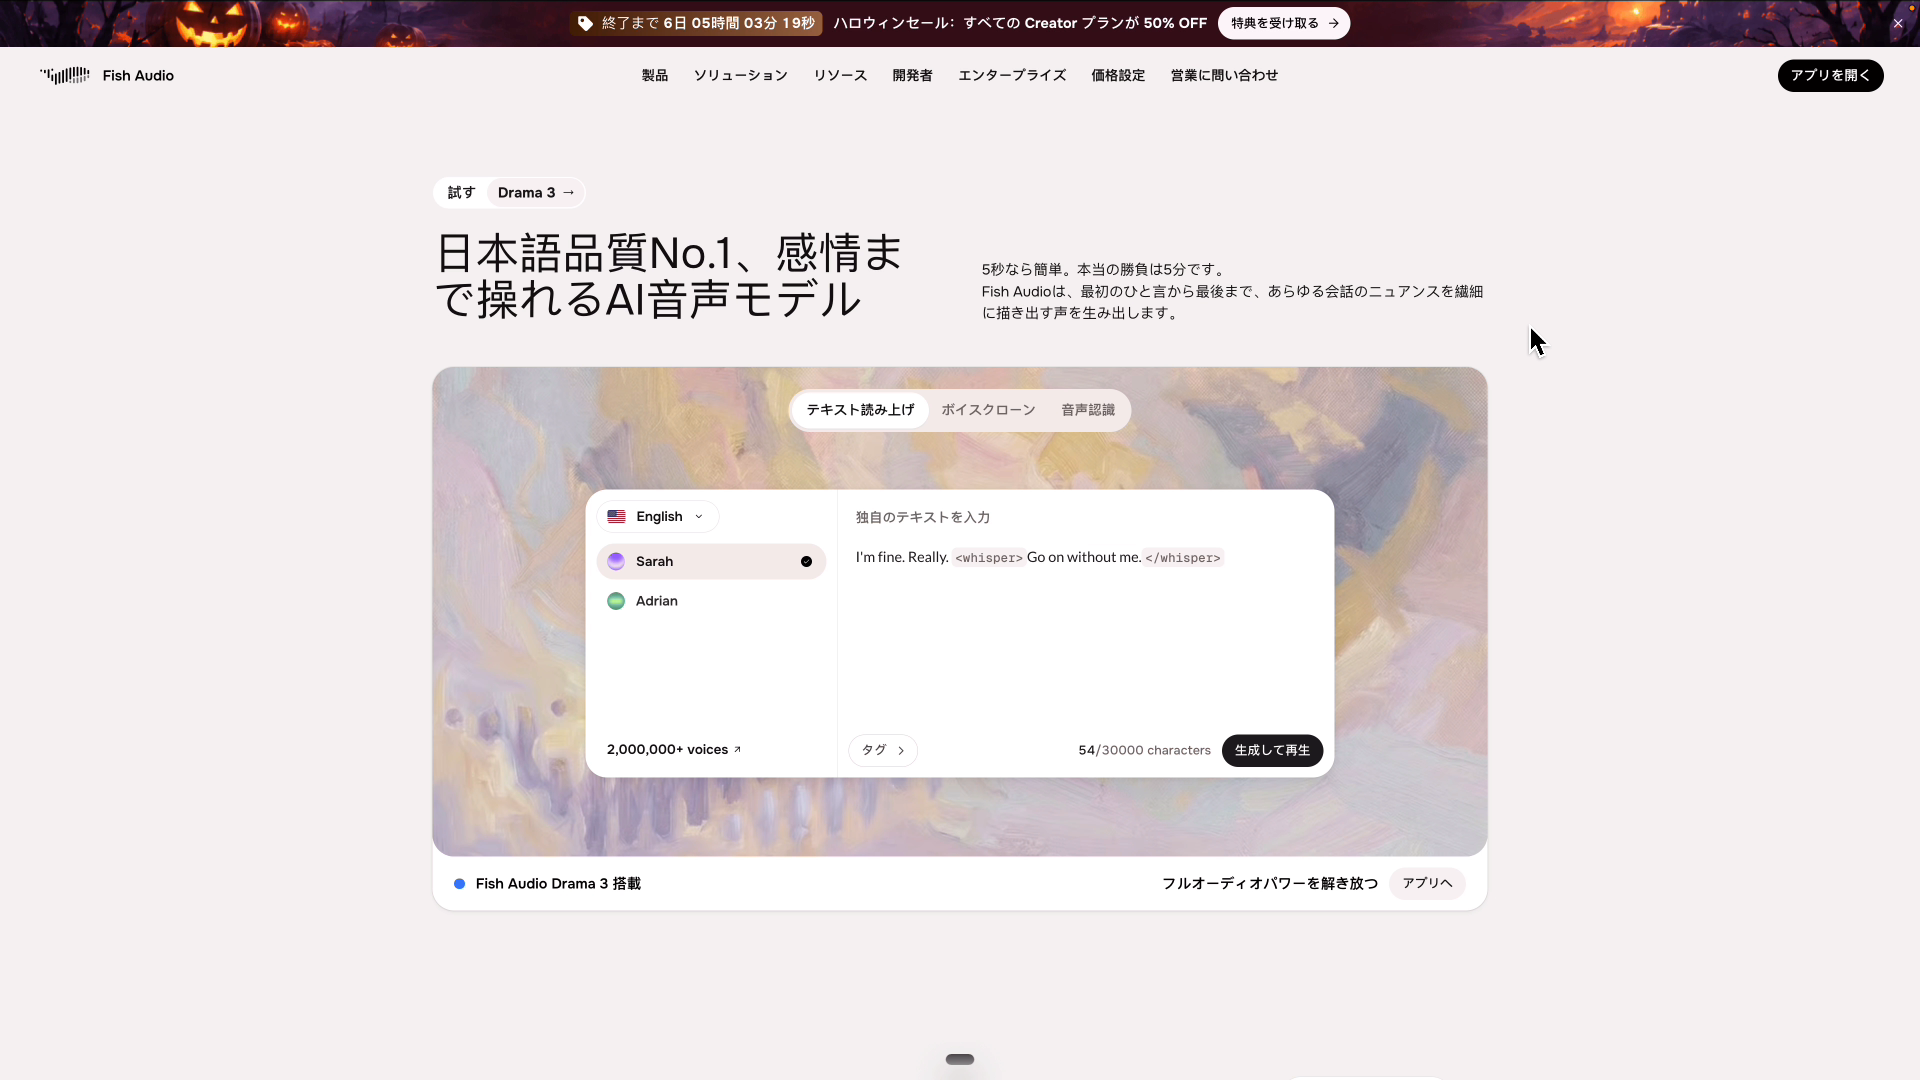
公式サイトのトップの読み上げ欄で、Drama 3の声をその場で試せます。本格的に作るときは、公式のDrama 3紹介ページにある無料で試すボタンからテキスト読み上げを開くと、Drama 3が選ばれた状態で始められます。
step
2話者を追加して、役ごとに声を選ぶ
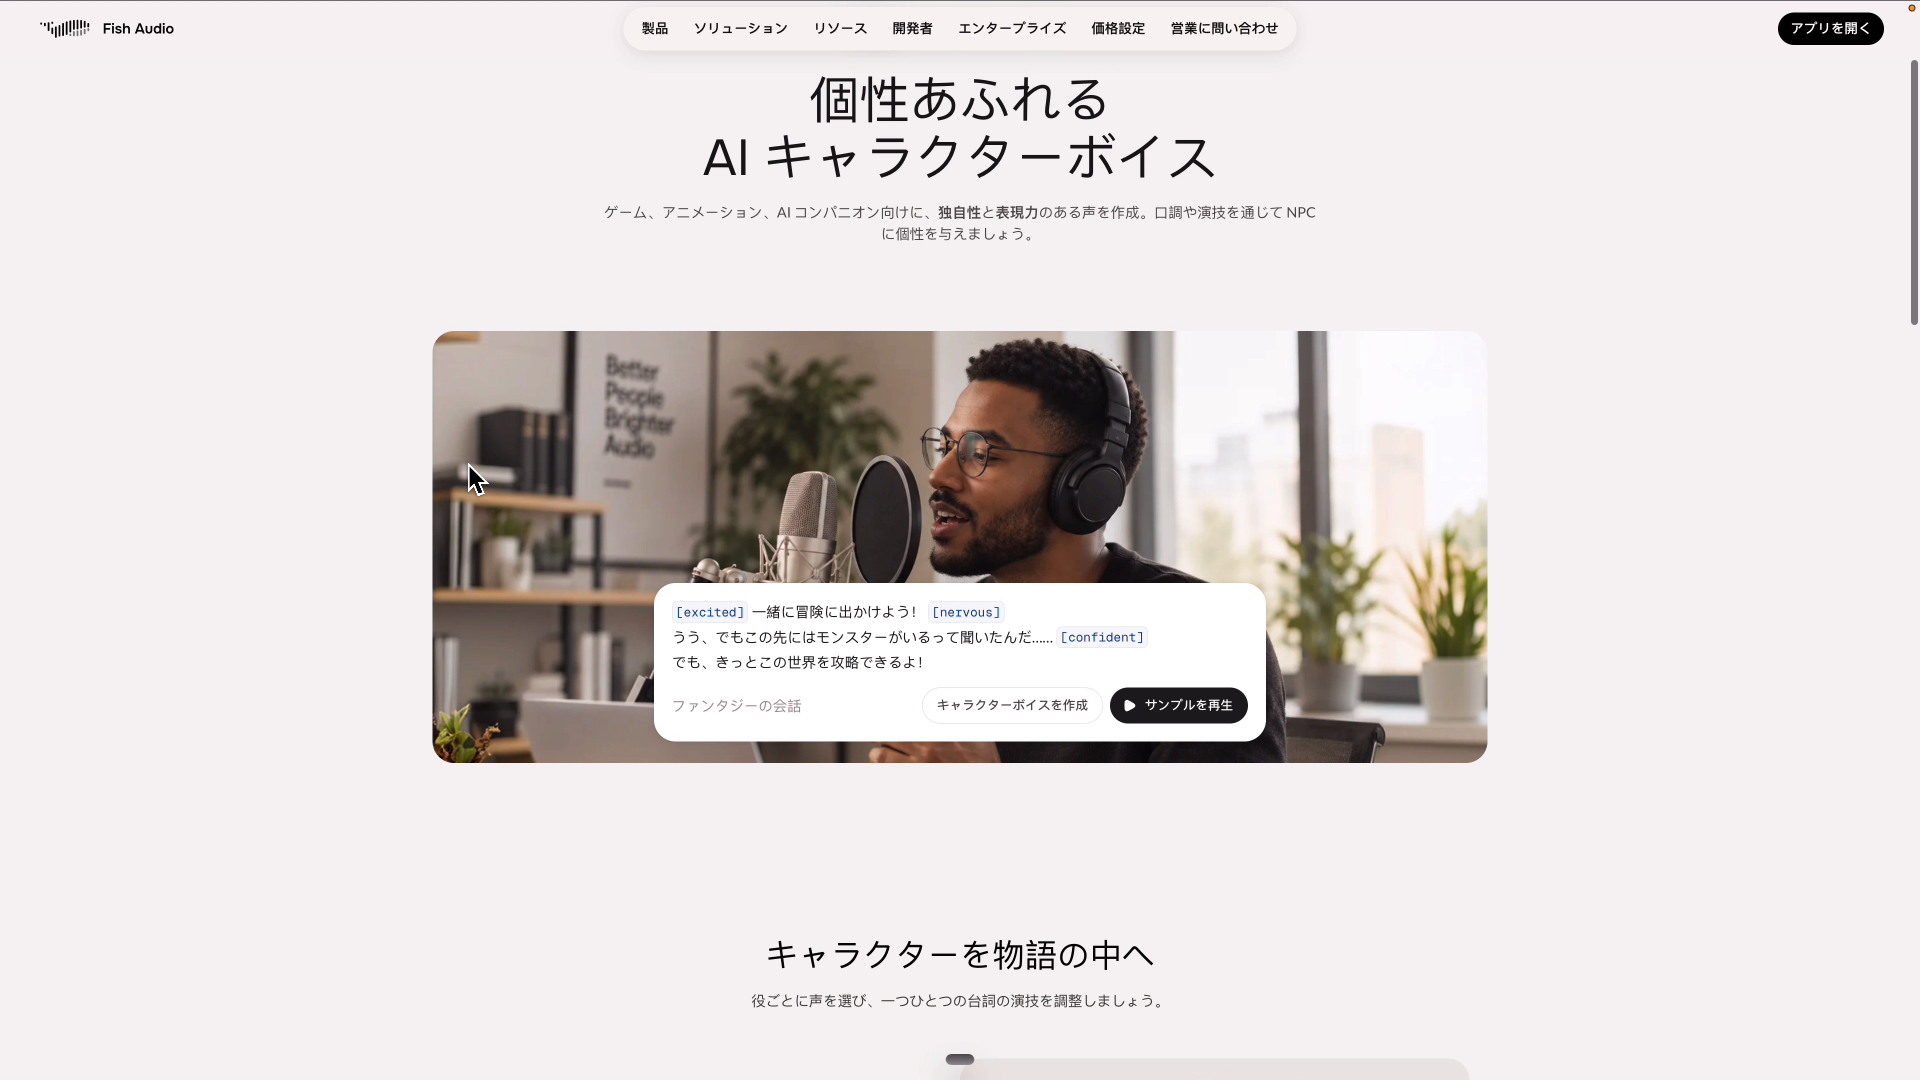
テキスト読み上げのエディターで話者を追加し、役ごとに声を割り当てます。声はVoice Libraryの200万以上の声から選べて、アニメ調のキャラクターボイスや、重みのある男性のナレーションのような声も最初からそろっています。
step
3台本に演技の指示を書いて生成する
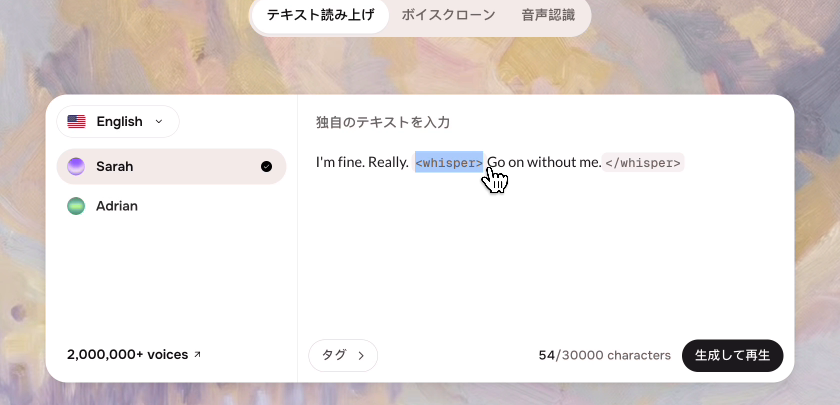
演技は角かっこ[ ]に日本語で書き、ささやかせたい言葉だけをwhisperのタグで囲みます。僕が試した3人の台本はこちらです。APIでは行の頭の話者タグで声を分けます。Webでは、エディターで話者ごとに声を選んで会話文を書けば、同じように会話全体をまとめて作れます。
<|speaker:0|>[小声で、焦りを隠しきれずに] あと5分で本番です。台本、まだ届いてないんですけど。
<|speaker:1|>[のんきに、少し笑って] 大丈夫です。AIに書かせてるので。
<|speaker:2|>[申し訳なさそうに、ため息まじりに] …すみません。そのAI、さっきからずっと「考え中」のままです。
<|speaker:0|>[一拍おいて、怒りをこらえながら] ……考え中?
<|speaker:1|>[急に真顔になって] <whisper>皆さん、落ち着いて聞いてください。今日の台本は、ありません。</whisper>
<|speaker:2|>[こらえきれずに吹き出して] いや、言い方!
この6行(683バイト)で、約30秒の会話劇が約4.5秒で出てきました。焦り・ため息・ささやき・ツッコミの笑いはしっかり効いた一方で、[のんきに、少し笑って]は平坦に聞こえました(AIに聞かせた判定)。
演技の指示を書くときのコツ
- 指示は日本語で書いてよく、読み上げはされない
- 掛け合いは2〜3テイク作り、声が入れ替わっていない本を選ぶ(5テイク中3テイクで入れ替わる行があった)
- 何を書けばいいか迷ったら、公式の自動タグ付けで指示を足してから直す
APIで使うならmodel: drama-3の1行を忘れない
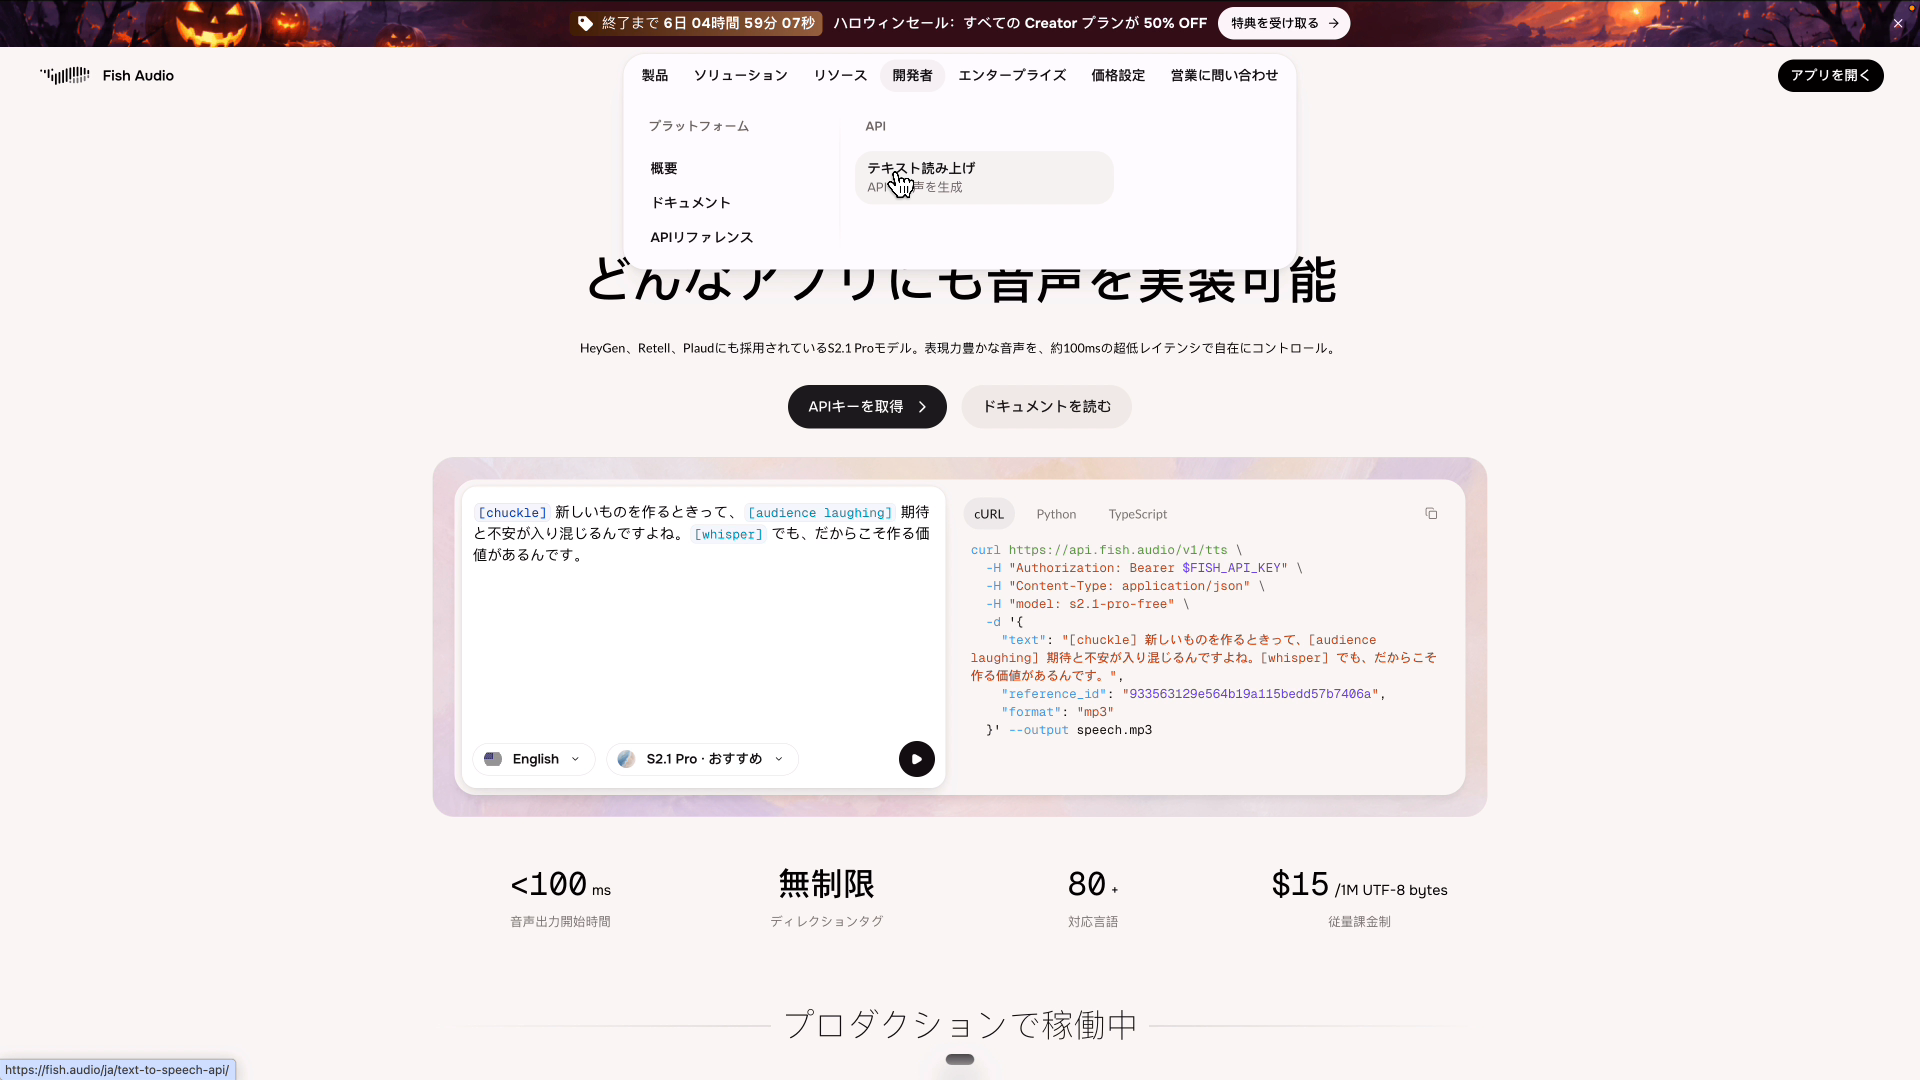
僕自身はAPIで使っています。開発者向けメニューのテキスト読み上げAPIのページでAPIキーを発行すれば、Claude CodeやCodexに頼んで組み込むこともできます。キーは.envファイルで管理し、使う上限のクレジットも決めておくと、セキュリティと費用の両方を守れます。
curl https://api.fish.audio/v1/tts \
  -H "Authorization: Bearer $FISH_API_KEY" \
  -H "Content-Type: application/json" \
  -H "model: drama-3" \
  -d '{"text": "[ささやき声で] 今日の台本は、ありません。", "reference_id": "声のID", "format": "mp3"}' \
  --output speech.mp3
- modelヘッダが無い・綴りが違うと、エラーにならず前のモデルS2.1 Proで作られる(公式ドキュメントに記載)
- 付け忘れて試したら、女性の「考え中?」が男性の声になり、ささやきも効かなかった
- 料金もS2.1 Proの単価(100万バイトあたり15ドル)で引かれ、割引中なら1.5倍払うことになる
エラーが出ないので、付け忘れても気づきにくいのが怖いところです。掛け合いの声がおかしいと感じたら、まずヘッダの1行を確かめてください。
Fish Audio Drama 3の評価|声の好みは10位、発音の正確さは1位(英語)
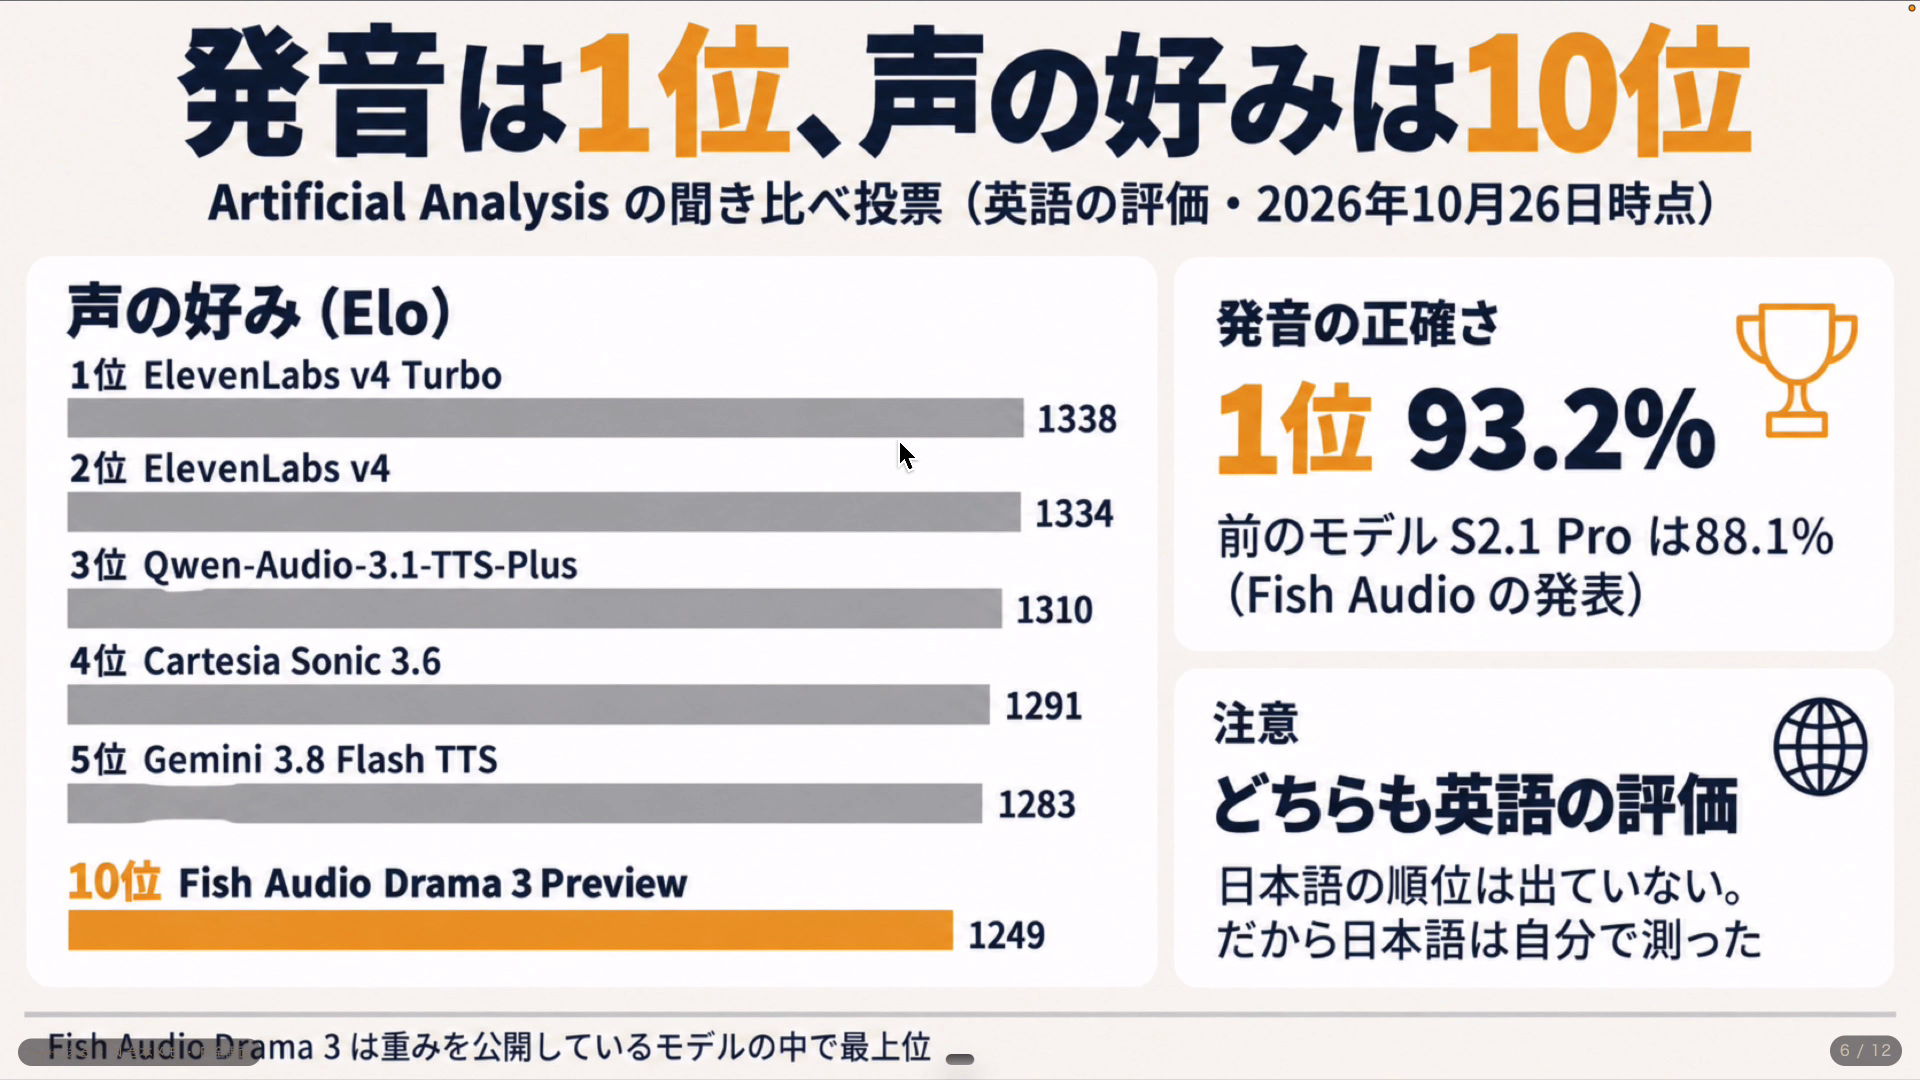
第三者の評価も見てみます。AIの音声を人が聞き比べて投票するArtificial Analysisのランキングでは、Drama 3(プレビュー版)は声の好みで10位でした。一方でFish Audioの発表では、英語の発音の正確さを測るテストで、Drama 3が93.2%と1位になっています。
| 評価 | Fish Audio Drama 3 | 比べる相手 |
|---|---|---|
| 声の好み(聞き比べ投票) | 10位(Elo 1249・重みを公開したモデルで最上位) | 1位 Eleven v4 Turbo(1338)・2位 Eleven v4(1334)・5位 Gemini 3.8 Flash TTS(1283) |
| 発音の正確さ | 93.2%で1位 | 前のモデルS2.1 Proは88.1% |
出典:Artificial Analysis(2026年10月26日時点)・Fish Audio公式ブログ(2026年10月時点・公式参照)
どちらも英語の音声での評価で、日本語の順位は出ていません。海外の比較記事には、ElevenLabsのほうが人間らしく話すという声もありました。ただ、僕が使ってみた感じでは、日本語の表現は前のモデルよりかなり良くなっています。
音声AIで読み上げを聞き比べ|Gemini 3.8・ElevenLabs v4と同じ原稿で比較
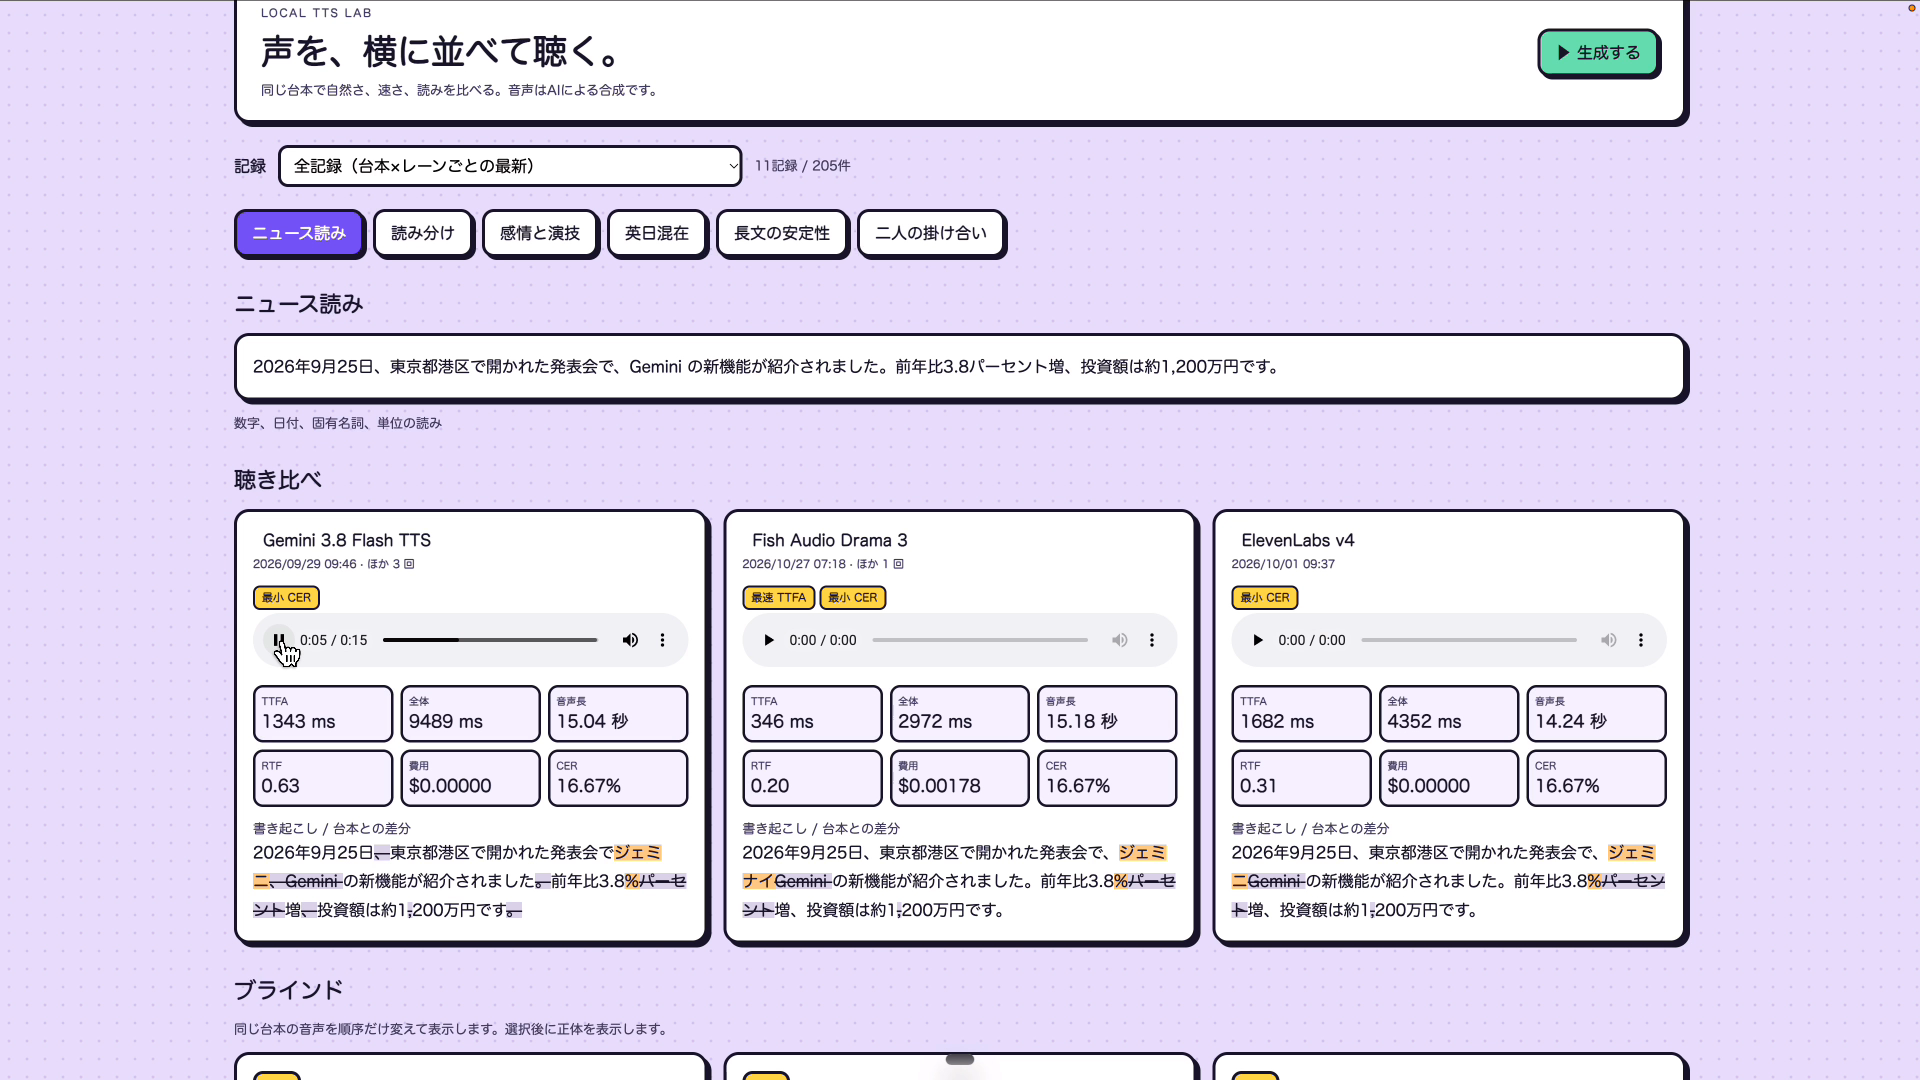
同じニュース原稿を、Gemini 3.8 Flash TTS・ElevenLabs v4・Drama 3の順に読ませました。ニュースの読み上げは、正直なところ3つともほとんど差がありませんでした。気になったのは、Drama 3だけがGeminiを英語読みの「ジェミナイ」と読んだことです。
同じニュース原稿を、Gemini と Fish Audio Drama 3 で読み比べ。
ほぼ互角。でも Drama 3 は Gemini をジェミナイと英語読みで、ちょっと笑った。
難読語10文は4つ。日付や固有名詞だらけの原稿は、ほかの声と使い分けます。
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
| 読ませた原稿 | 聞き比べた結果 |
|---|---|
| ニュース(日付・地名・Gemini) | 3つともほぼ同じ。Drama 3はGeminiを英語読みにした |
| 読み分け(生物・上手・市場・人気・重複) | 以前のモデルのように続けて読まず、1文ずつ区切って感情を込めて読んだ(Geminiと比べた僕の感想) |
| 英単語まじり(Claude Code・GPT-6・TTFB・WAV) | WAVの読み方など細かい差だけで、精度はほぼ同じ |
| 2人の掛け合い | 声の切り替えも自然で、問題なかった |
| 声が出始めるまで | Drama 3は0.26〜0.42秒。ElevenLabs v4は1.0〜1.7秒、Gemini 3.8は1.3〜1.6秒 |
出典:ルーティンラボの聞き比べと計測(2026年10月26日〜27日・各1回。ElevenLabs v4とGemini 3.8は別の日に計測)
難読語10文は4つ正解|日本語の読み間違いの直し方
撮影前に、前回のElevenLabs v4、前々回のGemini 3.8 Flash TTSと同じ難読語10文を、Drama 3にも読ませました。正しく読めたのはDrama 3が10文中4つ、ElevenLabs v4が7つ、Gemini 3.8 Flash TTSが6つです。英語の発音は1位でも、日本語の難読語は3つの中でいちばん少ない結果でした。
| 言葉(正しい読み) | Drama 3 | ElevenLabs v4 | Gemini 3.8 Flash TTS |
|---|---|---|---|
| 東雲(しののめ) | ×(ヒガシ) | ○ | ×(シモノメ) |
| 十六夜(いざよい) | ×(ジューロクヤ) | ○ | ×(ヨナズキ) |
| 東海林(しょうじ) | ×(トウカイリ) | × | × |
| 御御御付け(おみおつけ) | ×(オミモツケ) | × | × |
| GPT-6 | ×(ロク) | ×(ロク) | ○ |
| 9/25(くがつにじゅうごにち) | ×(分数の読み方) | ○ | ○ |
出典:ルーティンラボの計測(Drama 3は2026年10月26日・ElevenLabs v4は9月30日・Gemini 3.8 Flash TTSは9月25日・各1回・AIの書き起こしで判定)。生物(なまもの)・月極・一日(ついたち)・Claude Codeは3つとも正しく読めました。
特に気になったのは日付で、9/25を2回とも分数のように読みました。直し方はシンプルで、難読語はひらがなに、日付は漢字に書き直します。
しののめの空が、少しずつ明るくなってきました。
今夜はいざよいの月がきれいですね。
発表は九月二十五日の午後でした。
こう書き直すと、3つとも正しく読みました。とはいえ、日付や難読語の多い台本を毎回直すのは手間です。10語の結果と直し方の一覧をまとめたので、コピー用の全文は公式LINEで合言葉「ひとり芝居」と送ると受け取れます。
Gemini 3.8 Flash TTSのほうは、8つの音声モデルを聞き比べたGemini 3.8 Flash TTSの使い方の記事で詳しく紹介しています。
-
-
Gemini 3.8 Flash TTSの使い方|AI音声8モデル聞き比べと料金
続きを見る
自分の声のクローンでも同じ台本を読める|解説資料のナレーションにも
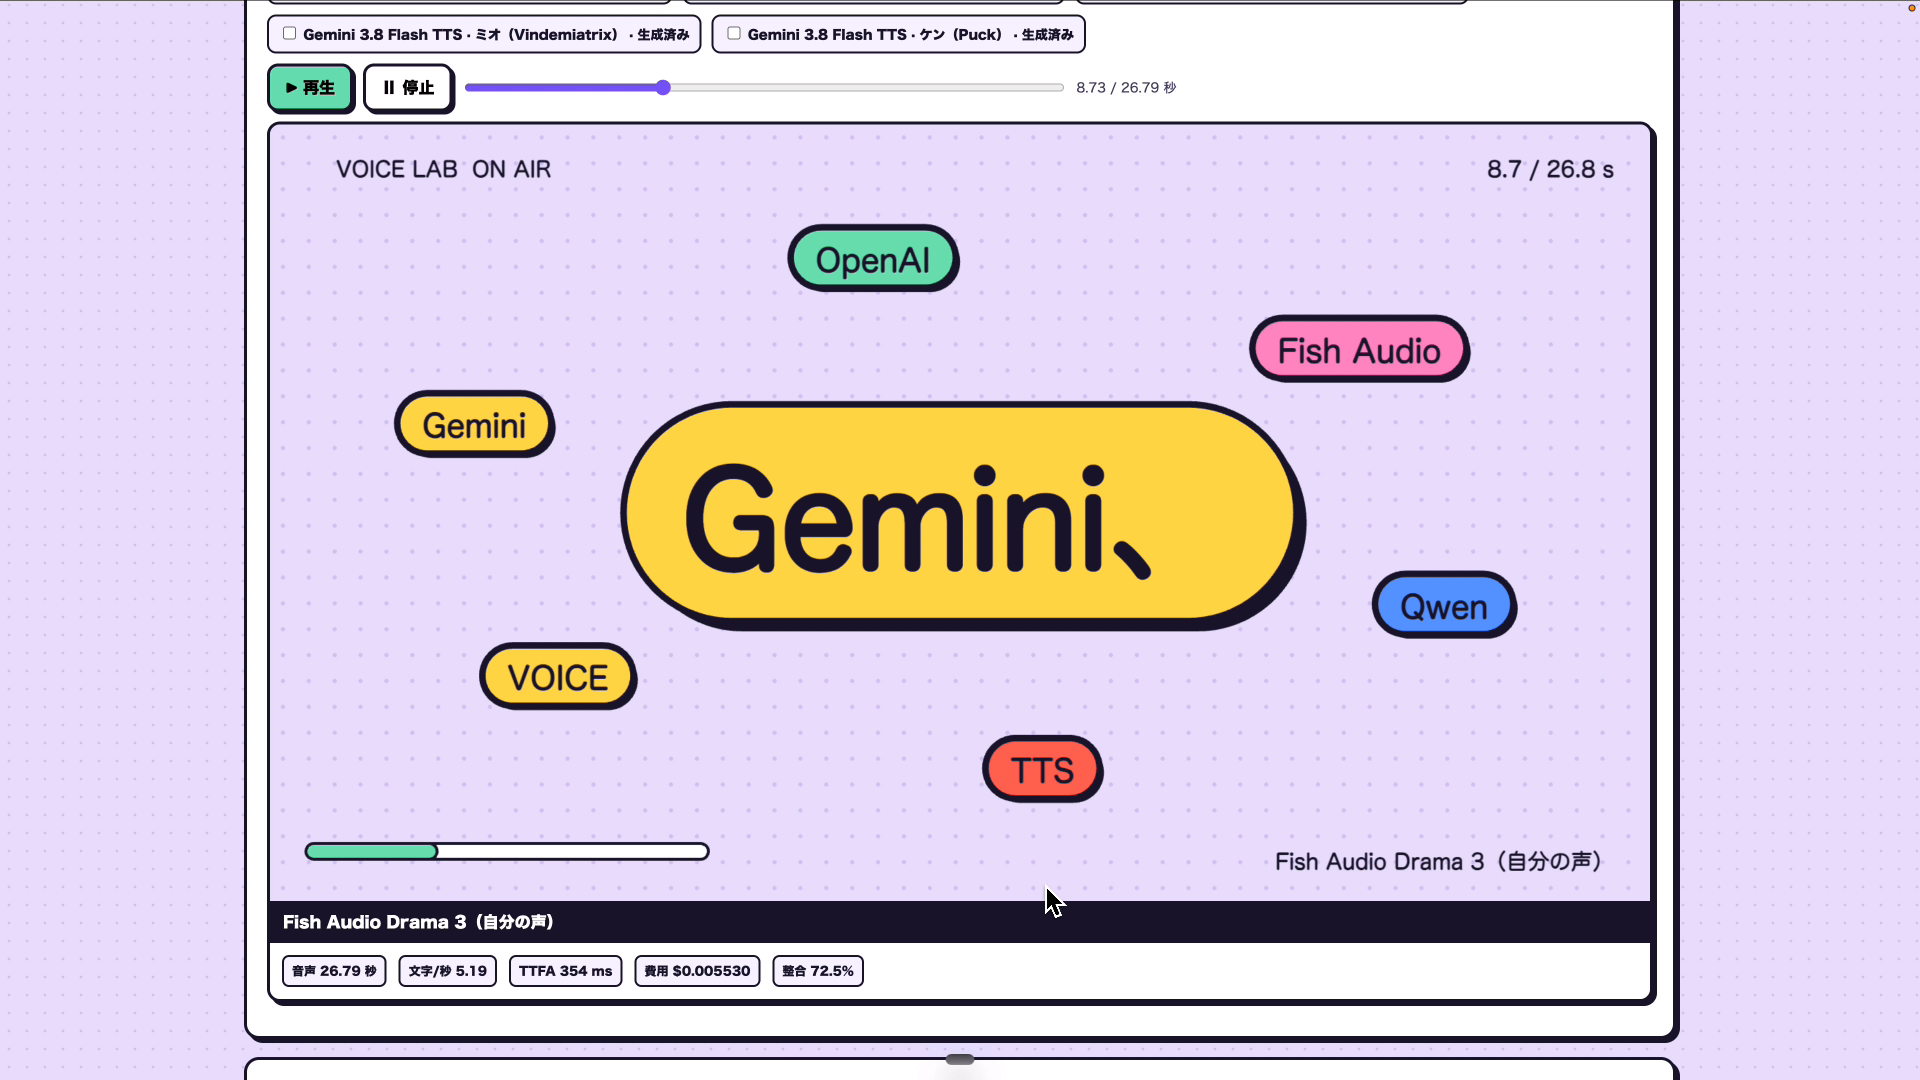
Fish Audioでは、自分の声のクローンを作ってDrama 3に読ませることもできます。オープニング用に作った同じ台本を、Voice Libraryの声と自分の声のクローンで読み比べてみました。
自分の声のクローンに、同じ台本を読ませてみました。
機械の判定だと、既製の声と同じ精度。自分の声で読まれるのは、正直ちょっと照れる。
解説動画のナレーションなら十分使えそう。他人の声は使わない前提で。
— せなお| AIとITを使った仕事術 (@rutinelabo) 投稿を見る
聞いてみると、ほぼ自分の声でコンテンツが作れるレベルでした。撮影前に6種類の台本で測っても、クローンの声はVoice Libraryの声と同じ精度で読んでいます(AIの書き起こしで判定)。解説資料のナレーションにも使えそうです。
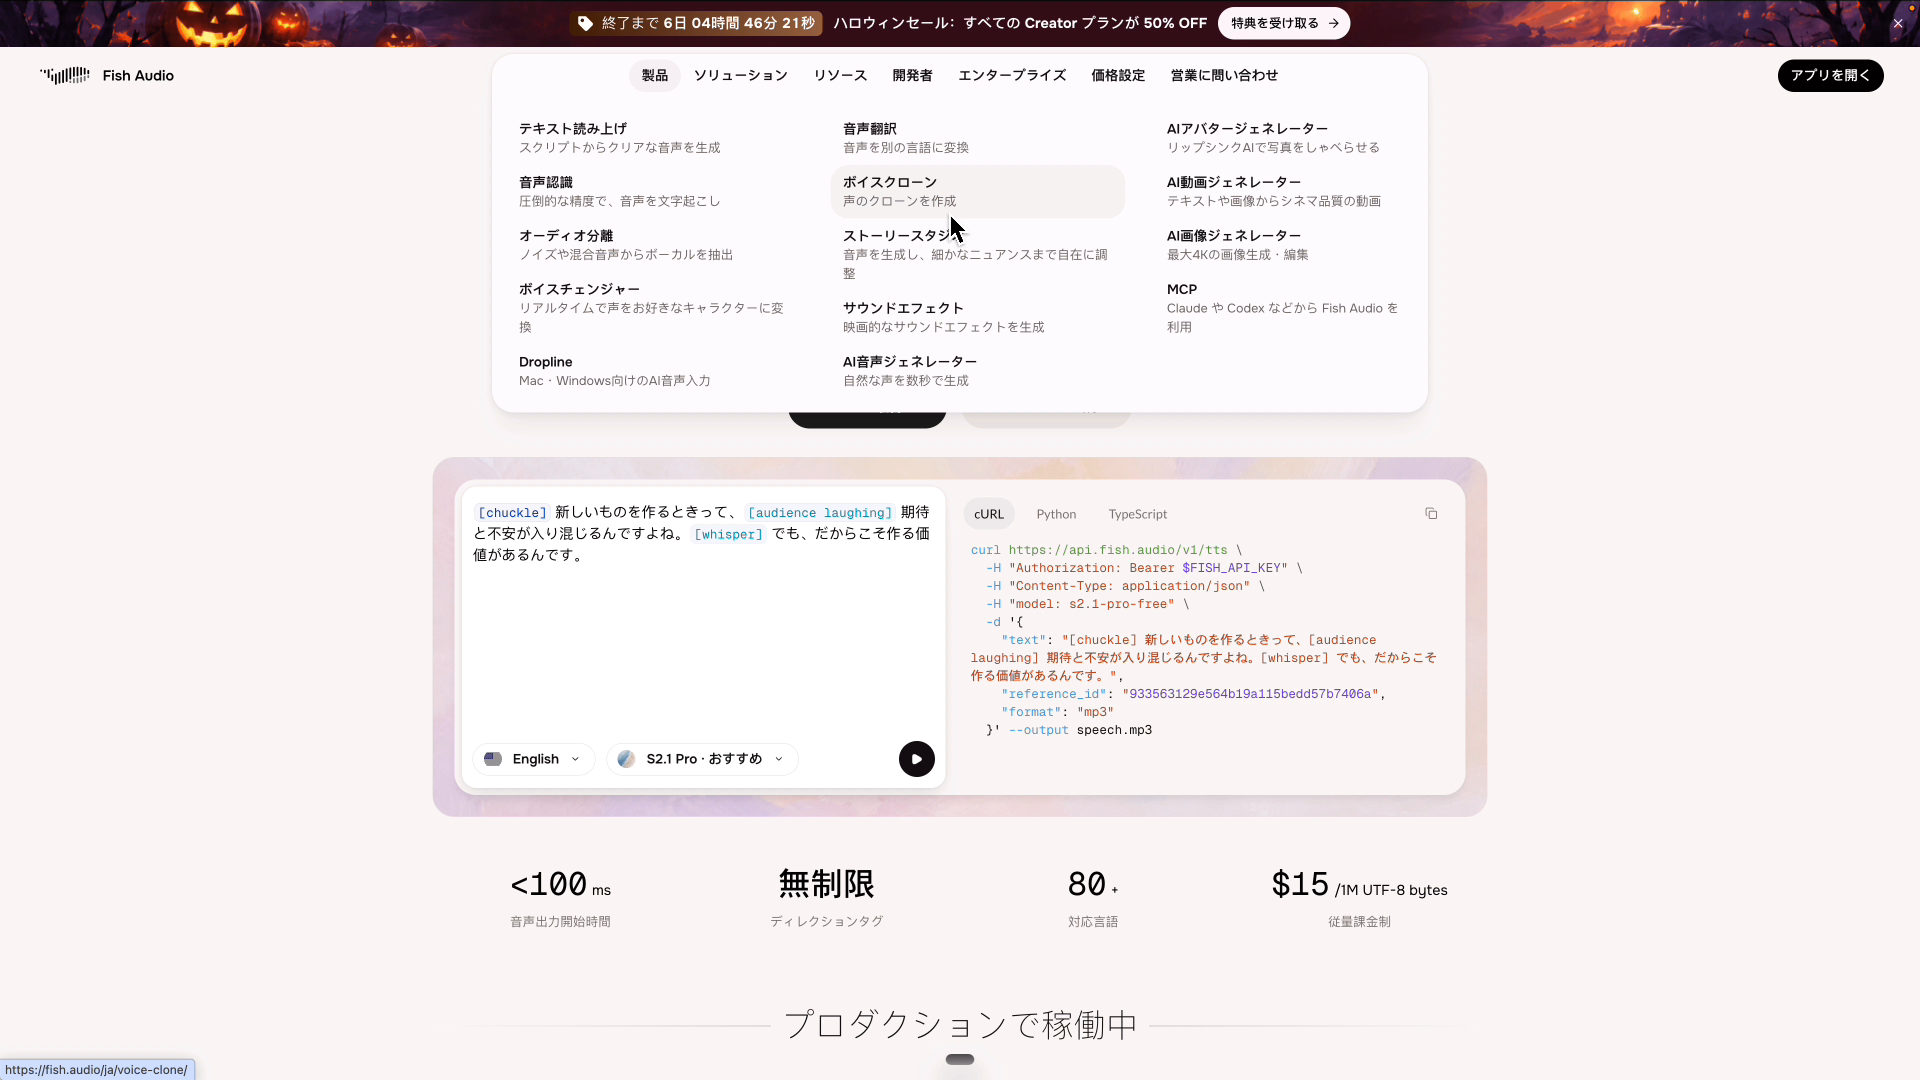
クローンは、公式サイトのメニューにあるボイスクローンから作れます。公式は10秒以上の録音をすすめていて、理想は15〜20秒のクリップを2〜3本です。録音したときの声のテンションや高さがそのまま出やすいので、少し明るめの声で録るなどの工夫が要ります。
クローンしてよい声
- 自分の声か、書面で許可をもらった人の声だけ
- ネット上の声や、有名人・公人の声は許可なく使わない
他人や有名人の声を無断でまねると、権利の侵害やトラブルにつながるおそれがあります。この記事で扱っているのも、自分の声と、各サービスに用意された声だけです。
Fish Audio Drama 3が向く仕事・向かない仕事|寸劇やゲームの掛け合いにおすすめ
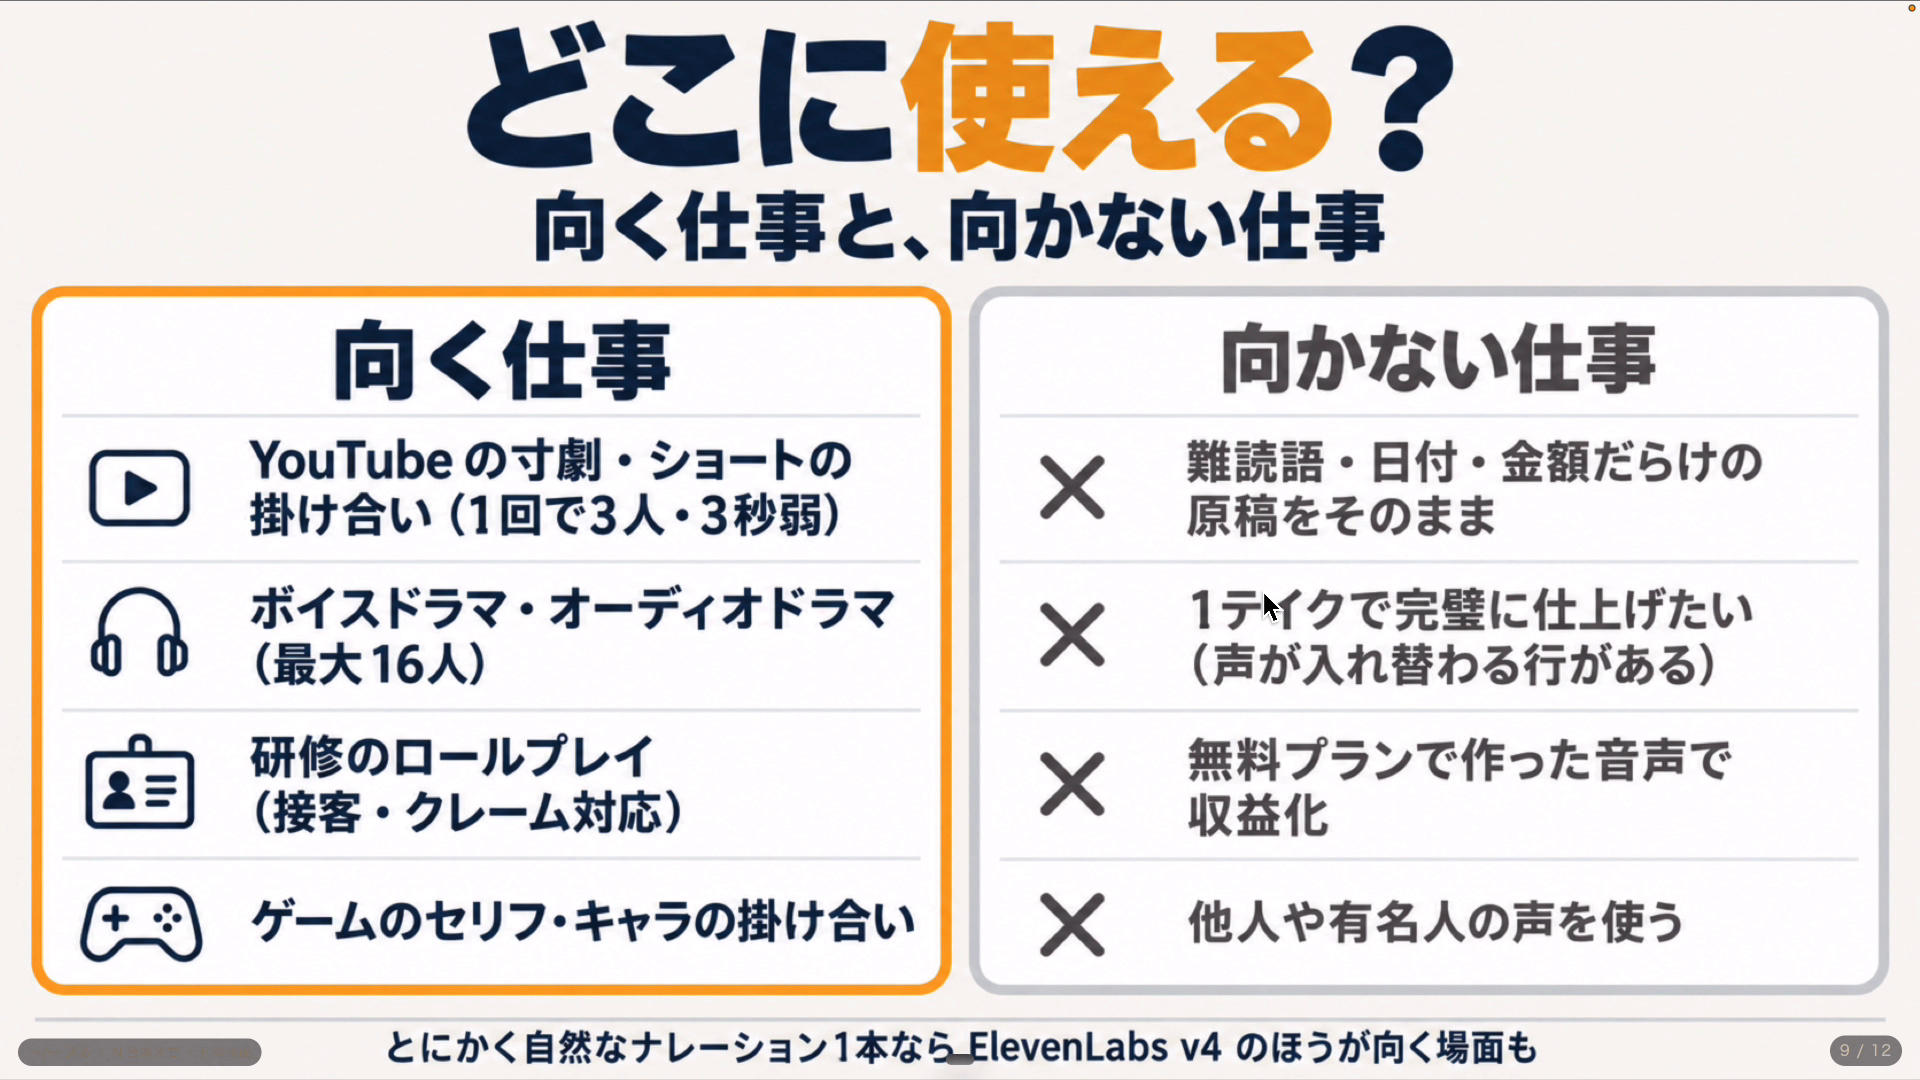
使ってみて、Drama 3がいちばん生きるのは、ショート動画や寸劇、アニメ調のコンテンツのように演技と掛け合いが要る場面だと感じました。ゲームのキャラの掛け合いや、研修や面接の練習アプリの相手役にも向いています。
| 向く仕事 | 向かない仕事 |
|---|---|
| YouTubeの寸劇・ショートの掛け合い | 固有名詞・日付・金額だらけの原稿 |
| ボイスドラマ・アニメ調のコンテンツ | GitHubやデプロイなど、英語の専門用語だらけの原稿 |
| ゲームのキャラのセリフ・ロールプレイ | 無料プランで作った音声を収益化する動画 |
| 研修や面接の練習アプリの相手役 | 他人や有名人の声を使うコンテンツ |
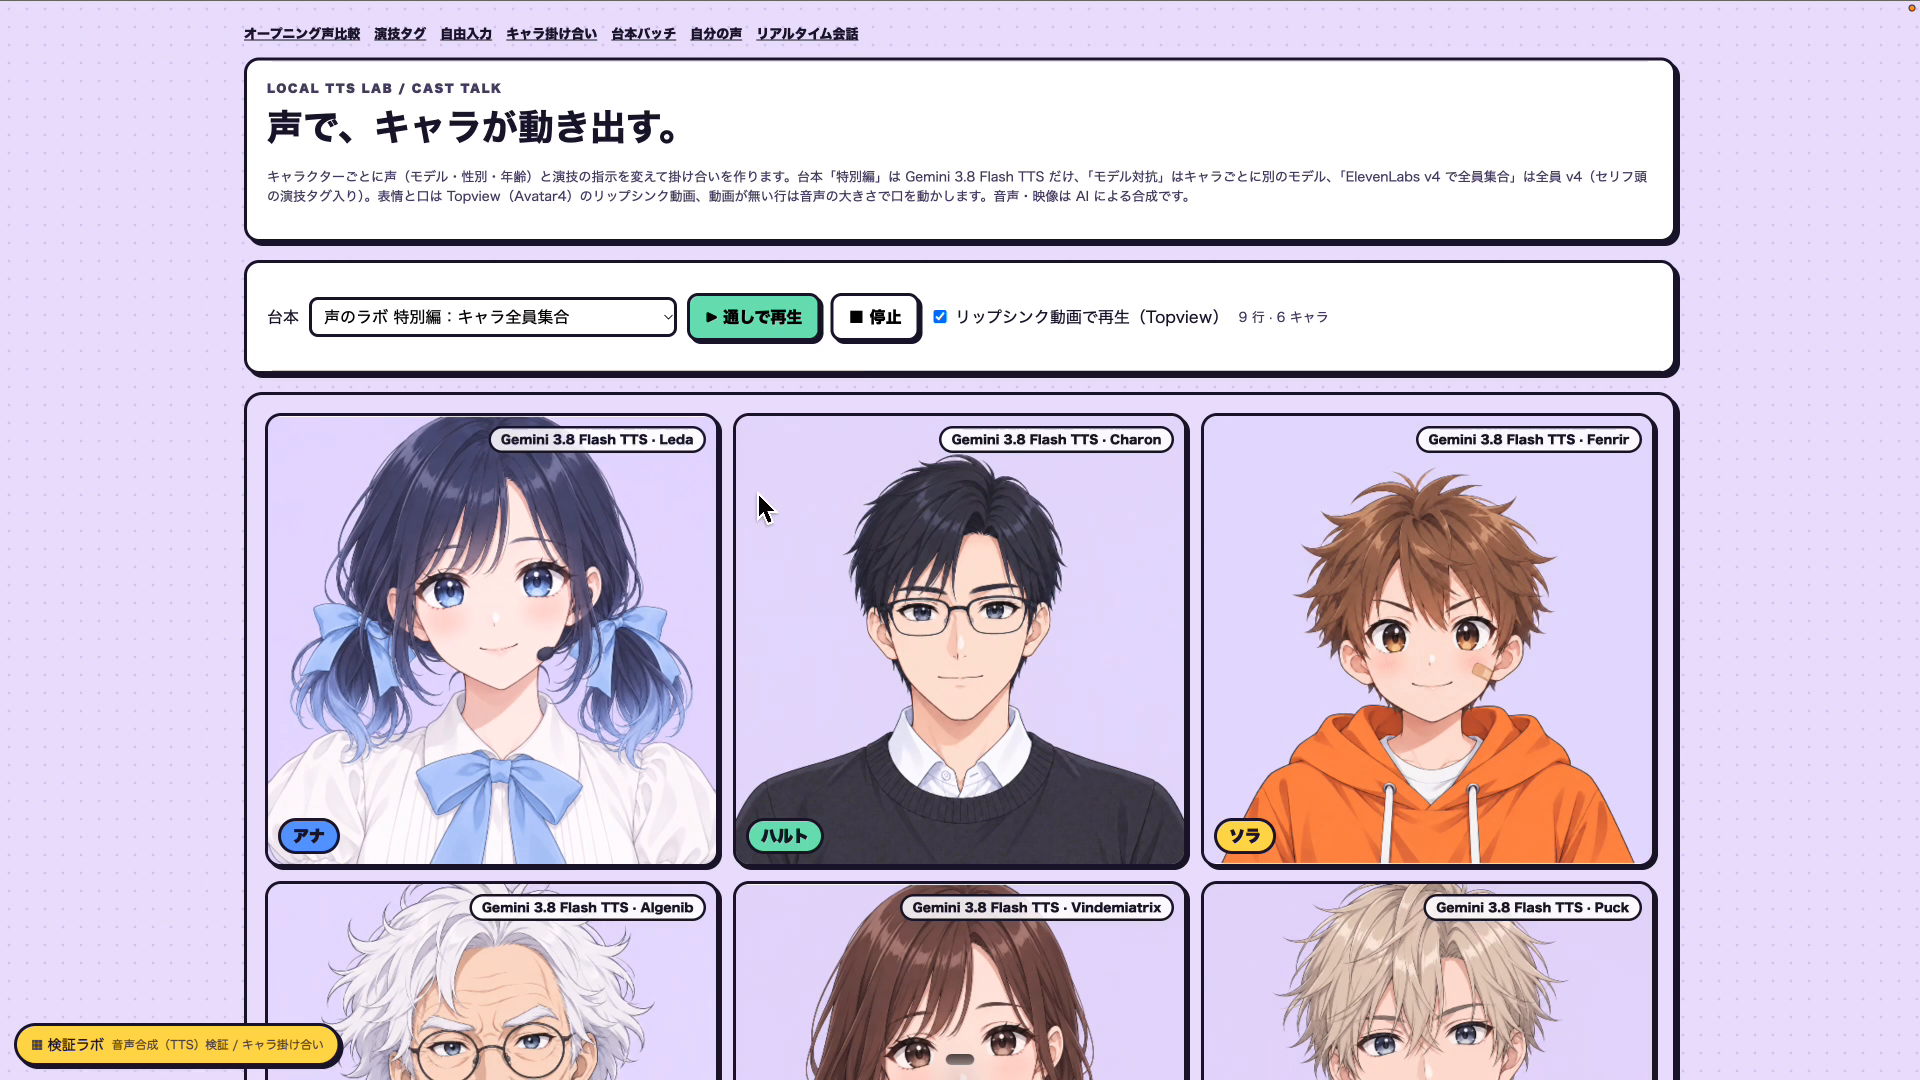
1回で最大16人の掛け合いは、僕もまだ試していません。動画で見せた6人のキャラの掛け合いは、Gemini 3.8 Flash TTSでセリフを1つずつ作ってつないだものです。Drama 3なら話者タグで分けた台本を1回送るだけで作れるので、次はここを試してみるつもりです。
僕が発信しているXのAIニュースのアバターの声も、今のGemini 3.8 Flash TTSとFish Audioで作り比べている最中です。
AIの声でショートドラマを作るなら、Anijamでどんでん返しのショートドラマを作った記事も参考になります。
-
-
Anijamの使い方|AIで「どんでん返し」ショートドラマを撮影0回で作る【MiniMax H3】
続きを見る
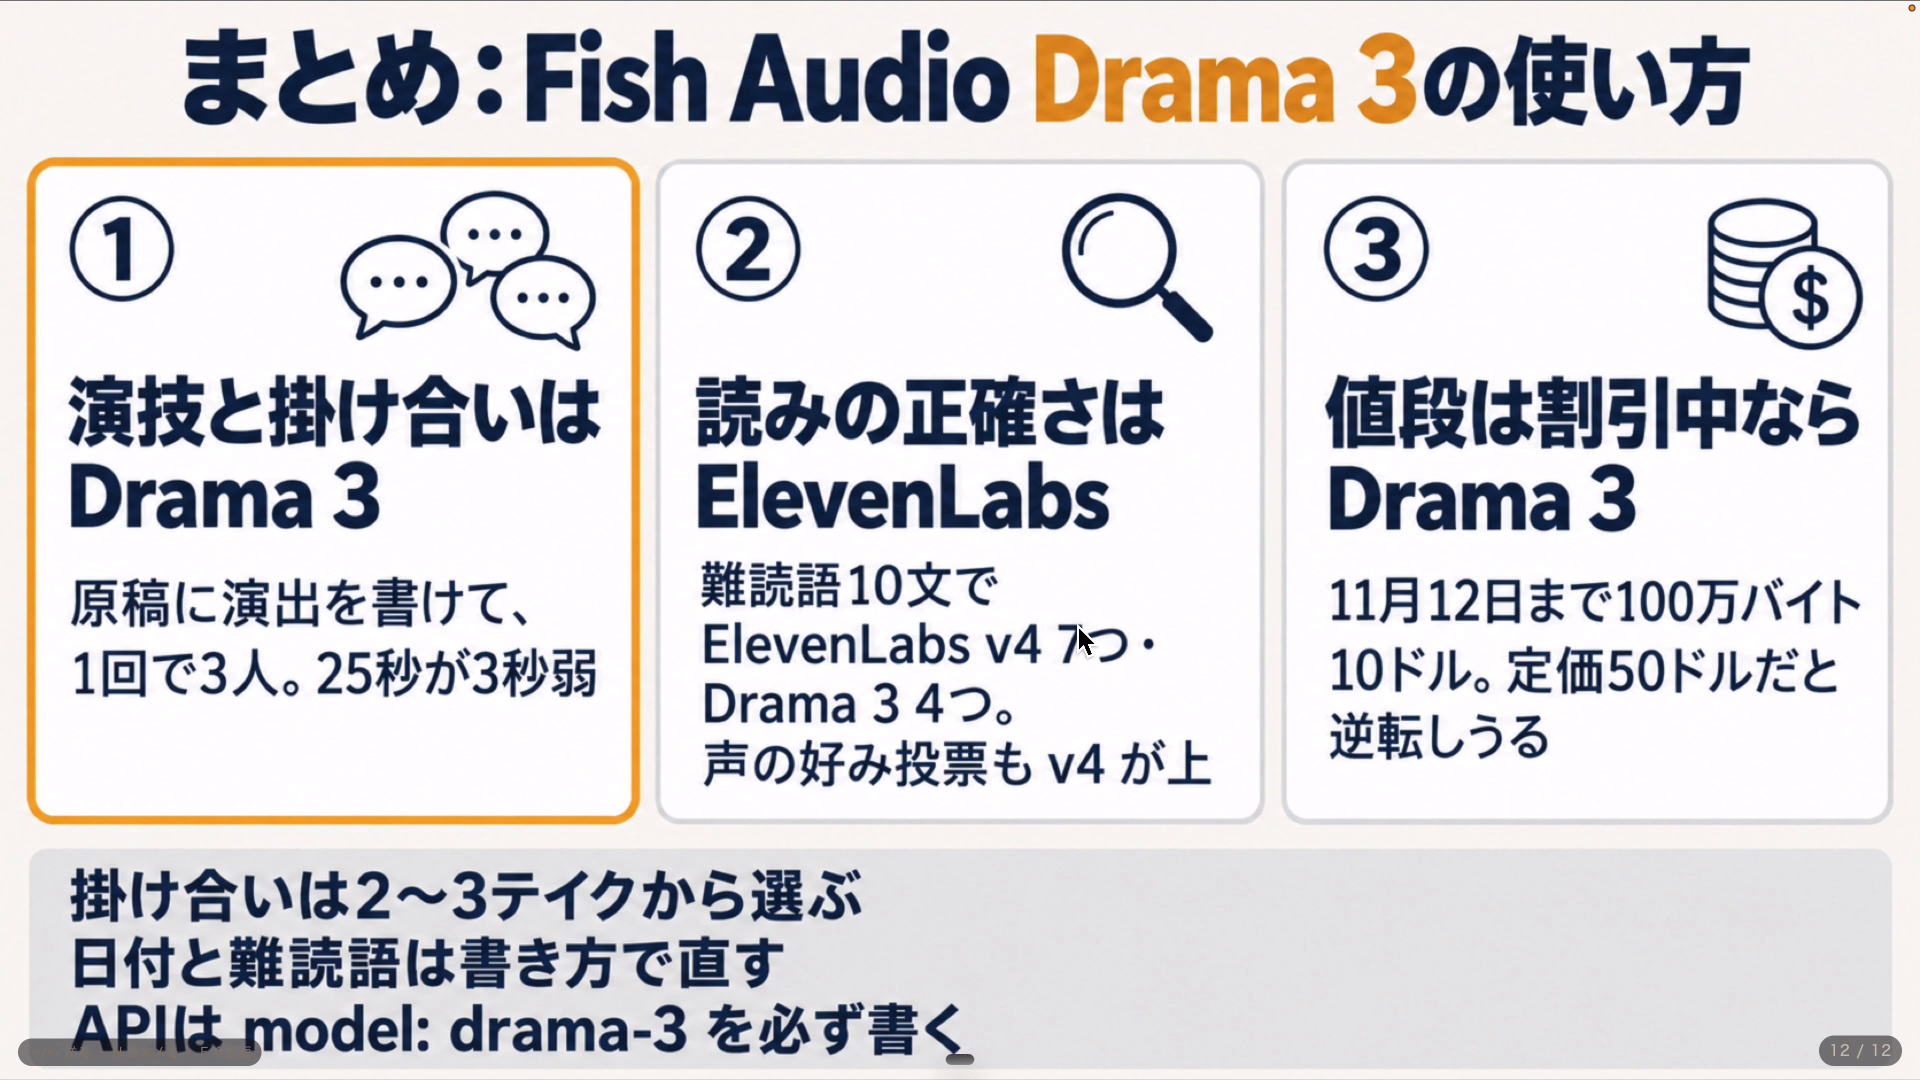
まとめ|演技と掛け合いはDrama 3、読みの正確さは書き方で補う
Fish Audio Drama 3を使ってみて分かったことをまとめます。
- 演技は台本の[ ]に日本語で書けば通じる。強い演技は1行に1つずつ
- 掛け合いは2〜3テイク作って、声が入れ替わっていない本を選ぶ
- 難読語はひらがな、日付は漢字に書き直してから生成する
- APIはmodel: drama-3を必ず書き、キーは.envで管理して上限も決める
- 自然なナレーション1本ならElevenLabs v4、演技と掛け合いならDrama 3と使い分ける
まずは無料プランで、記事の3人の台本の名前とセリフを入れ替えて、自分の寸劇を1本作ってみてください。台本に一言書き足すだけで声の演技が変わるのは、聞いてみるとかなり面白いです。
演技の指示の書き方・3人の掛け合いのテンプレ・読み間違いの直し方は、公式LINEで合言葉「ひとり芝居」と送ると受け取れます。
▶ YouTubeチャンネルで新しい音声AIの聞き比べを受け取る
▶ メンバーシップ(スタンダードAI ¥690/月)で毎回のプロンプト全文と質問部屋を受け取る
こちらの動画もおすすめ
-
-
リアルタイム音声AIを実機比較|GPT・Grok Voice・Geminiのどれが自然に喋るか
続きを見る

